CUDA Boids 群集模拟
基于朴素、散列均匀网格与连续均匀网格邻居搜索的 GPU 群集模拟
概述
本项目用 CUDA 实现了 Craig Reynolds 的 boids 群集模拟:每个粒子代表一个 boid,位置根据聚合(cohesion)、分离(separation)、对齐(alignment)三条规则更新。这是宾夕法尼亚大学 CIS 5650「GPU 编程与架构」课程的项目。
源代码见 GitHub。测试环境:Windows 11、AMD Ryzen 5950X @ 4.3GHz、64GB 内存、RTX 3090 24GB。
实现的三种方法
- 朴素 O(N^2) 邻居搜索:每个粒子遍历所有其他粒子。
- 散列均匀网格(scattered uniform grid):按所在网格单元对 boid 索引排序,找到每个单元的起止位置,再在最大规则距离内查找邻居。
- 连续均匀网格(coherent uniform grid):与散列方式相同,但先把位置和速度按单元顺序重排,这样邻居循环读取的是连续内存,而不是经过索引数组做随机访问。
- 三个速度核函数共用同一套规则计算(
accumulateNeighbor/finalizeVelocityChange),所以它们之间的耗时差异只来自邻居循环,而不是规则本身。 - 开关位于
src/main.cpp顶部:UNIFORM_GRID、COHERENT_GRID、VISUALIZE,另外还有我为下面的测量新增的PROFILE开关。
性能测量
我觉得只盯着 FPS 计数器并不是衡量性能的好办法,而且窗口标题里的 FPS 计数器本身也不准。在 50k 个 boid 时,连续网格的一步只需 0.25 ms 的 GPU 时间,但一次循环迭代却要 0.77 ms。多出来的半毫秒花在 GL 缓冲区操作、窗口标题更新和事件轮询上。
于是我在 main.cpp 里加了一个 PROFILE 宏:
- 在模拟步调用前后放一对
cudaEvent,每帧同步,得到的就是这一步本身的 GPU 时间。下文所有「step ms」都指这个值。 - 同时每帧记录整个循环迭代的墙钟时间。FPS = 1000 / 其平均值。这和标题栏的 fps 基本是同一个东西,只是对整次运行取了平均。
- 两组数据都写入预分配好的 vector,运行结束时导出为 CSV,因此记录本身的开销可以忽略。程序会运行固定步数(标签、N 和步数由命令行给出)然后自动退出。
PROFILE下调用glfwSwapInterval(0),这样我可以把 Nvidia 的垂直同步设置留在「由应用程序决定」,不用去切全局开关。(绝对不是因为我会忘记打游戏前把它开回来然后出现撕裂)
所有性能图表的统一设置:Release 构建,未特别说明时区块大小 128、单元宽度为最大规则距离的 2 倍,未特别说明时 VISUALIZE 0,每次运行 3000 步并丢弃前 200 步作为预热(朴素方法在 50K、100K、200K 下步数更少,否则跑完 3000 步要等到天荒地老)。初始位置采用确定性种子,因此在任何模式下第 k 步都是同一个世界。运行时其他程序都最小化了,因为我发现它们会吃掉大约 20% 的 GPU。
脚本与原始数据:profiling/run_sweep.ps1 执行一次扫描,profiling/analyze.py 生成表格和图表,profiling/raw/ 包含每帧的 CSV,profiling/summary.md 汇总了所有数字。
注:性能分析用的 PowerShell 和 Python 脚本是在 AI 的协助下编写的。
结果
Boid 数量(注意 Y 轴为对数刻度)
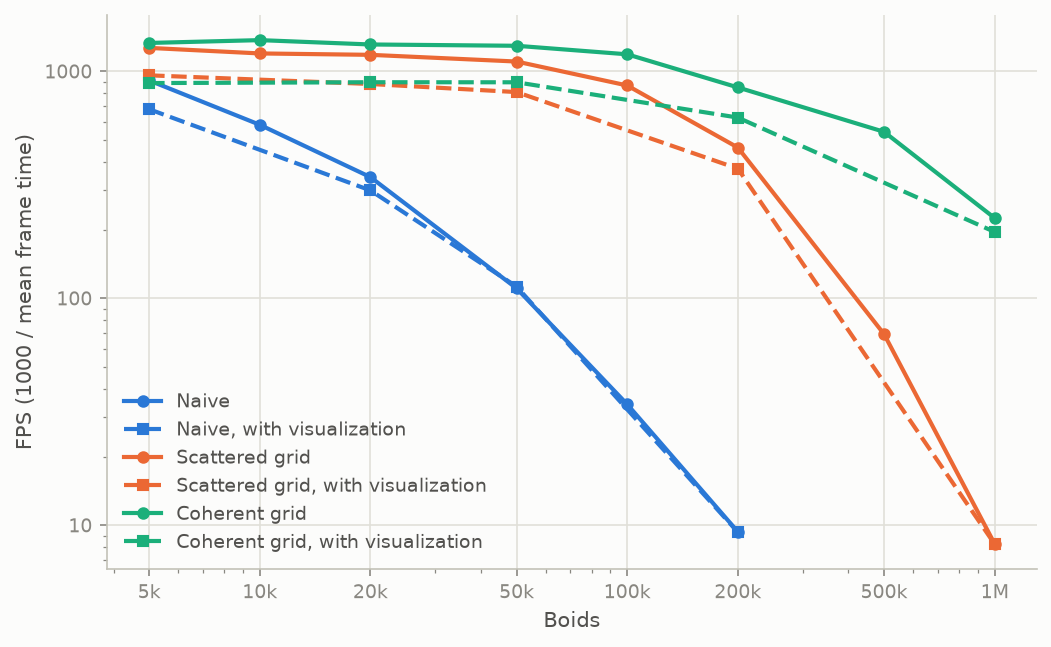
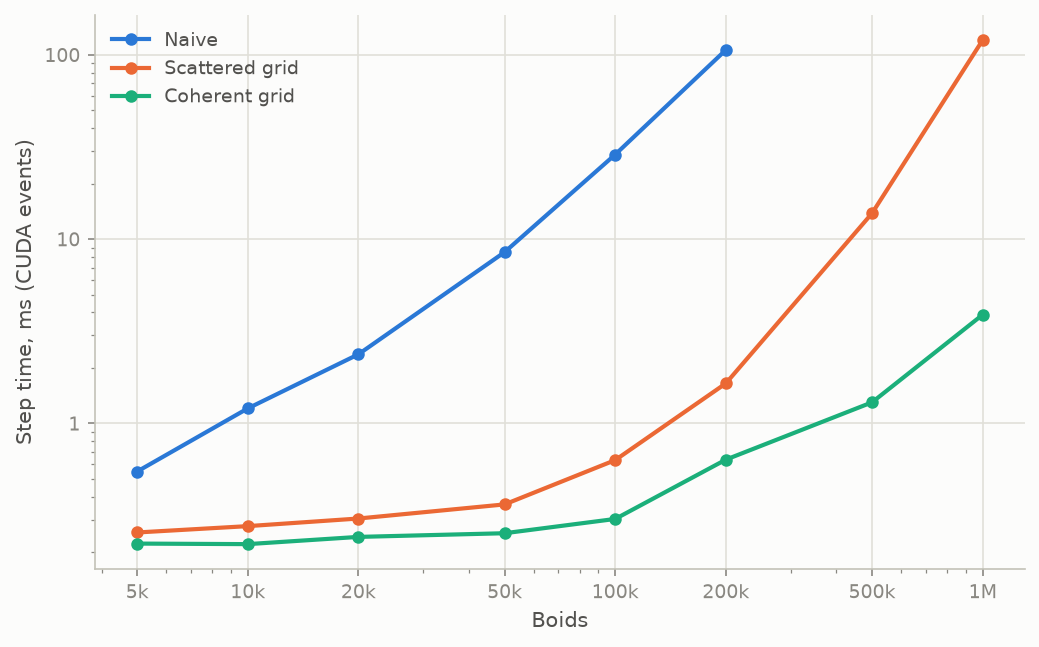
- 朴素方法在 GPU 被填满之后扩展性非常差。在 20k 以下增长比二次方慢,因为 5k 个 boid 只有 40 个 128 线程的区块,而 3090 有 82 个 SM,一半的 GPU 处于空闲。
- 两种网格模式在约 100k 之前基本持平。 我猜大约 0.3 ms 是核函数启动加 thrust 排序的固定开销,在这些规模下实际工作量比开销还小。
- 散列网格在 200K 之后急剧下滑:1.6 ms,然后 13.8,然后 120。连续网格在同一区间是 0.64、1.3、3.9。我认为这和我 GPU 的缓存大小有关,详见下文「连续 vs 散列」。
- 开启可视化完全不会(也不应该)改变单步时间,只是给每帧增加了绘制和交换。在 50k 时大约每帧多 0.3 ms,所以 FPS 从 1300 降到 900,而单步时间不变。
区块大小(注意 Y 轴为对数刻度)
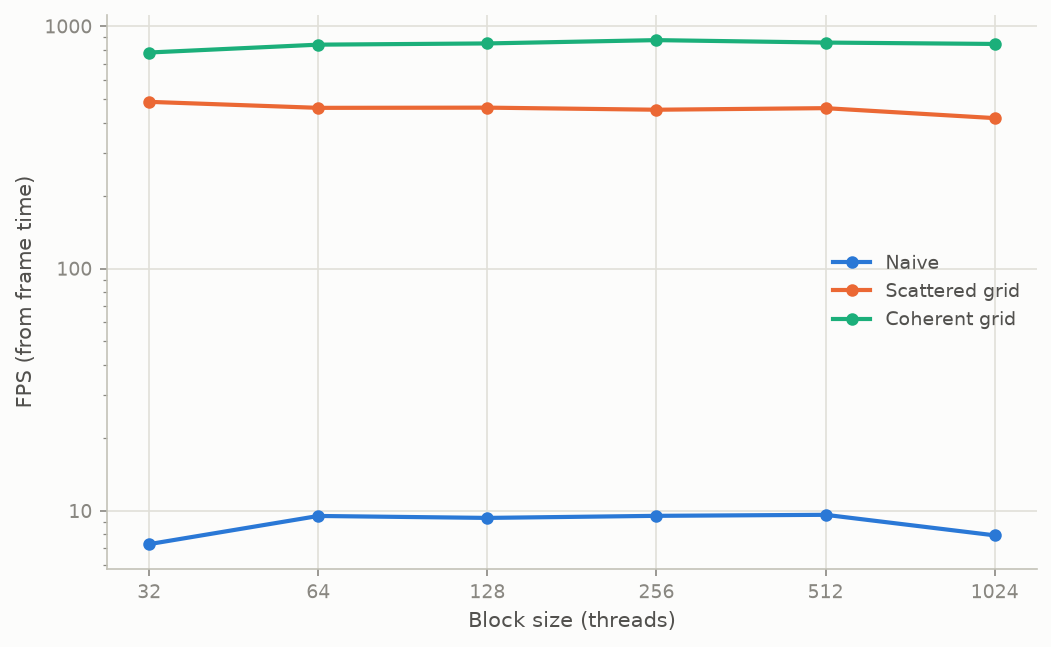
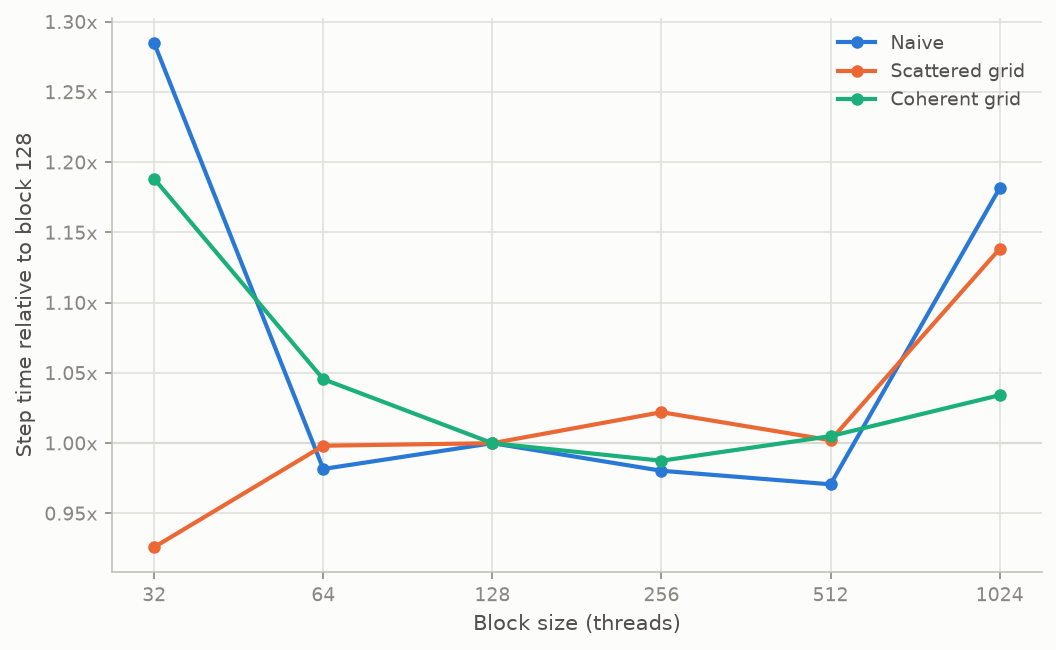
数据在 200k 个 boid、无可视化下采集。这里唯一变化的参数是区块大小。
只有散列方法在区块大小 32 时表现好,这看起来很奇怪,于是我用 cuobjdump --dump-resource-usage 检查并计算了占用率。3090 的一个 SM 最多驻留 16 个区块和 1536 个线程(48 个 warp),所以区块大小 128 看起来是合理的最佳配置。寄存器可能是第三个上限,但两个邻居搜索核函数每线程用 40 个寄存器,朴素方法用 35 个,都没有用共享内存。1536 x 40 = 61,440,在 65,536 的寄存器文件之内,因此寄存器不是瓶颈,占用率完全由区块大小决定。
| 区块大小 | 每 SM 驻留区块 | 驻留 warp | 占用率 | 连续 200k, ms | 连续 1M, ms | 散列 200k, ms | 散列 1M, ms |
|---|---|---|---|---|---|---|---|
| 32 | 16(区块上限) | 16 | 33% | 0.755 | 6.33 | 1.527 | 102.1 |
| 64 | 16(区块上限) | 32 | 67% | 0.665 | 4.18 | 1.646 | |
| 128 | 12(线程上限) | 48 | 100% | 0.636 | 3.89 | 1.649 | 120.2 |
| 256 | 6 | 48 | 100% | 0.628 | 3.87 | 1.685 | |
| 512 | 3 | 48 | 100% | 0.639 | 3.85 | 1.652 | |
| 1024 | 1 | 32 | 67% | 0.657 | 3.94 | 1.877 |
- 3090 每个 SM 允许 16 个驻留区块,所以 32 线程的区块把一个 SM 限制在 48 个 warp 中的 16 个,只有满占用的三分之一。这意味着能用来掩盖内存延迟的 warp 更少,性能数据也支持这一点——唯独散列方法例外。散列方法在 32 时反而最快。也许是因为散列方法受内存限制太严重,飞行中的 warp 更少反而缓解了缓存抖动,其收益超过了占用率的损失,不过这个结论没有经过验证。
- 区块大小 1024 时性能再次变差也说得通:它的占用率只有 2/3,而且大区块可能造成区块内部更不均衡,先完成的 warp 要等最慢的那个。
连续 vs 散列
- 在 50k 及以下没有明显差异。可能是因为 GPU 工作量太小,连续方法额外的重排核函数花的时间和它省下的差不多。
- 但随着 boid 数量上升,连续方法的性能优势明显扩大。这很可能是因为数量越大,数组越大,无法再舒适地放进缓存,于是大量随机的邻居读取都变成了 DRAM 访问。
- 简单算一下:3090 有 6 MB L2 缓存。在 50K 个 boid 时,例如
pos数组占 50K * 12 字节 = 0.6 MB,加上其他数组大概仍能放进 6 MB L2。但在 200k 时pos数组就要 200k * 12 字节 = 2.4 MB,再加上其他数组就装不进 6 MB 的 L2 了。
27 vs 8 个邻居单元(注意 Y 轴为对数刻度)
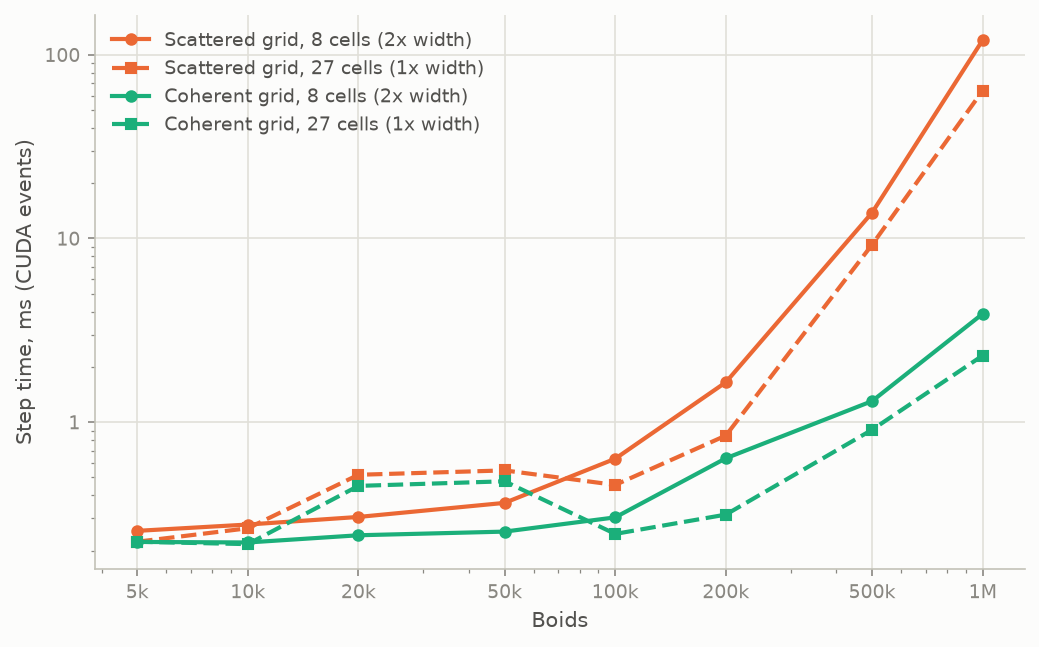
关于 27 单元与 8 单元的整体表现:
- 从 100K 个 boid 起,27 单元一直更快;在 20K 和 50K 时则更慢。
- 我仍然不清楚为什么它在 100K 和 200K 时比在 20K 和 50K 时表现更好。我用 nvidia-smi 检查了运行期间的 GPU 时钟频率,本以为低 boid 数量不会让 GPU 升到高频,但各个数量下的时钟频率几乎一样。
- 27 单元方法确实要付出更多的起止查找。但它也减少了无效查找,因为检查的区域更小。设想一个 boid 检查邻居:有个邻居在 8 单元搜索区域内,但实际上在最大规则半径之外。这类邻居被查到了,最后又被丢弃。用 27 单元时,由于搜索范围更紧,这种情况会更少发生。这也解释了为什么 boid 数量越多 27 单元赢得越多:boid 越密集,更紧的边界省下的邻居查找就越多。
性能尖峰
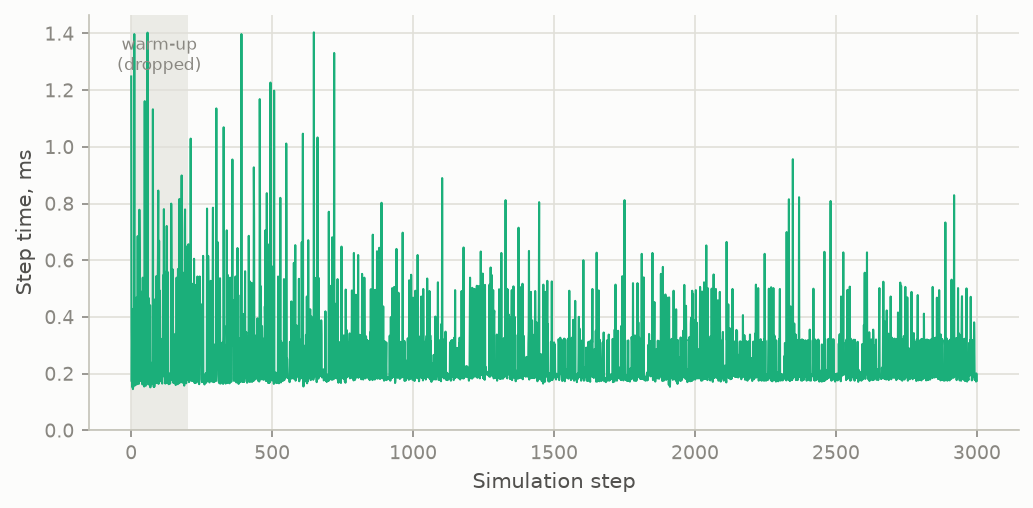
由于每一帧都有记录,我可以查看分布,发现两种网格方法都存在性能尖峰。原因我还没有深究。
备注
main.cpp 中 PROFILE 默认为 0,即正常的交互式构建,不会编译任何性能分析代码。把它设为 1 即可复现测量:可执行文件从命令行接收 label N steps,运行指定步数,写出 label.csv 后退出。
工具
CUDA, C++, OpenGL, GLFW, Thrust, CMake