CUDA Boids 群れシミュレーション
ナイーブ・散在型・連続型ユニフォームグリッド近傍探索による GPU 群れシミュレーション
概要
Craig Reynolds の boids 群れシミュレーションを CUDA で実装したプロジェクト。各パーティクルが 1 体の boid を表し、結合(cohesion)・分離(separation)・整列(alignment)の 3 つのルールに基づいて位置を更新する。ペンシルベニア大学 CIS 5650「GPU Programming and Architecture」の課題として制作。
ソースコードは GitHub にて公開。テスト環境:Windows 11、AMD Ryzen 5950X @ 4.3GHz、64GB RAM、RTX 3090 24GB。
実装した 3 つのアプローチ
- ナイーブな O(N^2) 近傍探索。各パーティクルが他のすべてのパーティクルを走査する。
- 散在型ユニフォームグリッド(scattered uniform grid)。boid のインデックスをセル順にソートし、各セルの開始・終了位置を求め、最大ルール距離内の近傍 boid を探索する。
- 連続型ユニフォームグリッド(coherent uniform grid)。散在型と同じだが、先に位置と速度をセル順に並べ替えておくことで、近傍ループがインデックス配列経由のランダムアクセスではなく連続メモリを読むようにしたもの。
- 3 つの速度カーネルはルール計算(
accumulateNeighbor/finalizeVelocityChange)を共有しているので、カーネル間の時間差はルールではなく近傍ループの差そのものになる。 - 切り替えスイッチは
src/main.cppの先頭にある:UNIFORM_GRID、COHERENT_GRID、VISUALIZE、そして以下の計測のために追加したPROFILE。
パフォーマンス計測
FPS カウンターを眺めるだけでは性能を測るには不十分だと思ったし、ウィンドウタイトルの FPS カウンターは実際のところ不正確な指標だった。boid 50k のとき、連続型のステップは GPU 時間で 0.25 ms しかかからないが、ループ 1 回分は 0.77 ms かかる。残りの半ミリ秒は GL バッファ周りの処理、ウィンドウタイトルの更新、イベントポーリングだ。
そこで main.cpp に PROFILE マクロを追加した:
- シミュレーションステップ呼び出しの前後に
cudaEventのペアを置き、毎フレーム同期することで、ステップだけの GPU 時間を得る。以下で「step ms」と書いているのはすべてこれ。 - ループ 1 回分の実時間(wall-clock)もフレームごとに記録する。FPS = 1000 / その平均値。タイトルバーの fps とほぼ同じものだが、実行全体で平均している。
- 両方とも事前確保した vector に入れ、実行終了時に CSV として書き出すので、記録のコストは実行中ほぼ無視できる。プログラムは固定ステップ数(ラベル、N、ステップ数はコマンドラインから指定)を実行して自動終了する。
PROFILE時はglfwSwapInterval(0)を呼ぶので、Nvidia の垂直同期設定を「アプリケーションに従う」のままにしておけて、グローバル設定を切り替える必要がない。(ゲームの前に戻し忘れてティアリングに悩まされるから、というのは絶対に理由ではない)
すべてのパフォーマンスグラフの共通設定:Release ビルド、特記なき限りブロックサイズ 128・セル幅は最大ルール距離の 2 倍、特記なき限り VISUALIZE 0、1 回の実行につき 3000 ステップで最初の 200 ステップはウォームアップとして破棄(ナイーブ法の 50K・100K・200K は 3000 ステップ回すと 10 年かかるのでステップ数を減らした)。初期位置は決定的なシードで生成しているので、どのモードでもステップ k は同じ世界になる。実行中は他のプログラムを最小化した。GPU の 20% ほどを食っていることに気づいたからだ。
スクリプトと生データ:profiling/run_sweep.ps1 がスイープを実行し、profiling/analyze.py が表とグラフを作成、profiling/raw/ にフレームごとの CSV、profiling/summary.md にすべての数値がある。
注:プロファイリング用の PowerShell と Python スクリプトは AI の助けを借りて作成した。
結果
boid 数(Y 軸は対数スケール)
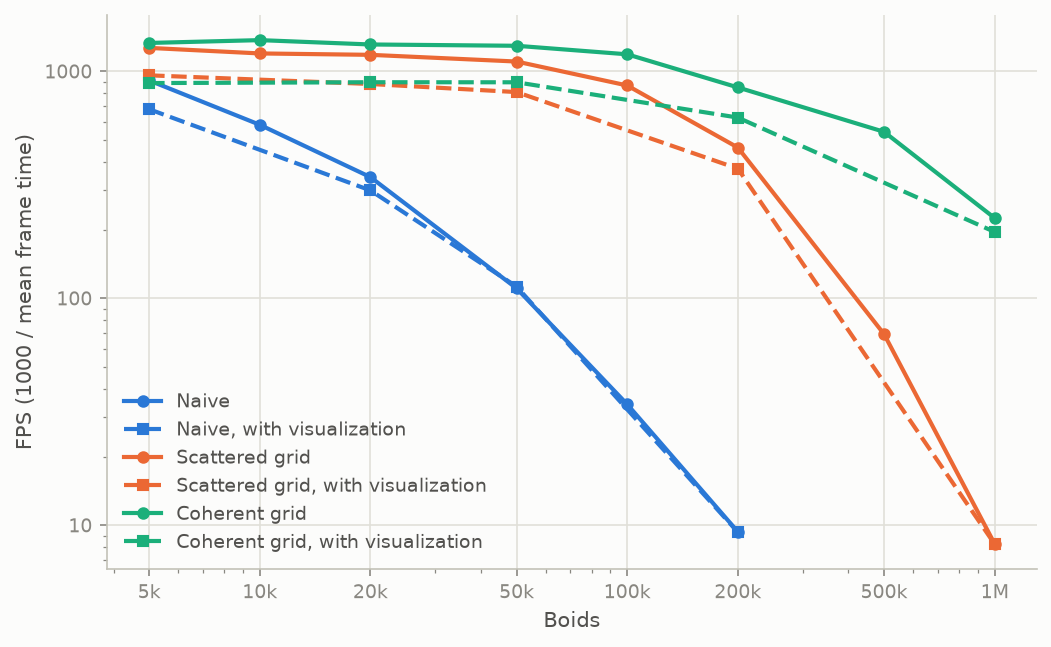
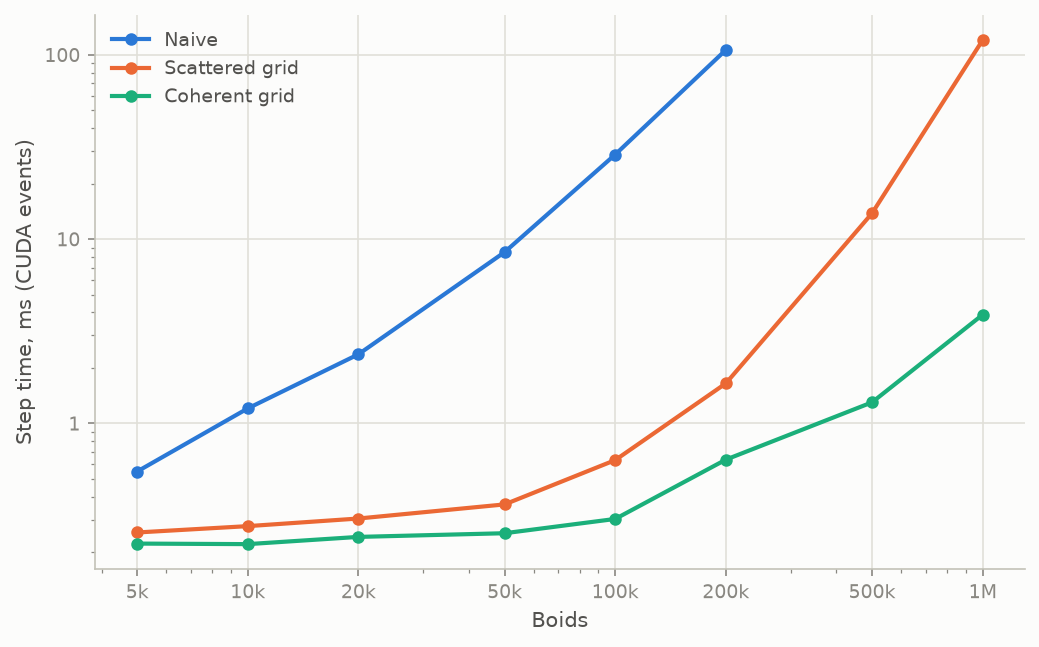
- ナイーブ法は GPU が埋まった後のスケーリングが非常に悪い。20k 未満では二次関数より緩やかに増えるが、これは 5k 体の boid が 128 スレッドのブロック 40 個分にしかならず、3090 には 82 個の SM があるので GPU の半分が遊んでいるため。
- グリッド方式はどちらも約 100k までほぼ横ばい。 カーネル起動と thrust ソートで 0.3 ms 程度の固定コストがかかり、このサイズでは実際の処理がそのオーバーヘッドより小さいのだと思う。
- 散在型は 200K を超えると急激に落ちる:1.6 ms、次に 13.8、そして 120。連続型は同じ範囲で 0.64、1.3、3.9。これは GPU のキャッシュサイズに関係していると考えている。詳細は後述の「連続型 vs 散在型」を参照。
- 可視化オンはステップ時間をまったく変えない(変えるべきでもない)。各フレームに描画とスワップが加わるだけだ。50k では 1 フレームあたり約 0.3 ms で、ステップ時間は同じまま FPS が 1300 から 900 に落ちるのはそのため。
ブロックサイズ(Y 軸は対数スケール)
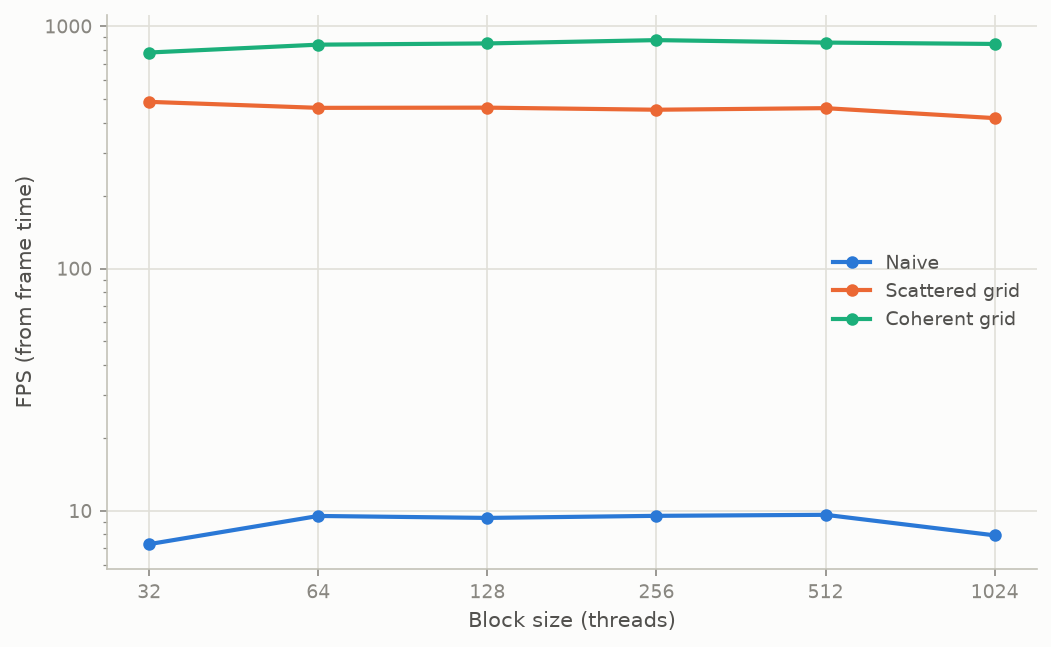
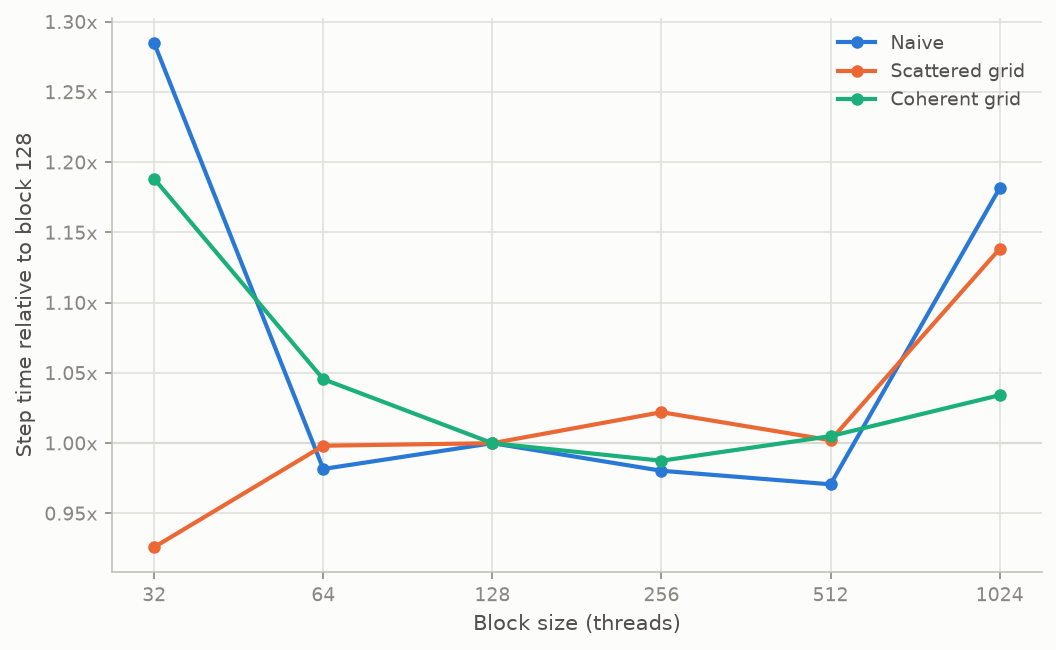
データは boid 200k、可視化なしで収集。ここで変えているパラメータはブロックサイズだけ。
散在型だけがブロックサイズ 32 で好成績なのは奇妙に思えたので、cuobjdump --dump-resource-usage で確認し、占有率(occupancy)を計算した。3090 の SM は最大 16 個の常駐ブロックと 1536 スレッド(48 warp)を保持できるので、ブロックサイズ 128 が妥当な最良構成に見えた。レジスタが第 3 の上限になり得るが、2 つの近傍探索カーネルはスレッドあたり 40 レジスタ、ナイーブ法は 35 で、どれも共有メモリを使っていない。1536 x 40 = 61,440 は 65,536 のレジスタファイルに収まるので、レジスタは問題ではなく、占有率はブロックサイズだけで決まる。
| ブロックサイズ | SM あたり常駐ブロック | 常駐 warp | 占有率 | 連続型 200k, ms | 連続型 1M, ms | 散在型 200k, ms | 散在型 1M, ms |
|---|---|---|---|---|---|---|---|
| 32 | 16(ブロック上限) | 16 | 33% | 0.755 | 6.33 | 1.527 | 102.1 |
| 64 | 16(ブロック上限) | 32 | 67% | 0.665 | 4.18 | 1.646 | |
| 128 | 12(スレッド上限) | 48 | 100% | 0.636 | 3.89 | 1.649 | 120.2 |
| 256 | 6 | 48 | 100% | 0.628 | 3.87 | 1.685 | |
| 512 | 3 | 48 | 100% | 0.639 | 3.85 | 1.652 | |
| 1024 | 1 | 32 | 67% | 0.657 | 3.94 | 1.877 |
- 3090 は SM あたり 16 個の常駐ブロックを許すので、32 スレッドのブロックでは SM が 48 warp 中 16 warp に制限され、フル占有の 3 分の 1 にしかならない。つまりメモリレイテンシを隠すための warp が少なくなるということで、性能データもそれを裏付けている——散在型を除いて。散在型では 32 が最速のブロックサイズだった。おそらく散在型はメモリ律速があまりに強いので、飛行中の warp が少ないほうがキャッシュスラッシングが緩和され、それが占有率の損失を上回るのだと思うが、検証済みの結論ではない。
- ブロックサイズ 1024 で再び性能が落ちるのも納得できる。占有率が 2/3 しかなく、大きなブロックはブロック内の不均衡を増やして、先に終わった warp が最も遅い warp を待つことになるからだ。
連続型 vs 散在型
- 50k 以下では有意な差はない。GPU の仕事があまりに少なく、連続型の追加シャッフルカーネルのコストが、それによって節約される分とほぼ同じだからだろう。
- しかし boid 数が増えるにつれ、連続型の性能向上がはるかに顕著になる。boid 数が多いほど配列が大きくなってキャッシュに収まりきらなくなり、ランダムな近傍読み取りの多くが DRAM アクセスになるためだと考えられる。
- 少し計算してみる:3090 の L2 キャッシュは 6 MB。boid 50K では例えば
pos配列が 50K * 12 バイト = 0.6 MB で、他の配列を合わせてもおそらく 6 MB の L2 に収まる。しかし 200k ではpos配列だけで 200k * 12 バイト = 2.4 MB になり、他の配列を合わせると 6 MB の L2 にはもう収まらない。
27 セル vs 8 セルの近傍探索(Y 軸は対数スケール)
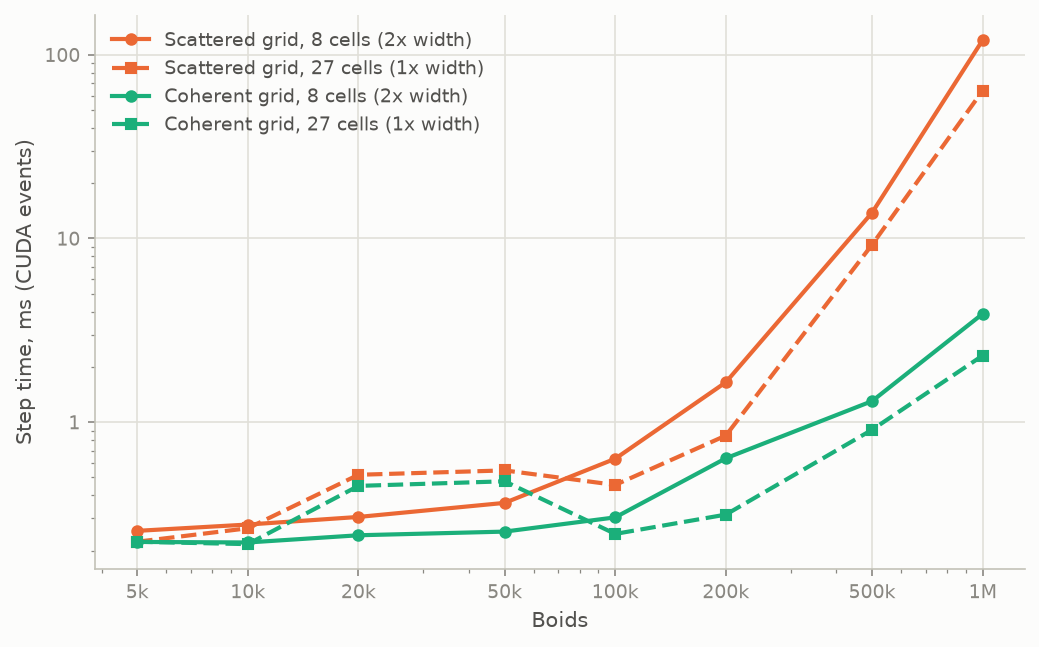
27 セルと 8 セルの全体的な性能について:
- 27 セルは boid 100K 以上で一貫して優れ、20K と 50K では劣った。
- なぜ 20K・50K より 100K・200K のほうが良くなるのかはまだわからない。boid 数が少ないと GPU のクロックが上がりきらないのかと思い nvidia-smi で実行中のクロック周波数を確認したが、どの boid 数でもクロックはほぼ同じだった。
- 27 セル方式が開始・終了位置の参照を多く払うのは確かだ。しかし探索領域が狭いぶん、無駄な参照も減る。ある boid が近傍を調べる場面を考えると、8 セルの探索領域内にはいるが実際には最大ルール半径の外にいる近傍が存在する。こうした近傍は参照されたあげく最後に捨てられる。27 セルではより狭い範囲を探索するので、この種の参照が起こる頻度が下がる。boid 数が多いほど 27 セル方式の勝ち幅が大きくなるのはこれで説明できる:boid が密になるほど、狭い境界が節約する近傍参照が増えるからだ。
パフォーマンススパイク
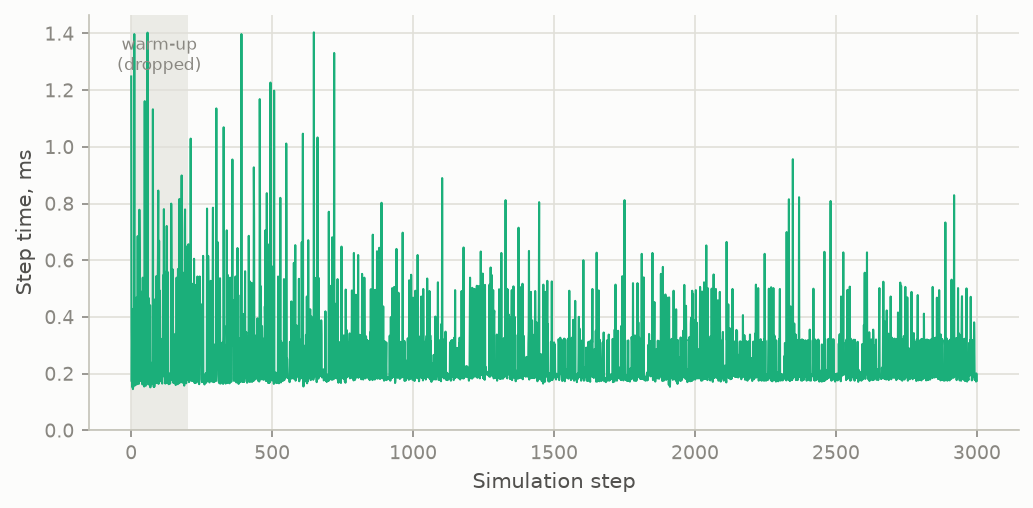
全フレームを記録しているので分布を見ることができ、グリッド方式の両方でパフォーマンススパイクが確認できた。原因はまだ調べていない。
補足
main.cpp の PROFILE はデフォルトで 0 で、これはプロファイリングコードを一切コンパイルしない通常のインタラクティブビルドになる。1 にすると計測を再現できる:実行ファイルはコマンドラインから label N steps を受け取り、そのステップ数だけ実行して label.csv を書き出し終了する。
使用ツール
CUDA, C++, OpenGL, GLFW, Thrust, CMake