CUDA 硬件光追路径追踪器
波前式 GPU 渲染器,支持 NEE + MIS、灯光链接与基于物理的相机
概述
这是一个基于 CUDA 和 OptiX 硬件光线追踪的波前(wavefront)路径追踪器,是宾夕法尼亚大学 CIS 5650「GPU 编程与架构」课程的项目(Project 3)。
源代码见 GitHub。测试环境:Windows 11、AMD Ryzen 5950X @ 4.3GHz(开启 PBO)、64GB 内存(3200 MT/s)、RTX 3090 24GB。
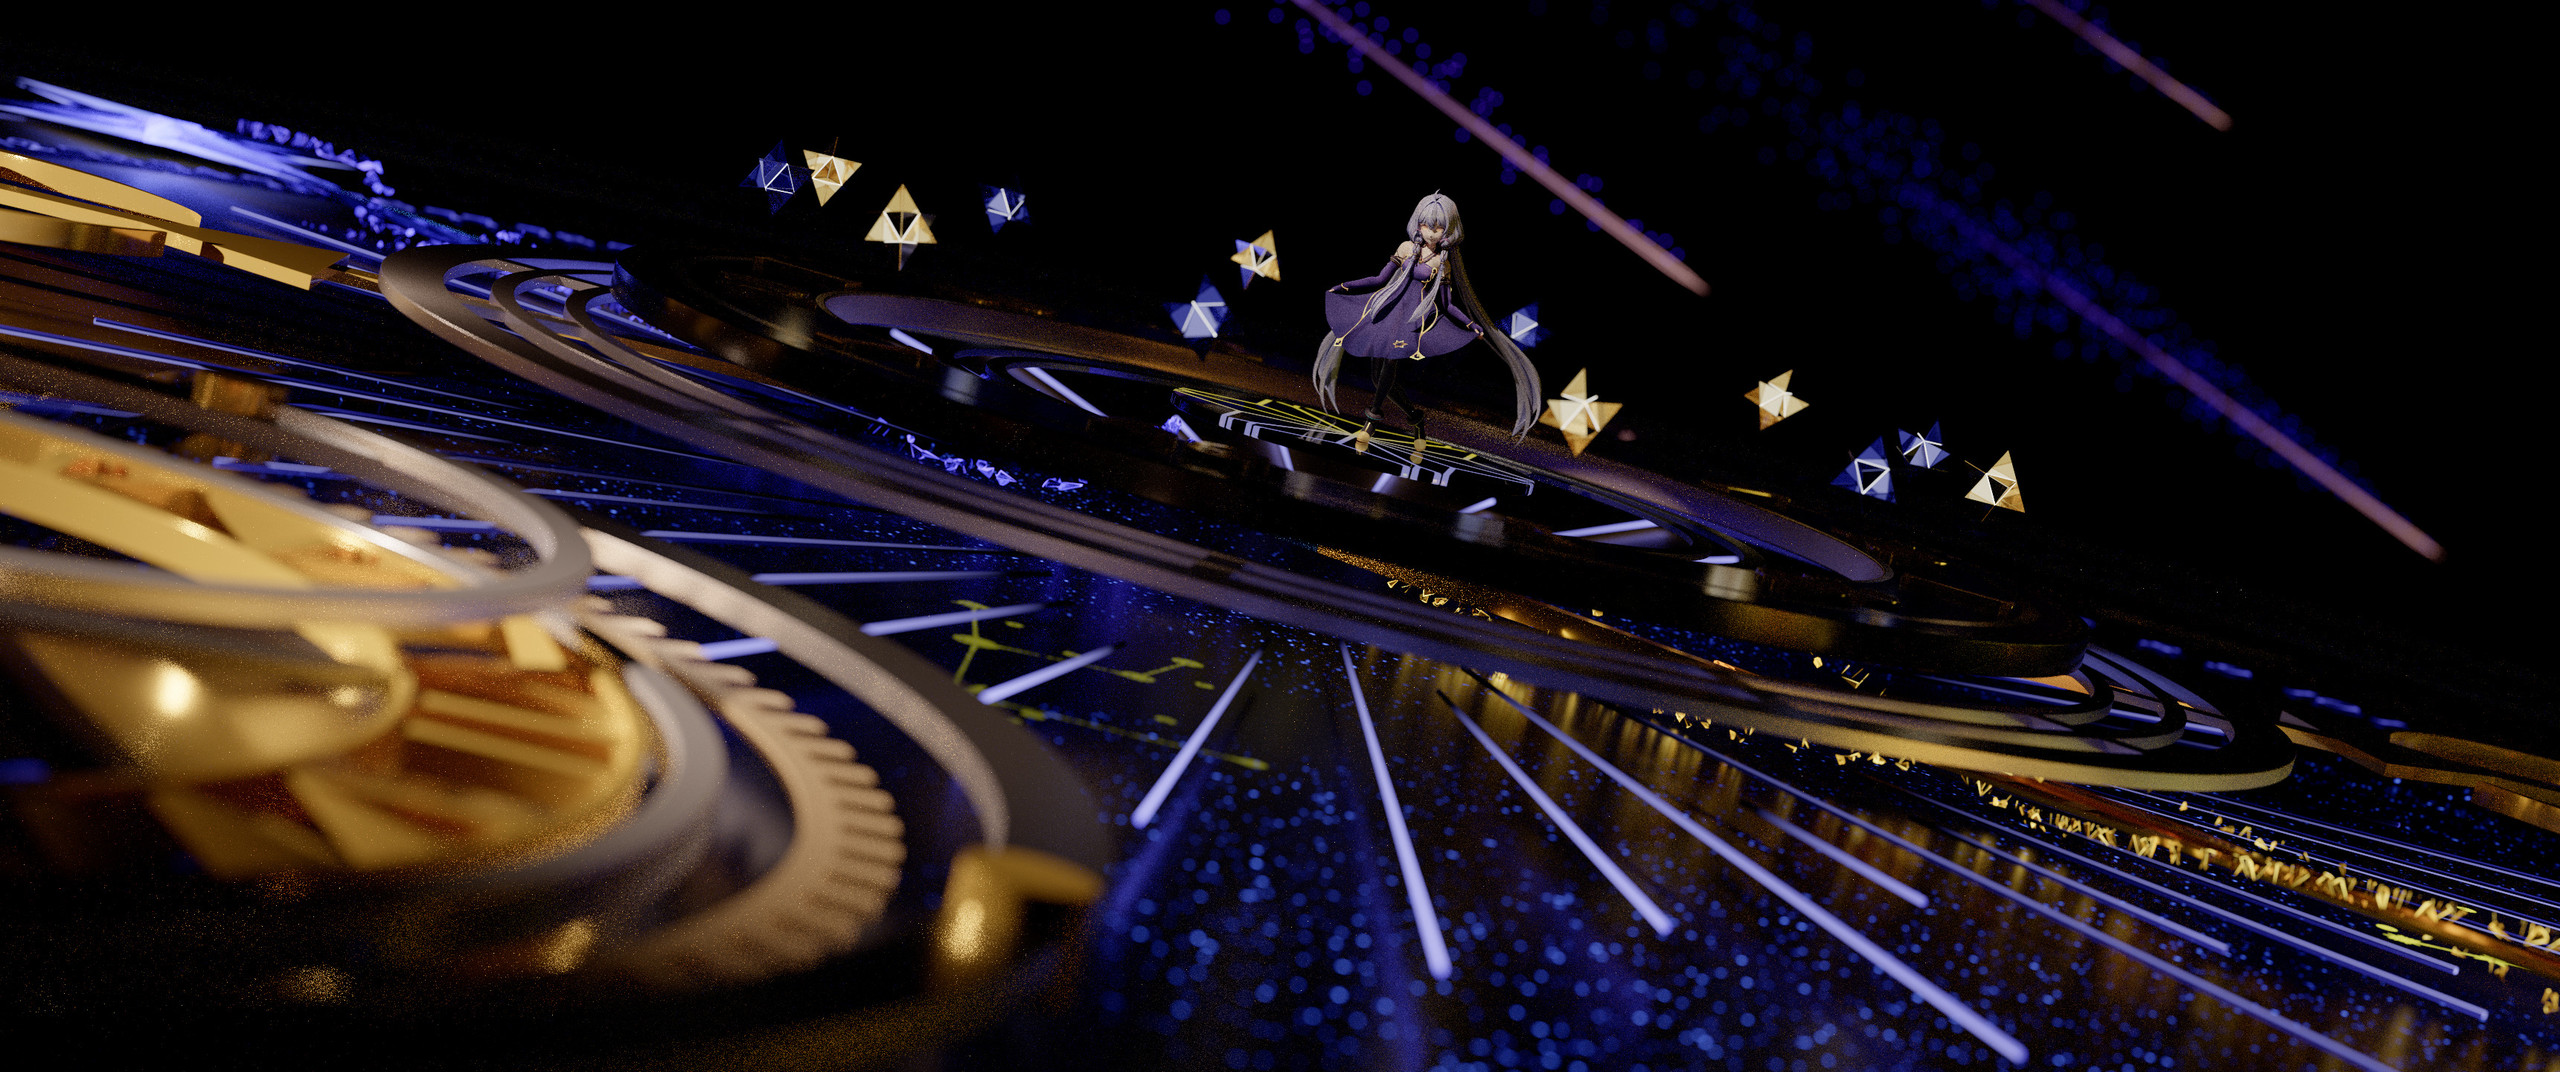
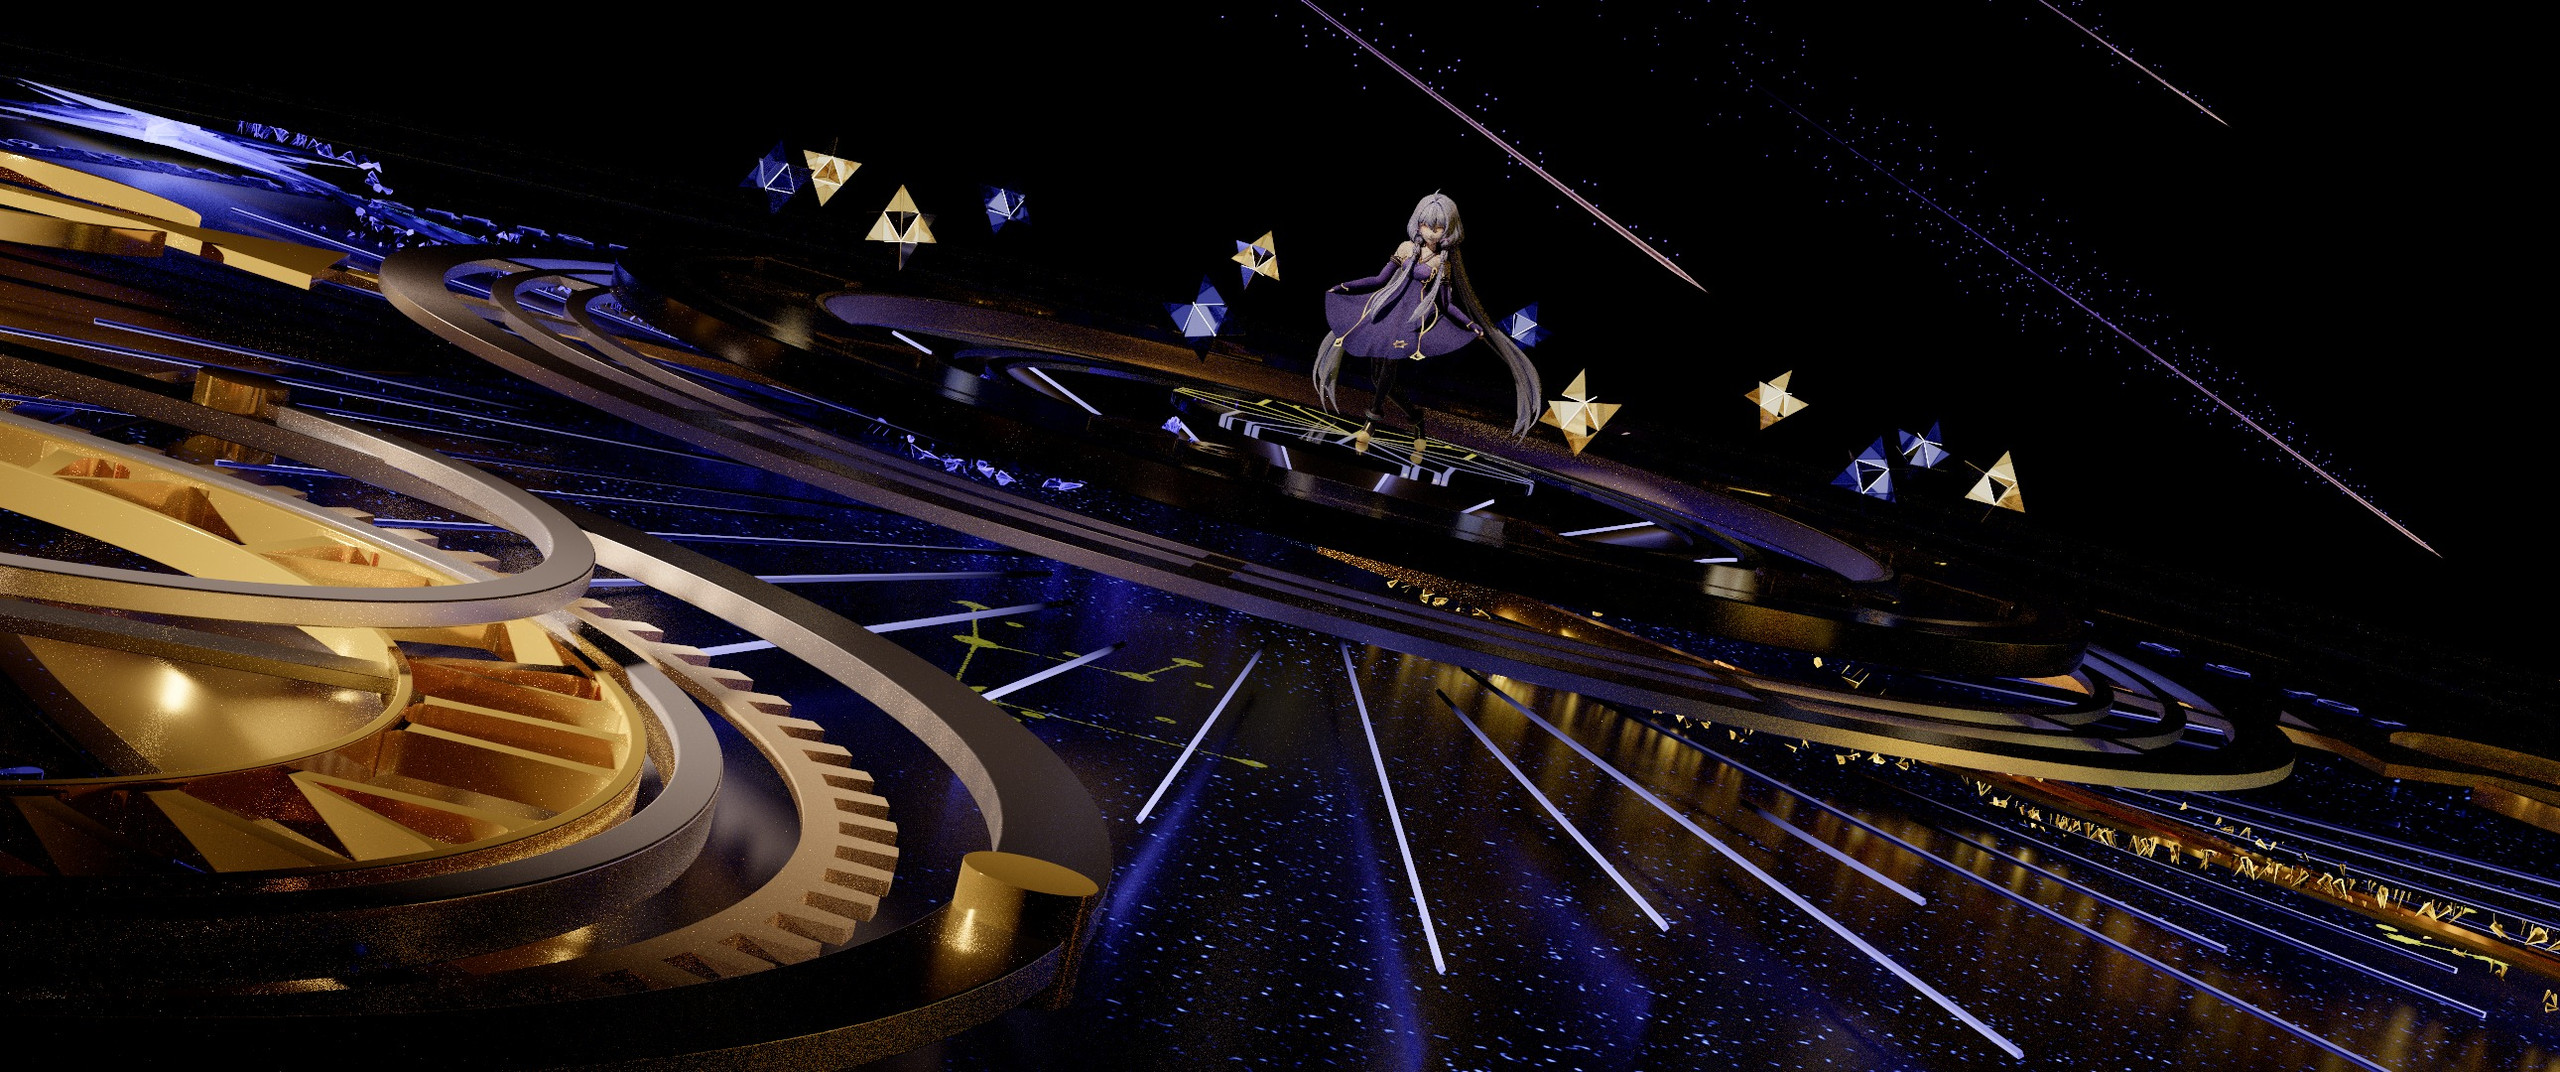
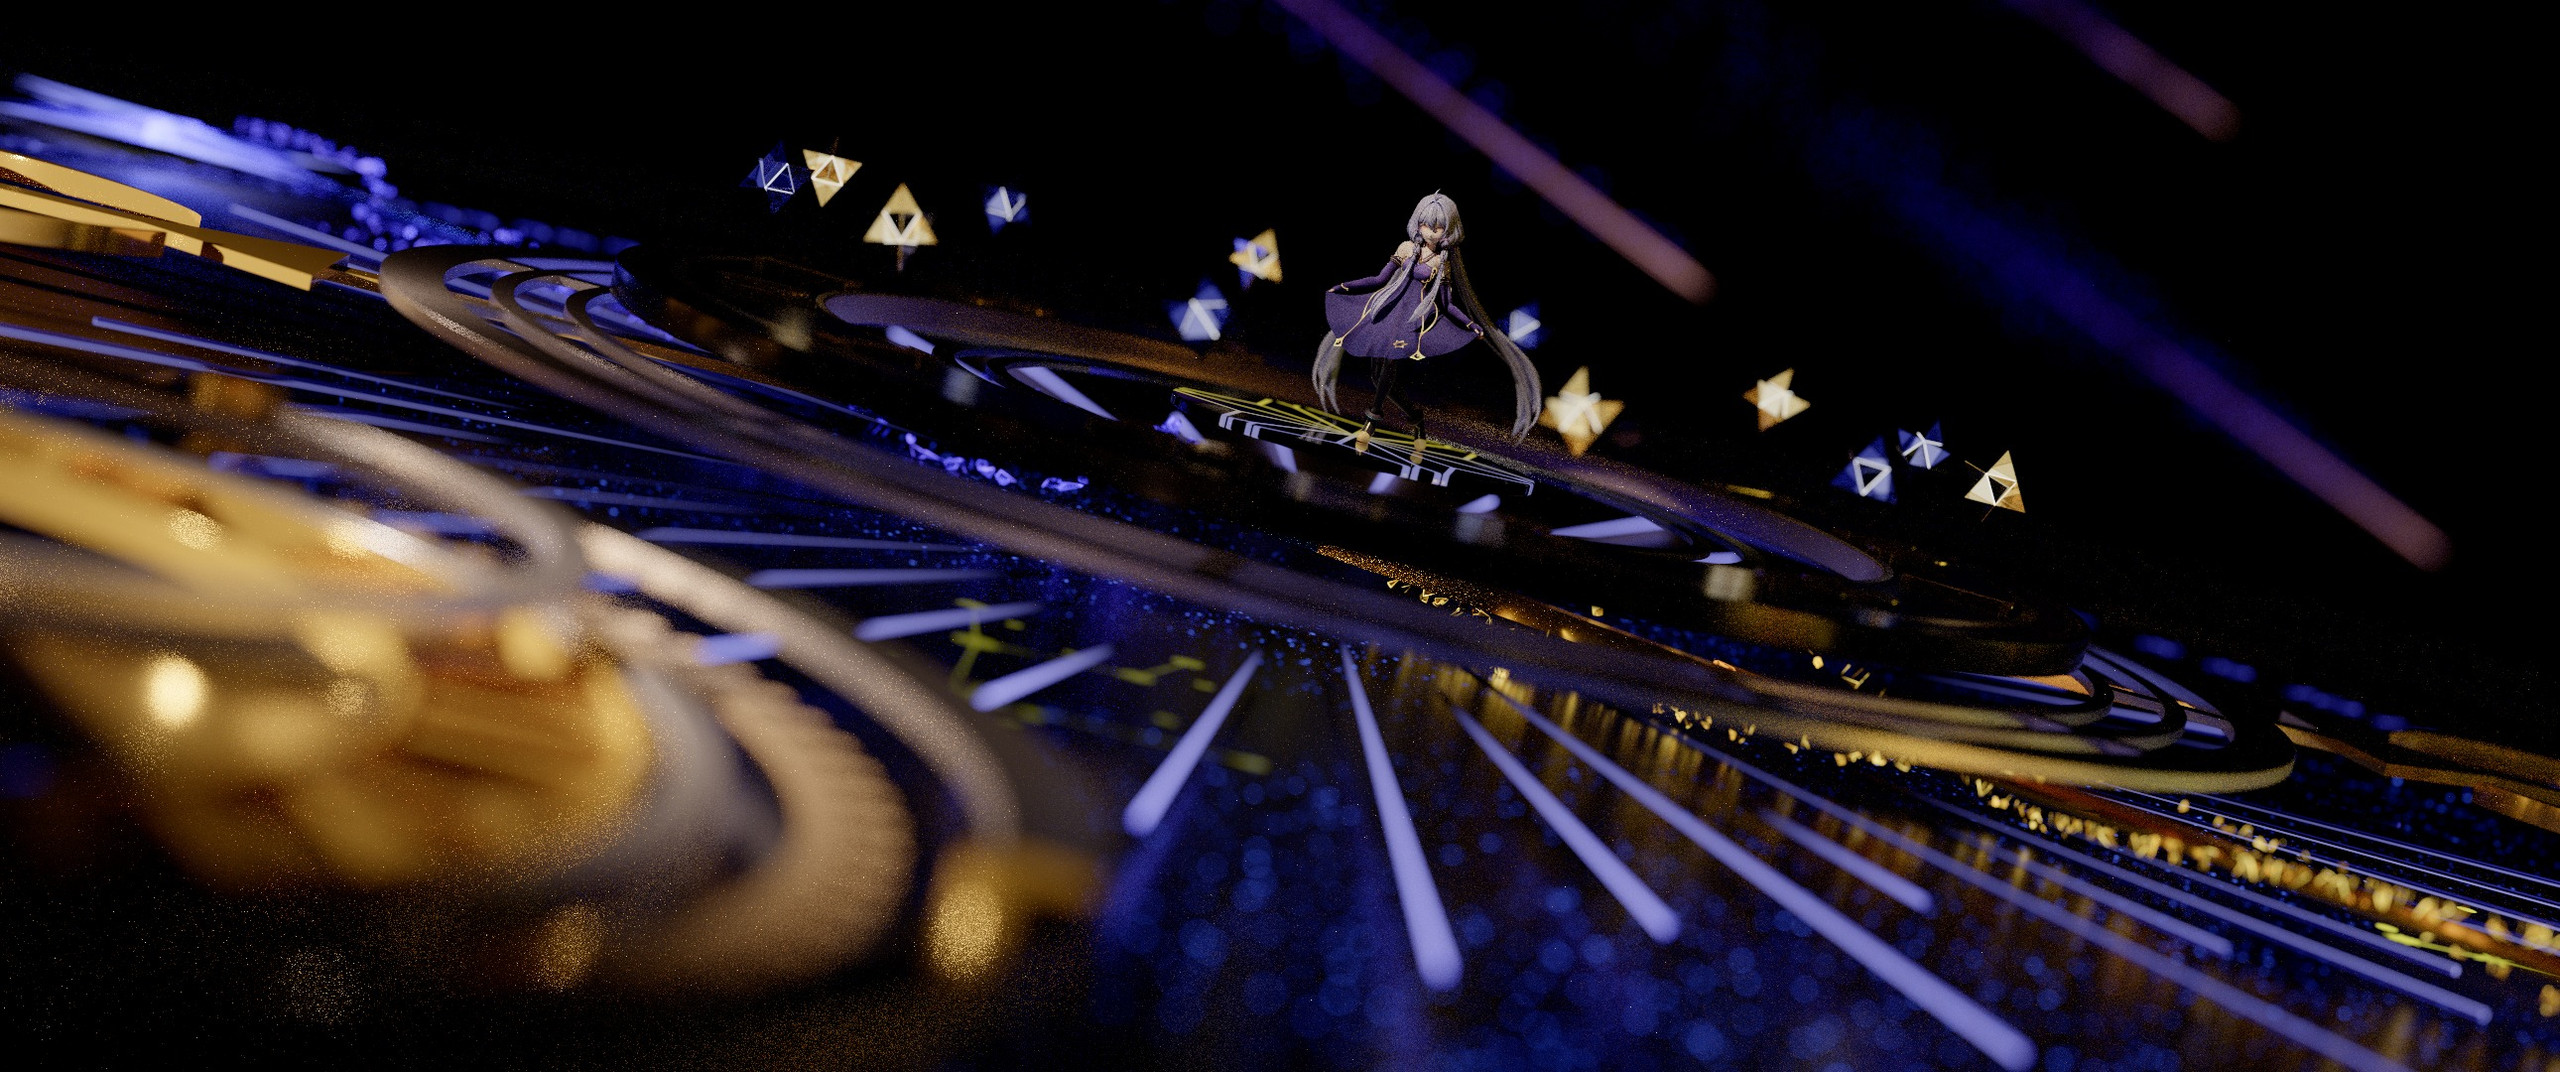
Stardust:我自己的 Blender 场景(8.8 M 个三角形,其中 2.4 M 个自发光,使用灯光链接)。3440x1440、2048 spp、DEPTH 12、AgX、无降噪,在 RTX 3090 上耗时 33.4 s(16.3 ms/sample)。
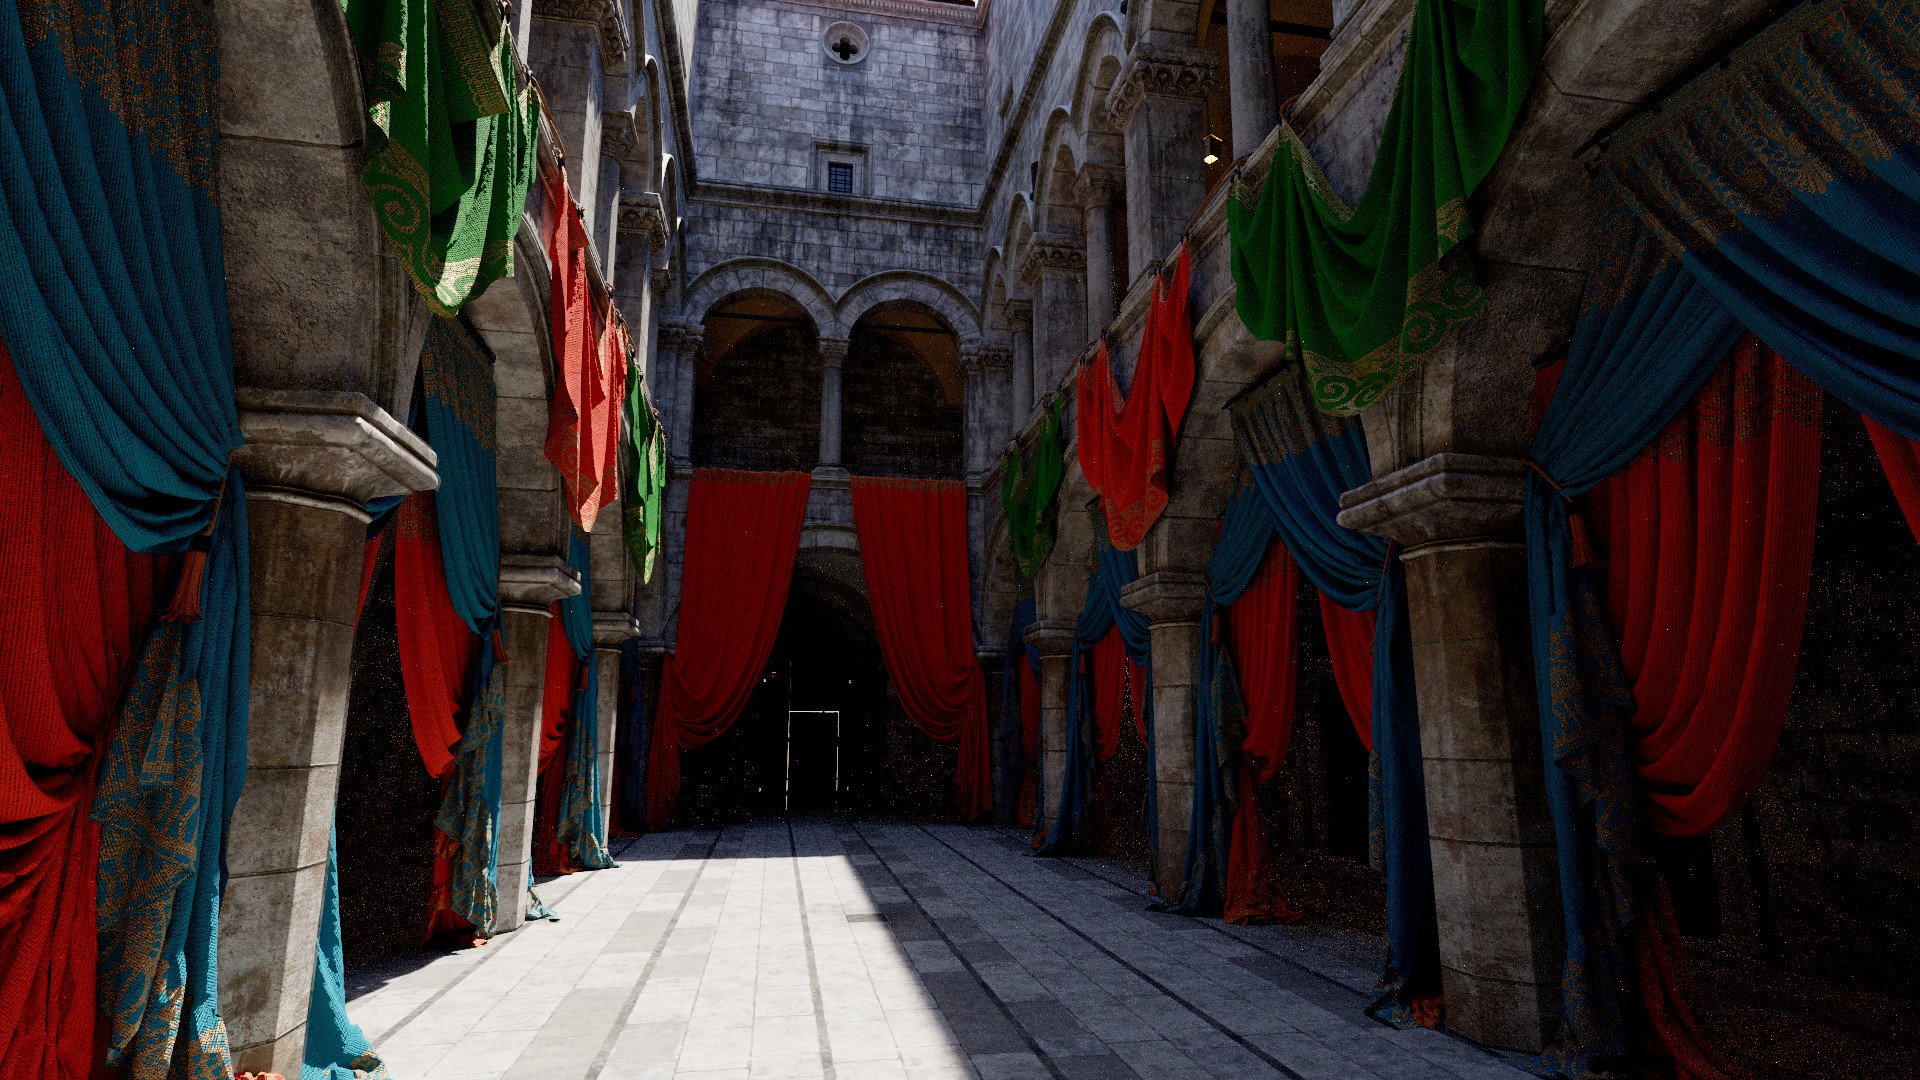
Sponza:带窗帘扩展包的 Intel Sponza,1920x1080、1024 spp、DEPTH 8、AgX punchy、无降噪,在 RTX 3090 上耗时 12.5 s(12.2 ms/sample)。
功能
渲染
- 基于 OptiX 硬件光线追踪的波前路径追踪器
- 带纹理和法线贴图的 glTF 场景与网格
- glTF 金属度-粗糙度材质:透射、体积吸收、清漆、镜面反射、alpha 遮罩与混合
- 针对自发光网格以及点光源、聚光灯、平行光的带 MIS 的下一事件估计
- Blender 灯光链接
- 带 MIS 补偿的重要性采样环境贴图
- 薄透镜景深与随机抗锯齿
- AgX 和 ACES 视图变换
- 基于物理的相机与镜头系统:开发中。
性能
- 在着色核函数内完成流压缩,使用 warp 聚合原子操作
- 基于 CUB 基数排序的材质排序(可选)
- 俄罗斯轮盘赌
- 设备端链接时优化
其他
- ImGui 中的虚幻引擎风格视口相机与场景切换
- 命令行无界面(headless)渲染
渲染管线
渲染器是一个波前路径追踪器:一次弹射的每个阶段都是对所有存活路径的一次启动,结束的路径会被压缩掉。求交运行在 OptiX 硬件光线追踪上。
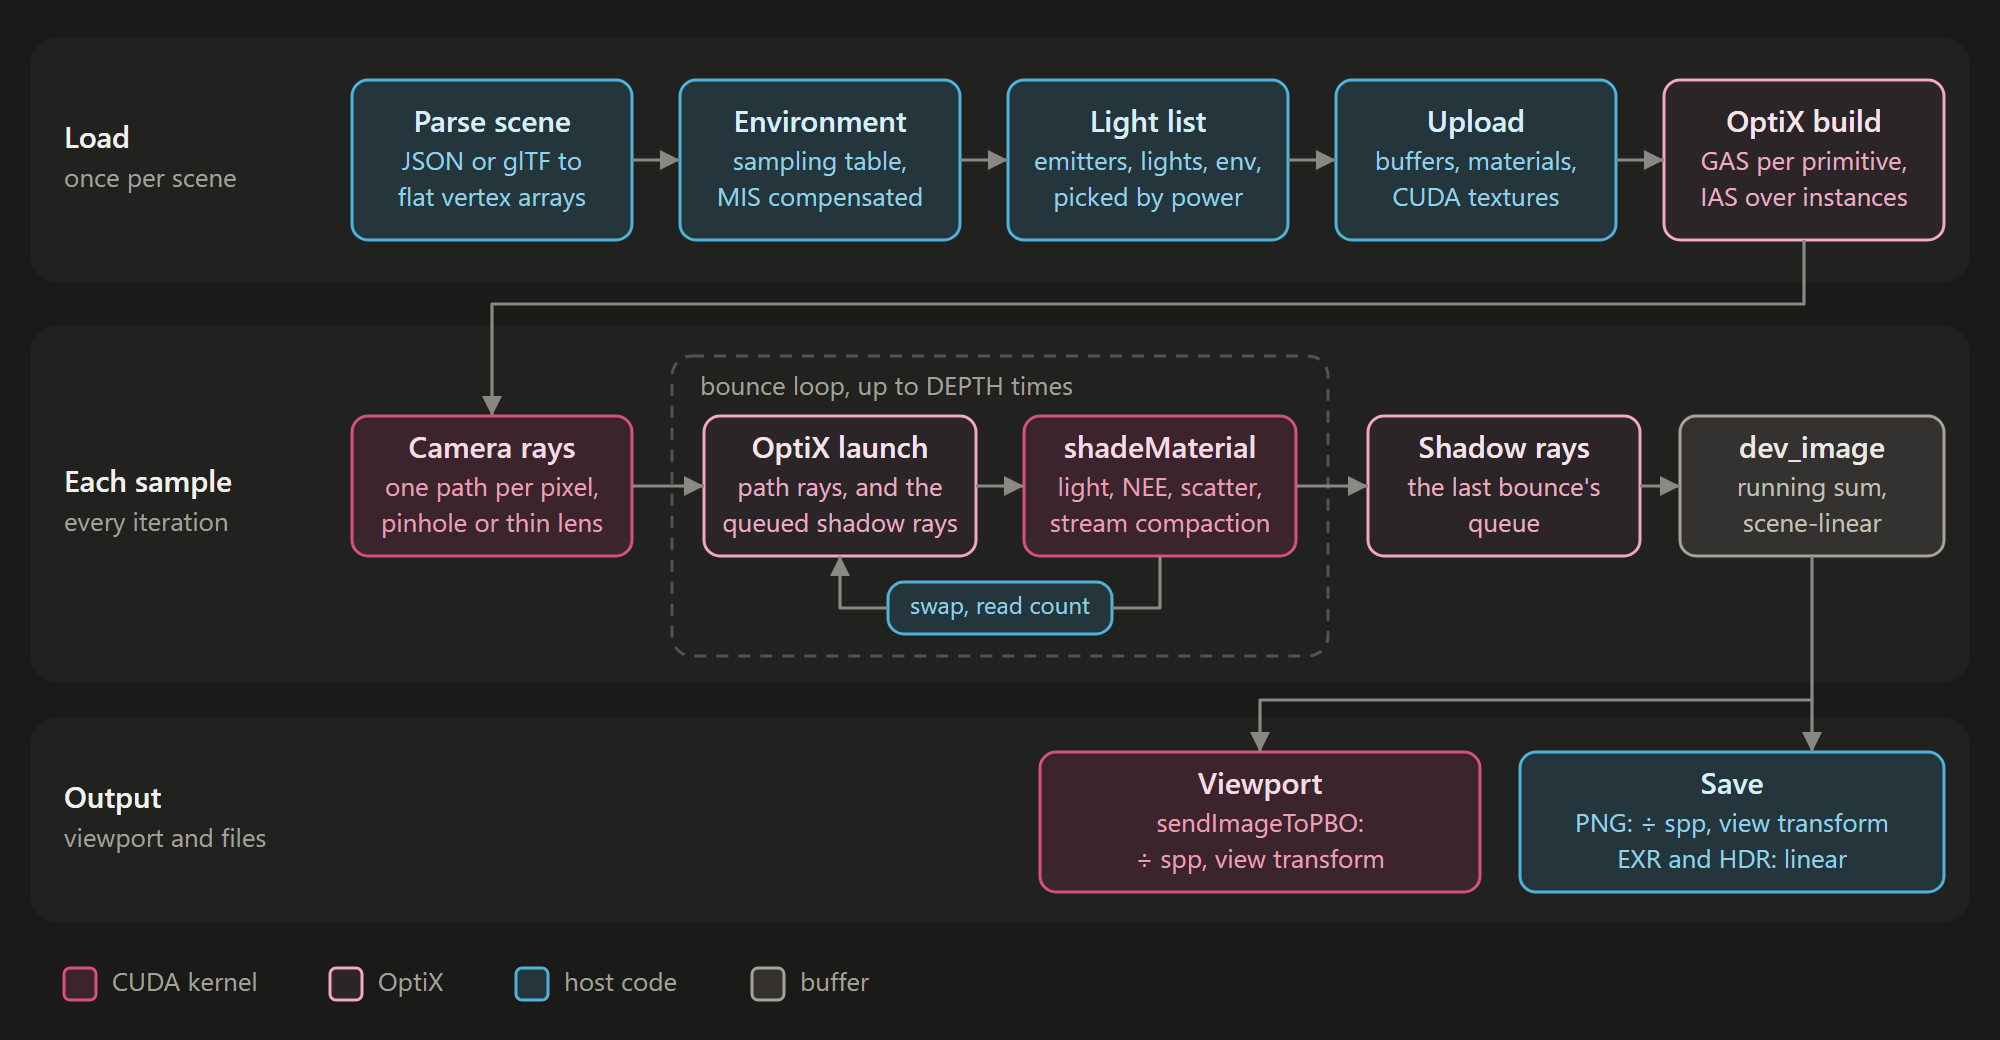
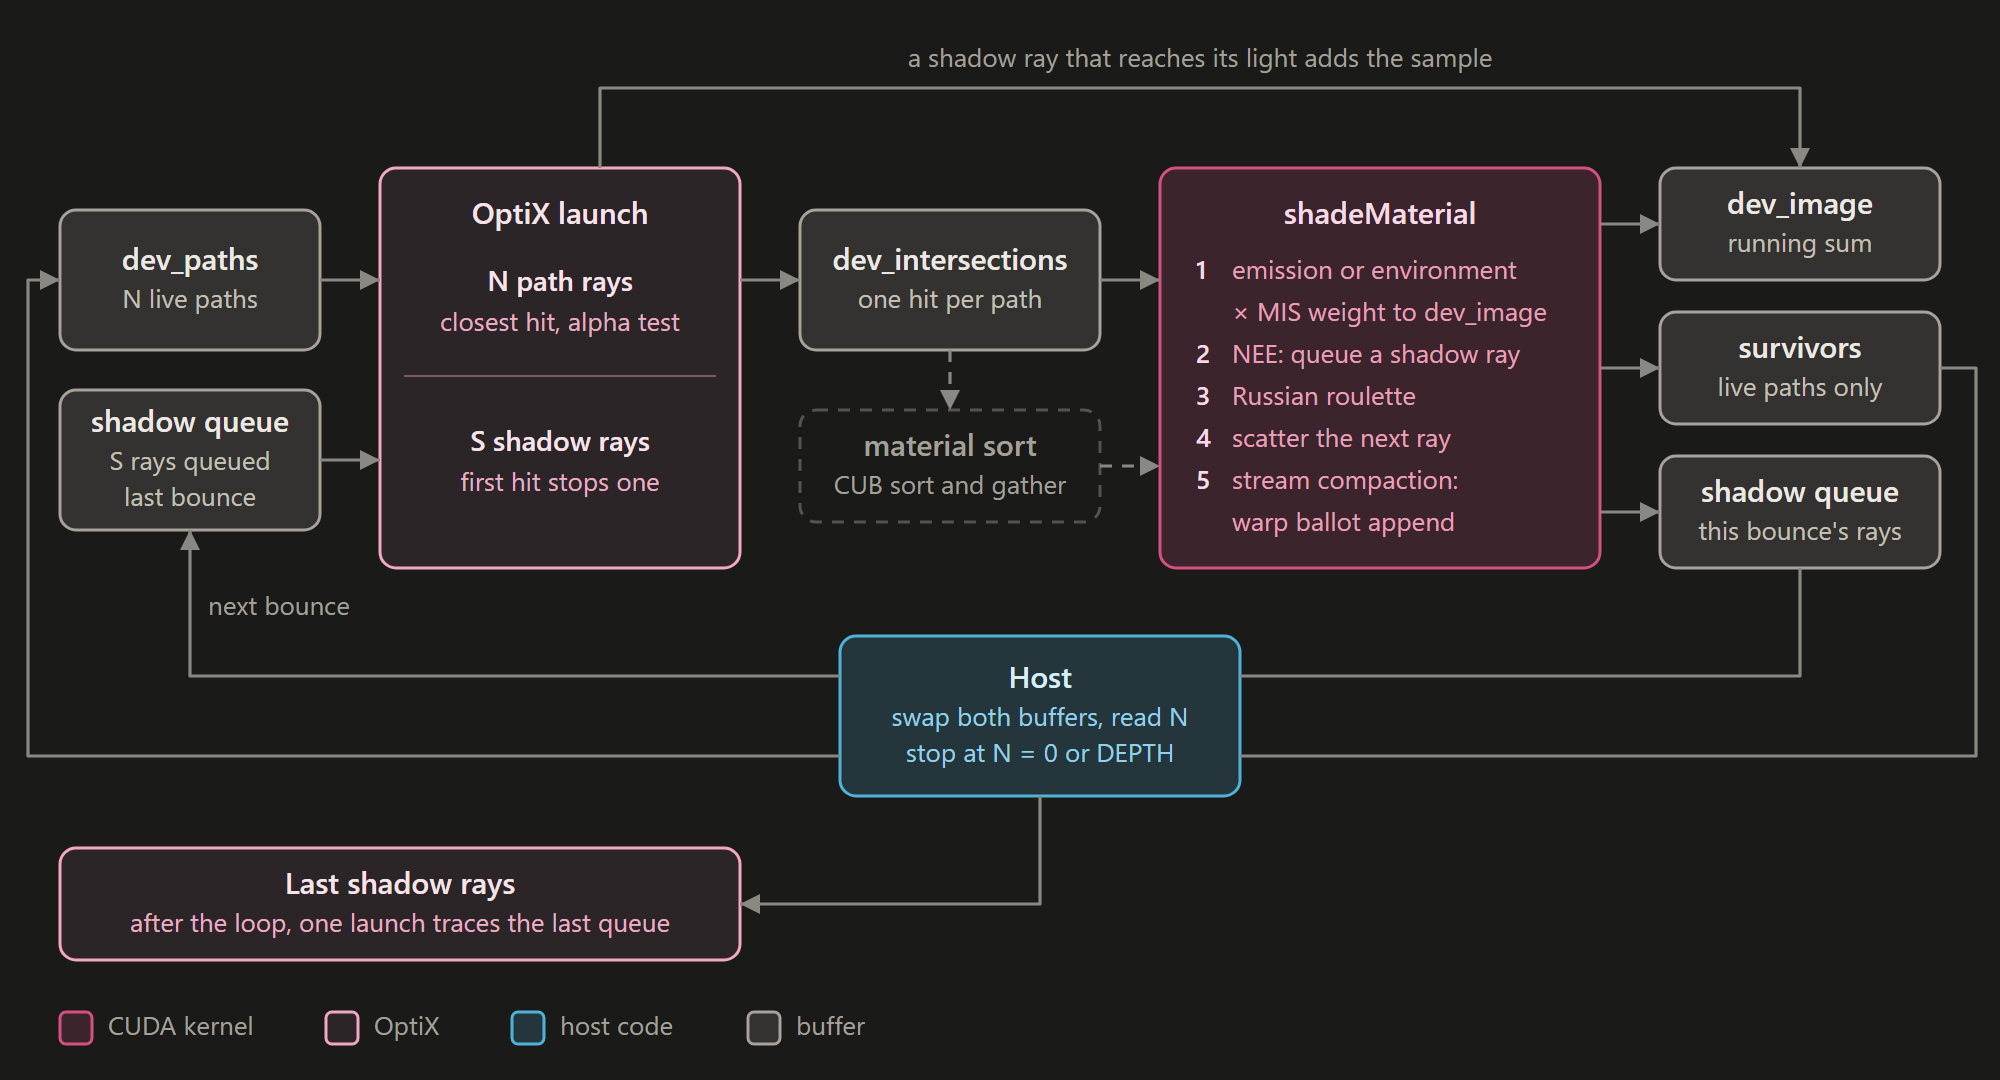
每次弹射对应一次 OptiX 启动和一个 CUDA 核函数。这次启动既把存活路径追踪到最近交点,也顺带追踪上一次弹射排队的阴影光线,每次弹射因此省下一次启动。随后 shadeMaterial 加上按 MIS 加权的自发光,向选中的光源排队一条阴影光线,执行俄罗斯轮盘赌,采样下一个方向,并用 warp 聚合原子操作把存活的路径直接写进下一次弹射的缓冲区(流压缩)。虚线框是材质排序(--sort),由于它会拖慢大多数场景,默认关闭。
渲染功能
glTF 网格加载
glTF 和 glb 文件通过 tinygltf(v2.9.7)加载,既可以作为整个场景,也可以作为场景 JSON 中的一个 "TYPE":"mesh" 对象。带法线贴图但没有切线的网格由 MikkTSpace 生成切线。纹理是由硬件解码 sRGB 的 CUDA 纹理对象;缺失的纹理会在基础色槽位渲染成品红色,这样坏掉的资产会直接在渲染中暴露出来。
OptiX 为每个 glTF 图元构建一个三角形 GAS,并在所有实例之上构建一个 IAS。--no-optix 会回退到朴素核函数,它逐个测试每一个三角形,且渲染时不带 NEE。
朴素循环与 OptiX 随三角形数量的对比
1024x1024,每样本毫秒数,取 3 次运行的中位数。
| 场景 | 三角形 | 深度 | 朴素 | OptiX |
|---|---|---|---|---|
| cornell(球体和立方体,无网格) | 0 | 8 | 8.41 | 8.63 |
| cornell-box(研究场景) | 36 | 66 | 11.56 | 11.43 |
| cornell_helmet | 15,452 | 8 | 320 | 8.42 |
| transmission_roughness | 77,792 | 12 | 1,511 | 7.37 |
| dragon_attenuation | 134,995 | 16 | 3,146 | 7.52 |
| sponza | 262,267 | 8 | 5,553 | 10.20 |
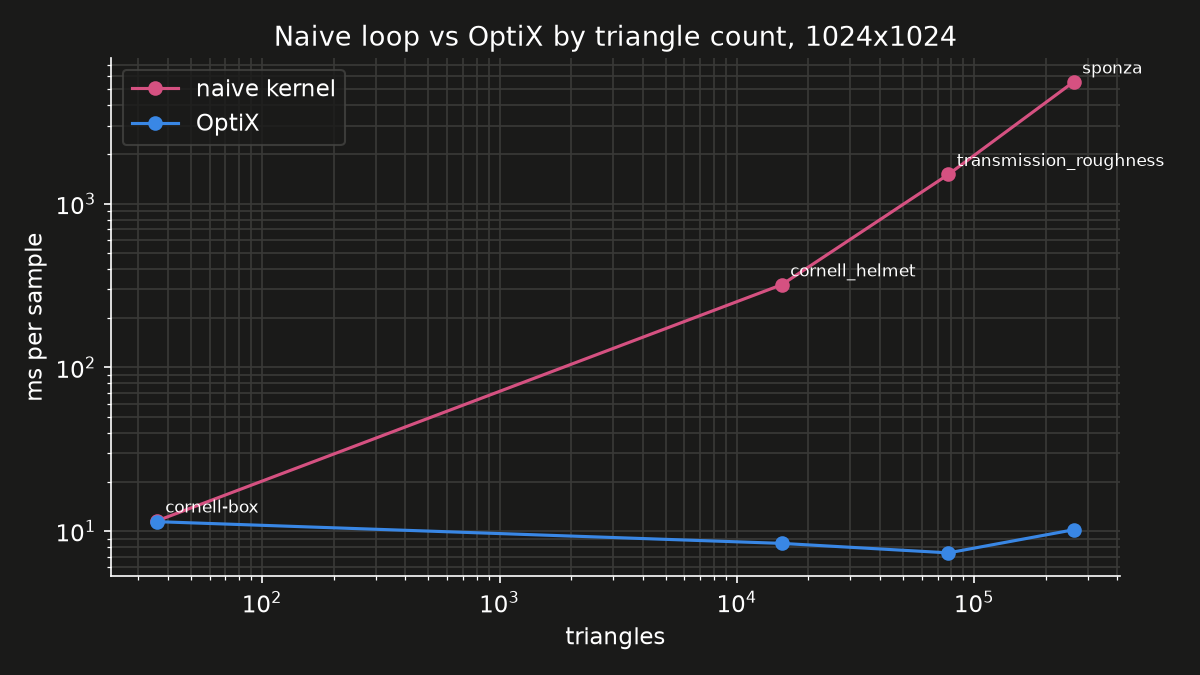
朴素核函数的耗时随三角形数量线性增长,大约每千个三角形每样本 20 ms,因为每条路径在每次弹射都要测试每个三角形。直到 Sponza,OptiX 都保持在 Cornell 帧时间的 15% 以内,在 Intel Sponza(5.7 M 个三角形)上也只需 12.7 ms。
glTF 金属度-粗糙度材质
本渲染器的材质采用 glTF 2.0 的金属度-粗糙度(metallic-roughness)参数,用规范附录 B 中的参考 BRDF 着色,并通过 KHR_materials_transmission、volume、ior、specular、clearcoat 和 emissive_strength 扩展为 BSDF。支持法线贴图、alpha 遮罩和 alpha 混合(以随机覆盖率实现)。我选择把透射当作实体边界,而不是 glTF 默认的薄壁处理,因为在没有 KHR_materials_volume 扩展时,这更符合 Blender 的导出结果。
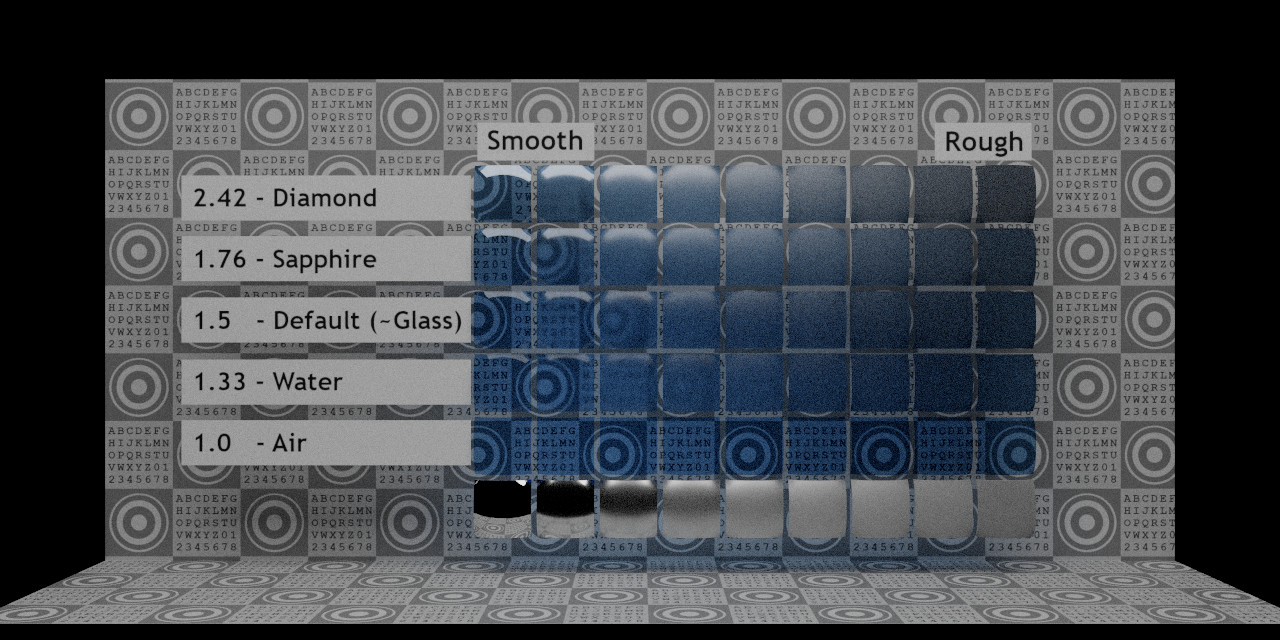
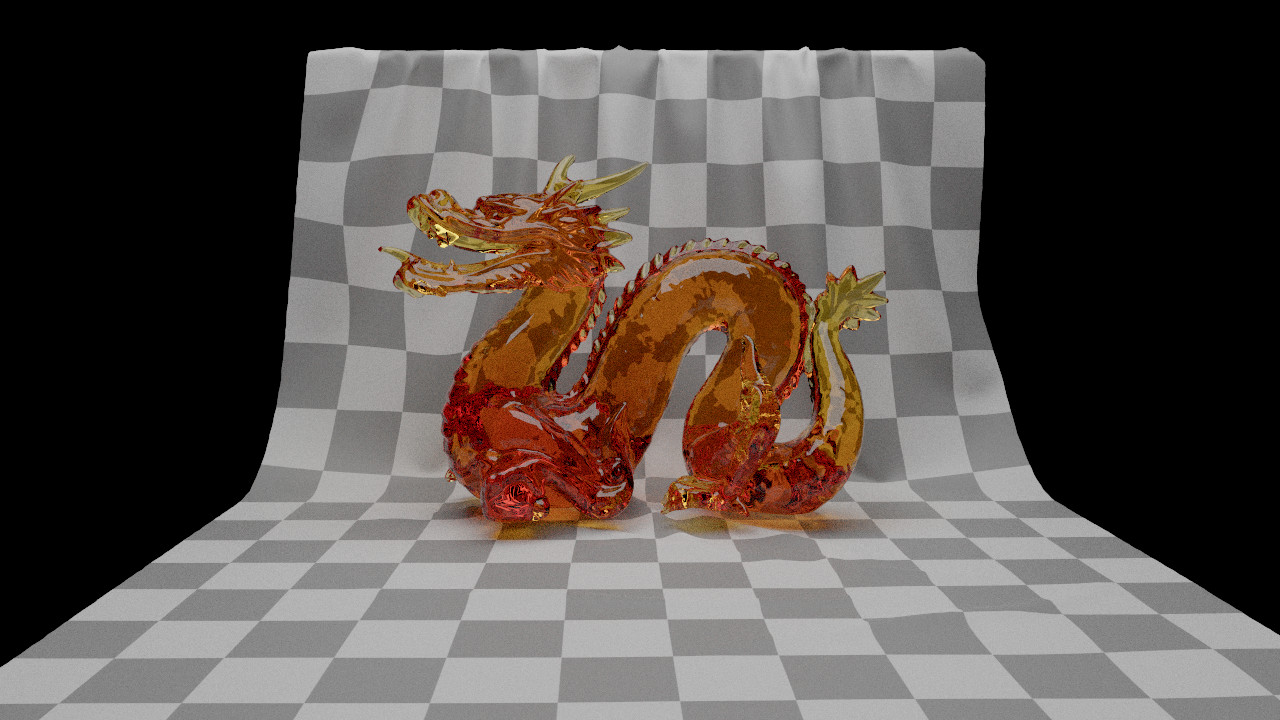
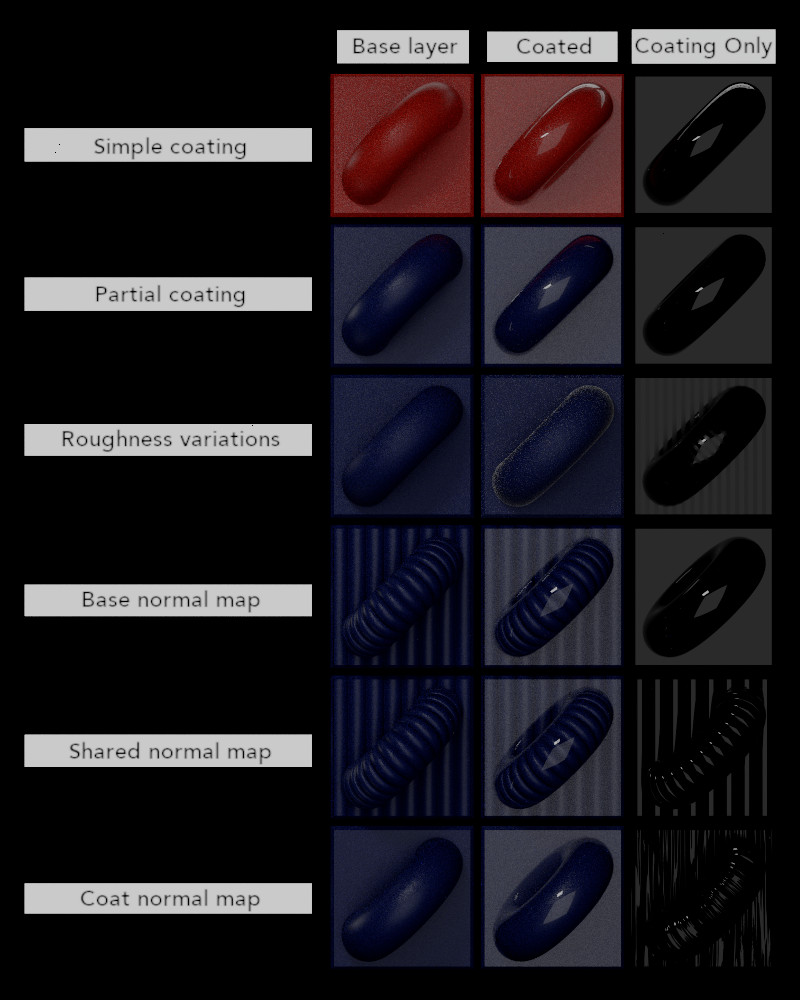
三个 Khronos 材质测试模型都不带光源,所以我在场景文件里加了一块面光。以 1024 spp、AgX 渲染。
| TransmissionRoughnessTest,1280x640 | DragonAttenuation,1280x720 |
|---|---|
 |  |
| ClearCoatTest,800x1000 | DamagedHelmet,800x800 |
 |  |
- TransmissionRoughnessTest:ior 从 1.0(顶部)到 2.42,粗糙度向右递增。ior 1.0 那一行保持清晰,因为光线在那里不会发生偏折。
- DragonAttenuation:单一的吸收颜色和距离;细尾呈现较淡的黄色,厚实的躯干则是深橙色。
- ClearCoatTest:基础层宽泛的高光(左)、清漆层锐利的高光(右),以及两者叠加(中)。
- DamagedHelmet:法线、金属度-粗糙度和自发光贴图。
NEE 与 MIS
除路径的最后一个交点外,每个交点都会做下一事件估计(NEE):在光源上选一个点,并向它排队一条阴影光线。多重重要性采样(MIS)用幂启发式(power heuristic,Veach 1997)在这个光源样本和命中同一发光体的 BSDF 采样光线之间加权。光源按功率比例选取:自发光三角形、来自 KHR_lights_punctual 的点光源、聚光灯和平行光,以及环境贴图。样本足够多时,NEE + MIS 与单纯 BSDF 采样收敛到相同的均值,在八个测试场景上差异都在 0.1% 以内。--no-nee 和视口面板中的复选框可以关闭它。
Veach MIS,1024x1024、64 spp、AgX、OptiX。
| 仅 BSDF 采样 | NEE + MIS |
|---|---|
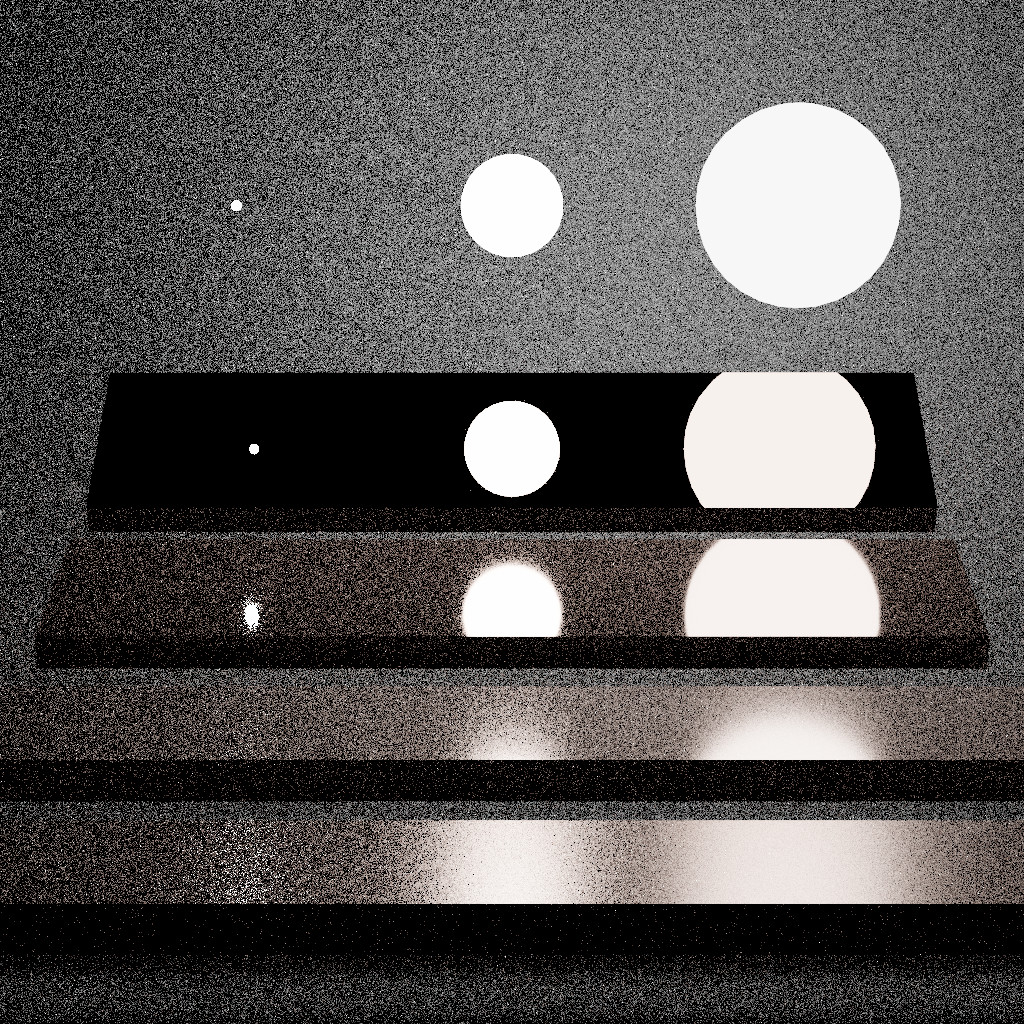 | 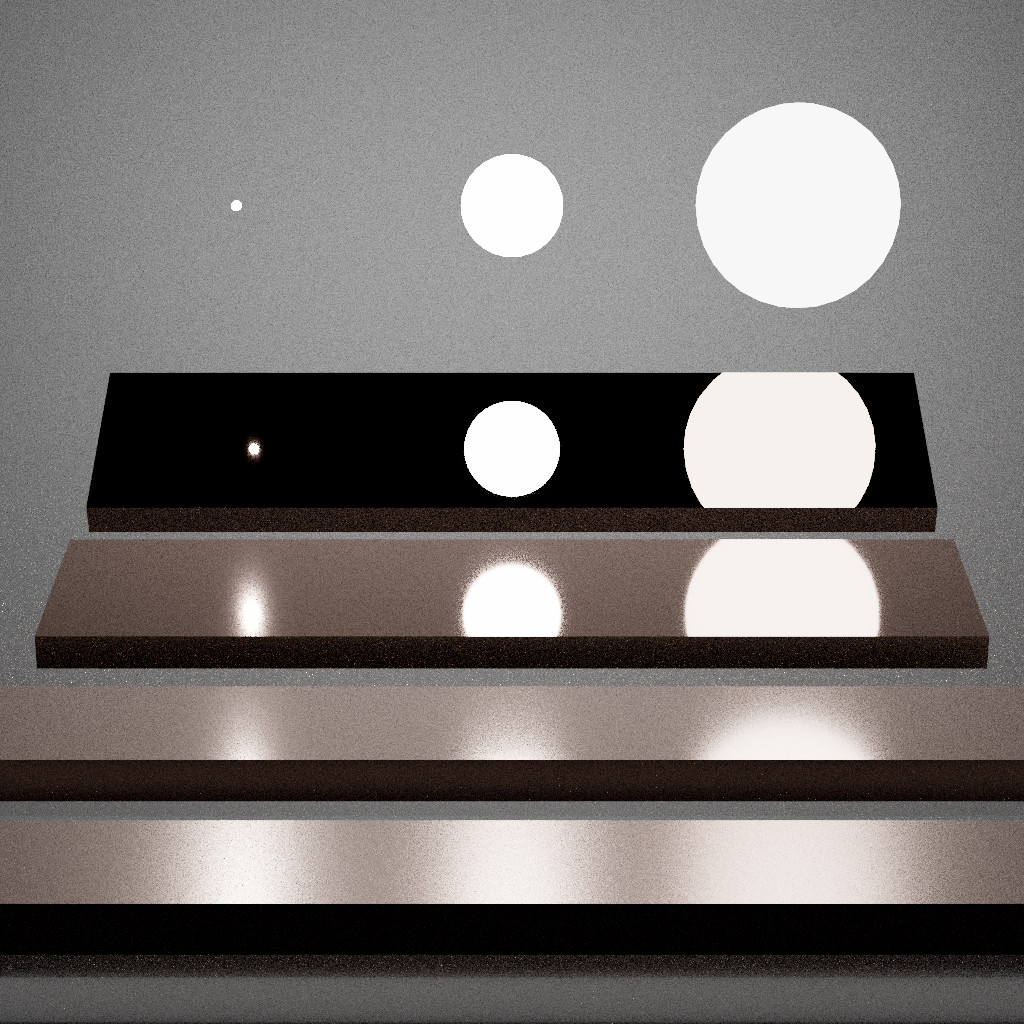 |
- 噪声:相对 4096 spp 参考图的 RMSE 从 62.8 降到 9.1(满值 255),方差减少 48 倍。
- 帧时间:开启 NEE 为 2.34 ms/spp,关闭为 1.46。
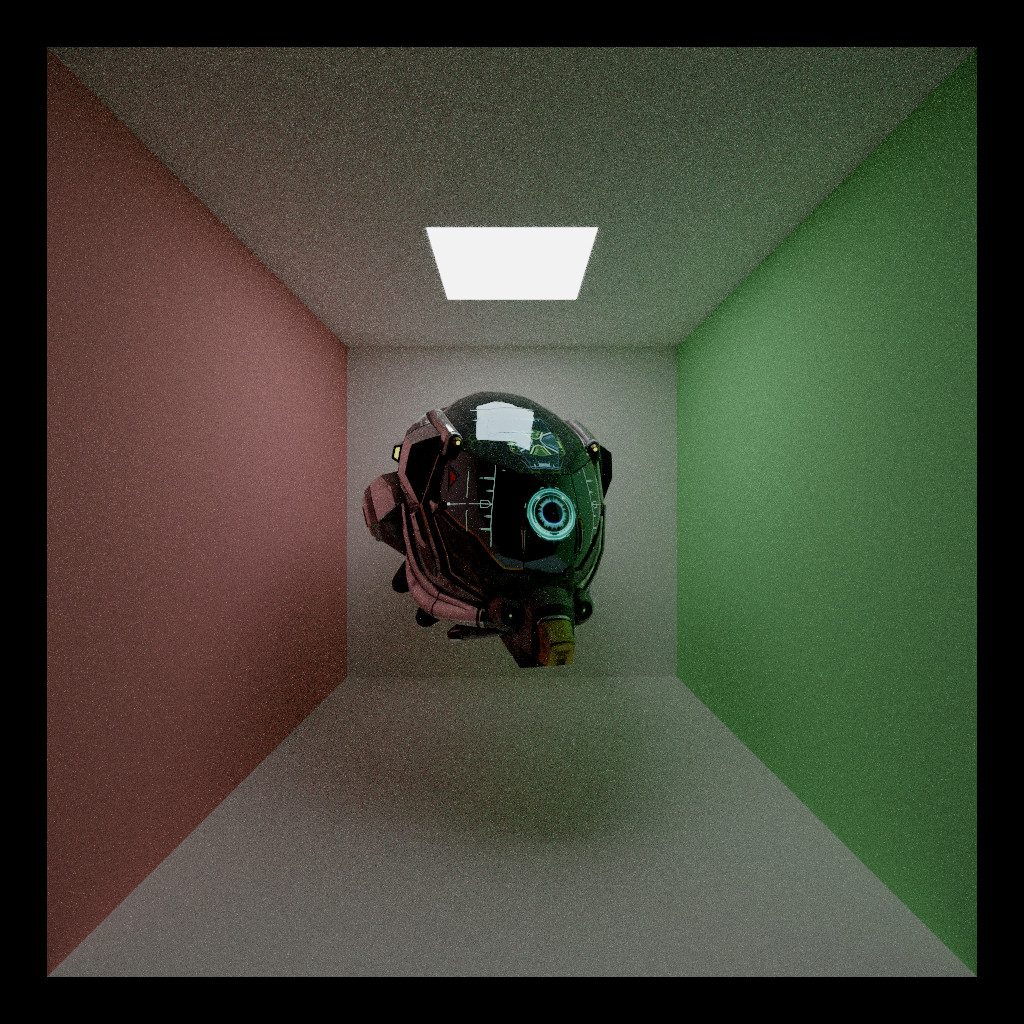
光源功率中的自发光纹理
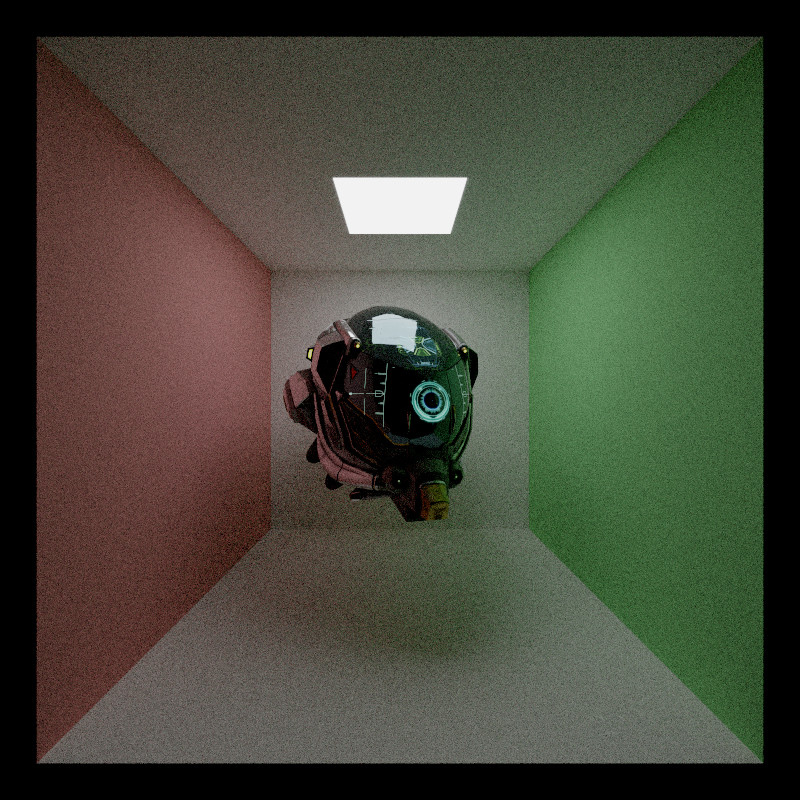
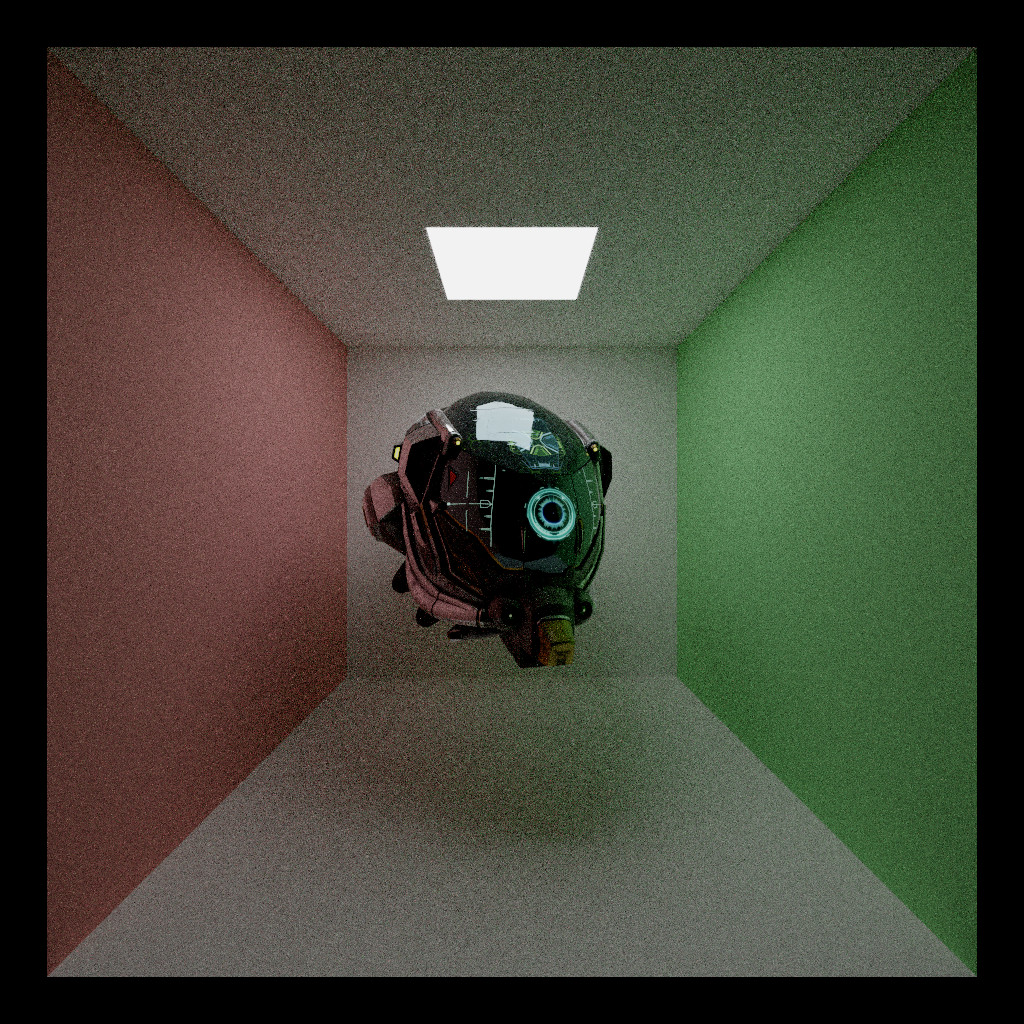
自发光三角形的选取权重是它的自发光系数乘以自发光纹理的平均值(PBRT-v4 对图像面光源的加权方式)。DamagedHelmet 是一个很好的带自发光纹理的例子:它有大量自发光系数为 1 的三角形,但自发光纹理的大部分是黑色。在计入纹理平均值之前,这些自发光三角形占据了 63% 的光源选取,而且几乎全都一无所获。计入纹理平均值后,它们只占 0.3%。
cornell_helmet,1024x1024、64 spp、AgX。下排:头盔前方地面,2 倍放大。
| 之前:仅自发光系数 | 之后:系数 x 纹理平均值 |
|---|---|
 |  |
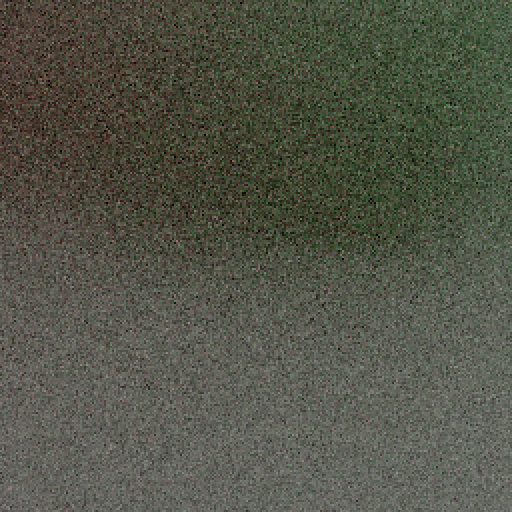 | 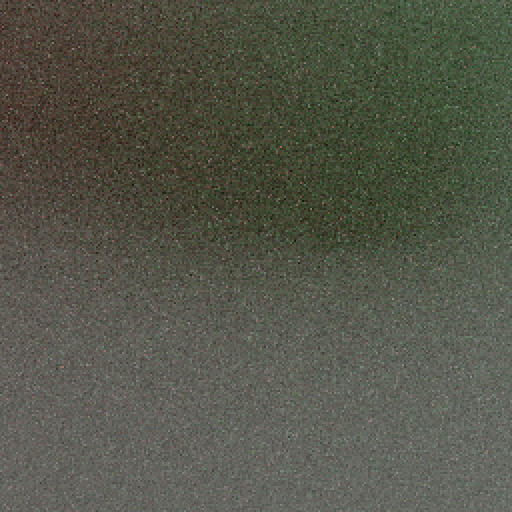 |
- 噪声:相对 4096 spp 的 RMSE 从 12.9 降到 9.2(满值 255),大致相当于样本数翻倍的效果。
- 帧时间:3.0 对比 2.9 ms/spp。
灯光链接
灯光链接(light linking)让一个光源只照亮接收集合中的物体。Stardust 就依赖这一功能。当接收者没有链接到被选中的光源时,这个光源样本会被丢弃;BSDF 光线在一个与其表面没有链接的发光体上找到的自发光同样会被丢弃,这样 MIS 权重之和仍然为 1。光源选取对场景中每一种不同的接收者掩码使用一张表,因此表面只会选取能照到它的光源(原因)。
环境贴图采样
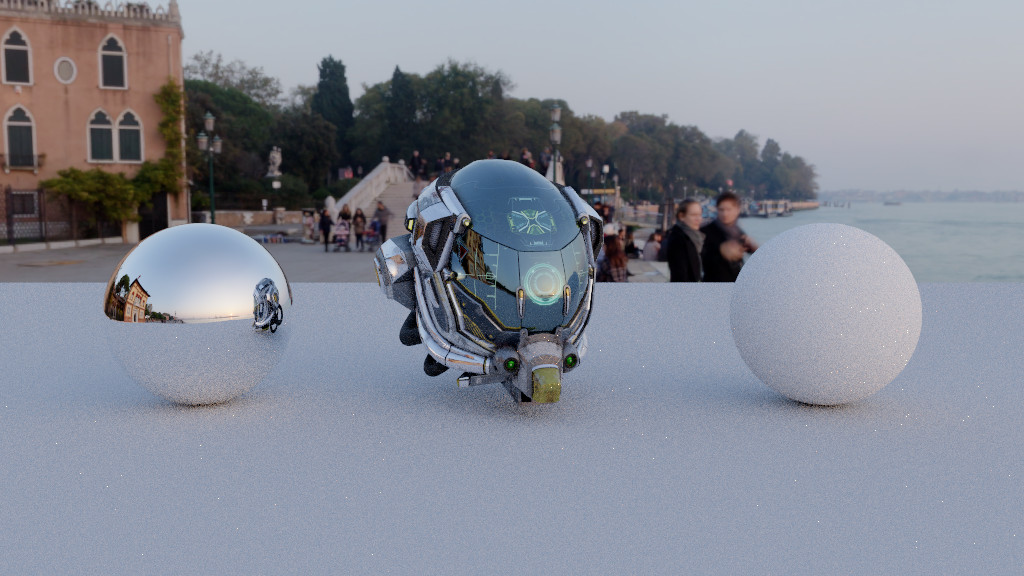
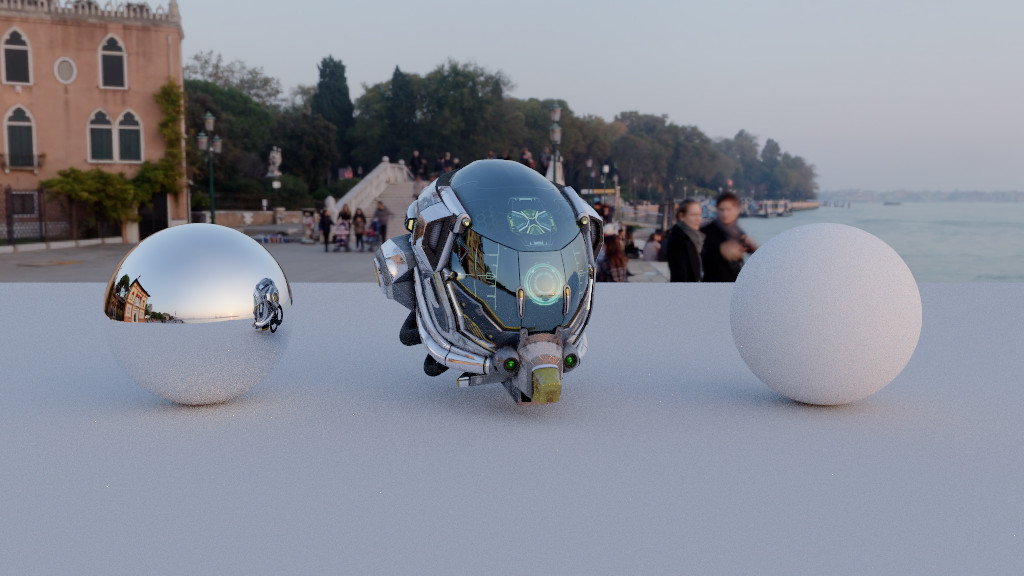
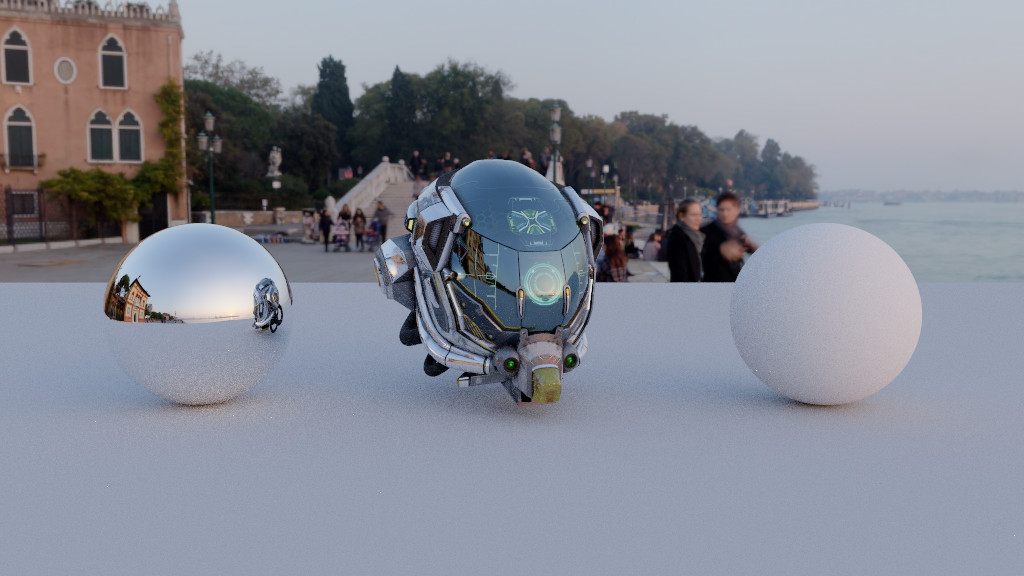
如果只靠 BSDF 采样来找到环境光,日落 HDRI 下的漫反射表面只能碰运气命中太阳,这就是下方左列中的颗粒噪点。环境贴图是 NEE 选取的光源之一,从基于贴图亮度的二维表中抽取,并通过 MIS 与 BSDF 采样加权。MIS 补偿(MIS compensation,Karlík et al. 2019)在建表前减去贴图的平均值,于是选取集中到太阳和明亮区域,天空中均匀的部分则交给 BSDF 采样覆盖。
hdri_helmet,使用 venice_sunset_4k.hdr,1024x576、64 spp、AgX。下排:漫反射球前方地面,2 倍放大。
| 环境光由 BSDF 采样 | 环境光 NEE + MIS | 加上 MIS 补偿 |
|---|---|---|
 |  |  |
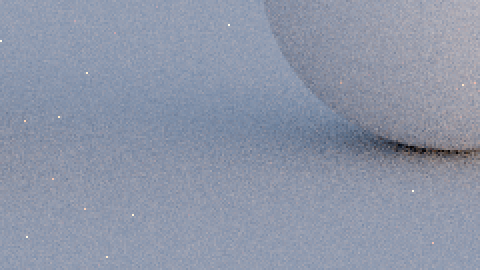 | 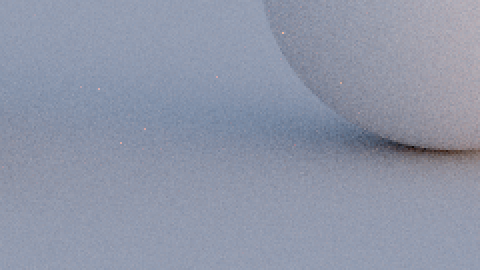 | 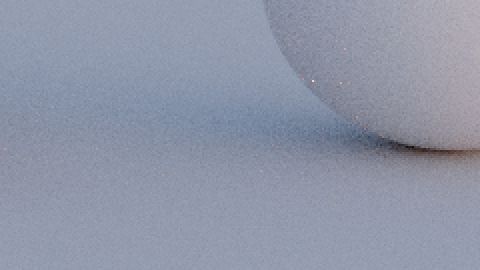 |
- 噪声:相对 4096 spp 的 RMSE 分别为 4.34、2.85 和 2.69(满值 255)。
- 帧时间:分别为 1.11、1.55 和 1.37 ms/spp。
- 地面上残留的亮点是铬球反射的太阳,属于焦散,任何光源样本都到达不了。
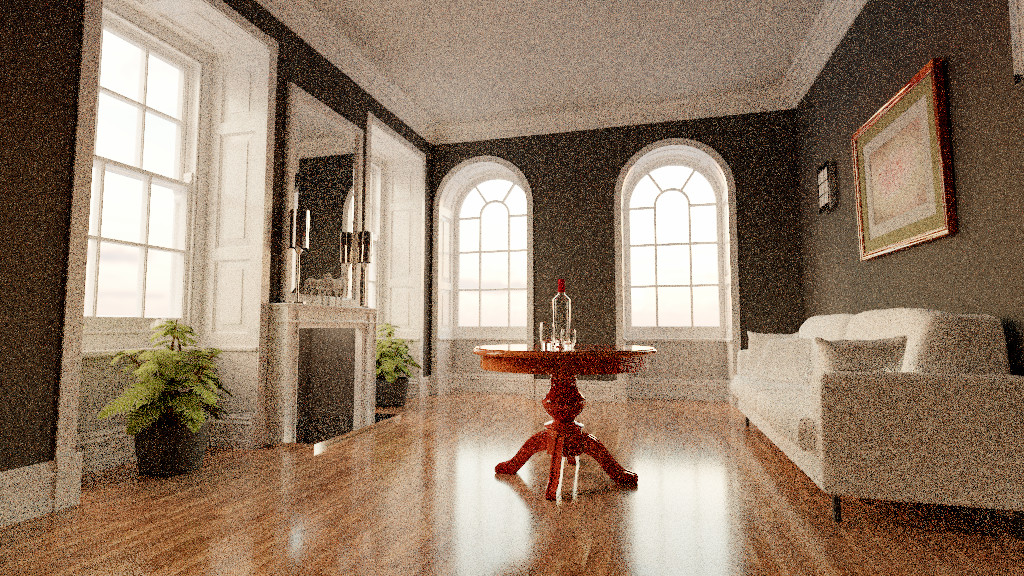
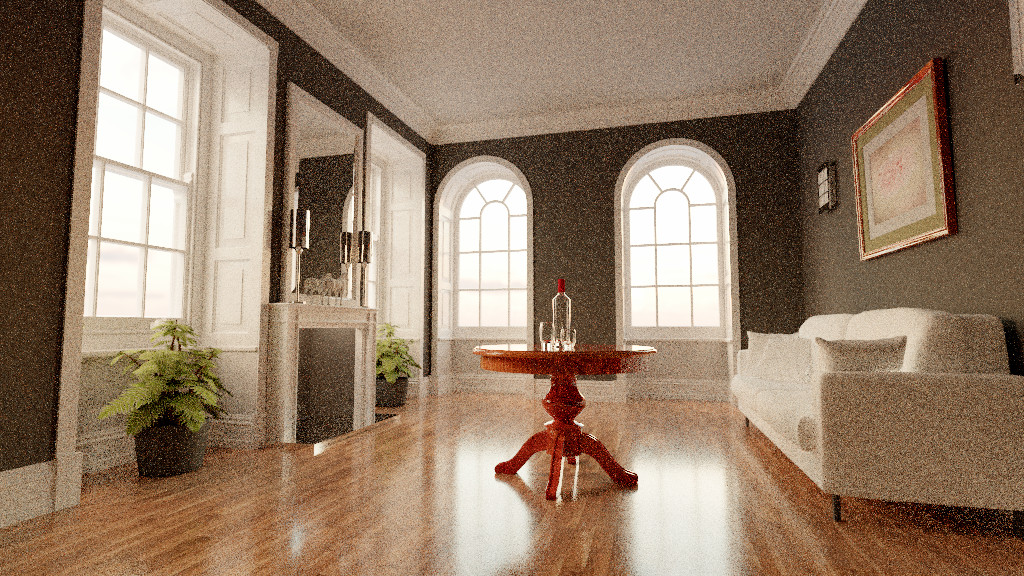
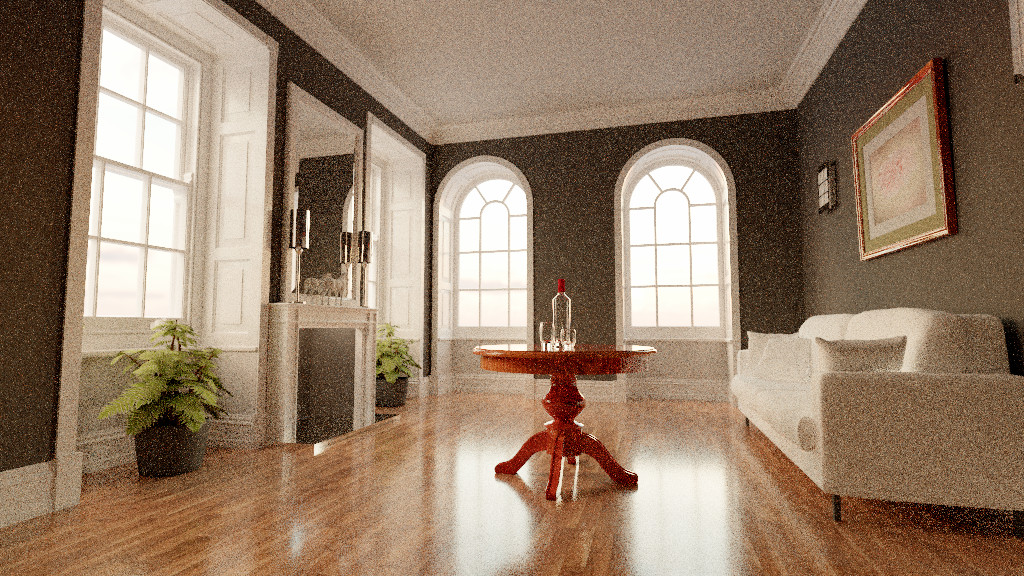
living-room,仅由其天空贴图照明,1024x576、256 spp、AgX。下排:右侧窗户上方的天花板和墙面,2 倍放大。
| 环境光由 BSDF 采样 | 环境光 NEE + MIS | 加上 MIS 补偿 |
|---|---|---|
 |  |  |
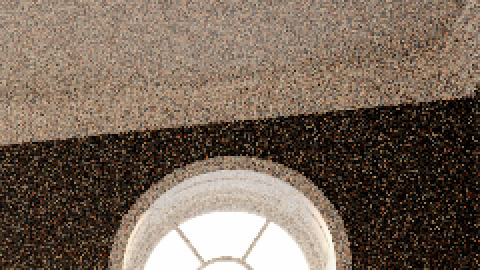 | 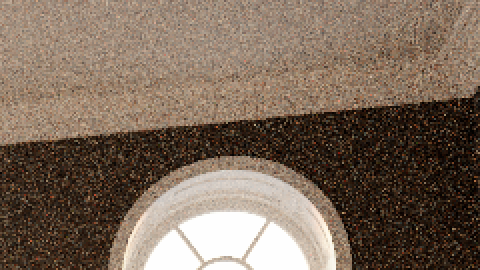 | 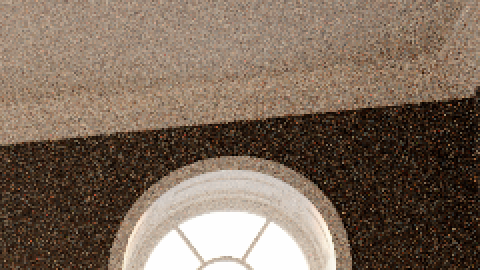 |
- 噪声:相对 2048 spp 的 RMSE 分别为 24.5、16.1 和 14.9。
- 帧时间:分别为 4.34、7.42 和 6.85 ms/spp。从室内发出的环境阴影光线大多终止在墙上。
抗锯齿
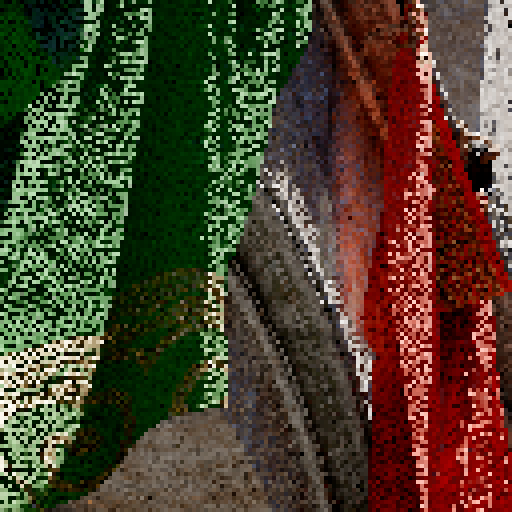
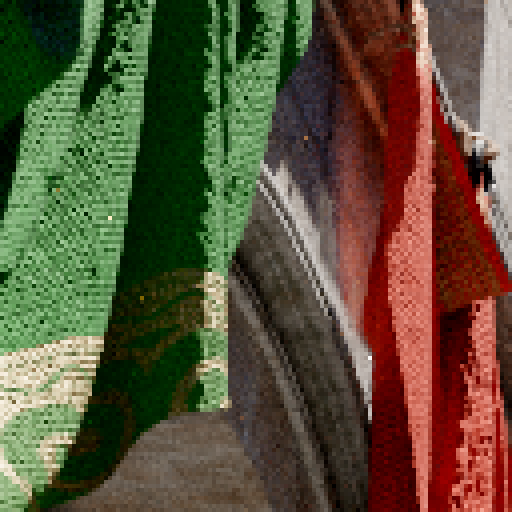
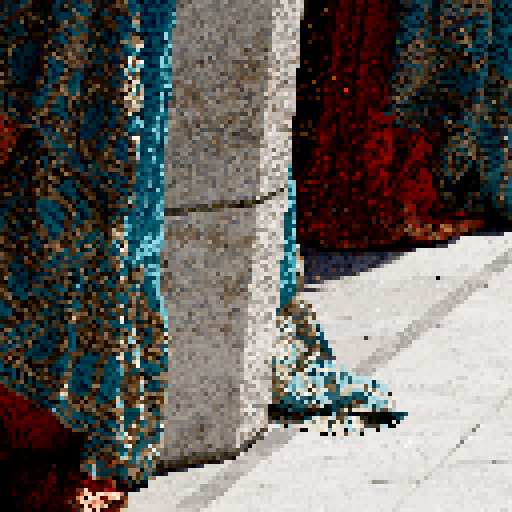
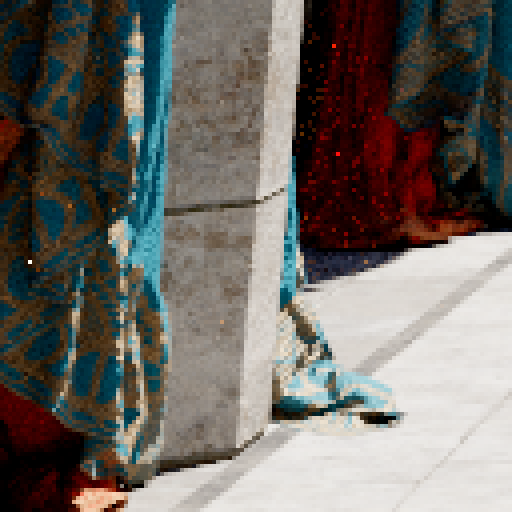
每个样本都让像素的相机光线穿过像素内的一个随机点,而不是像素中心,这样随着样本累积,边缘和纹理会在整个像素范围内取平均。渲染器没有 mipmap,所以这种抖动也是唯一的纹理过滤:没有它,精细的纹理细节会混叠成噪点。--no-aa 让所有光线都穿过像素中心,便于对比。抖动没有可测量的开销,开关都是 7.81 ms/spp。
Intel Sponza,1024x1024、1024 spp、AgX punchy。128x128 裁剪,4 倍放大:
| 无抗锯齿 | 抗锯齿 |
|---|---|
 |  |
 |  |
景深
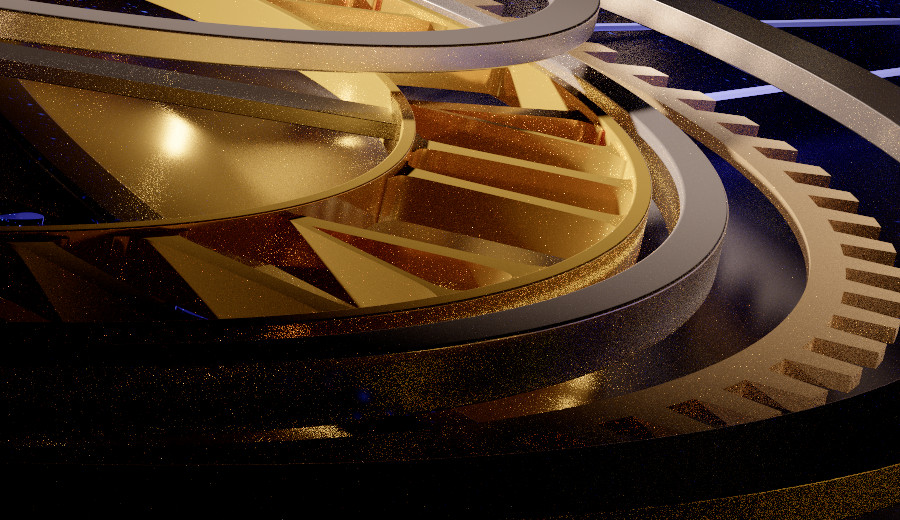
薄透镜相机让每条光线从半径为 APERTURE 的圆盘上的随机点出发,并瞄准针孔光线与 FOCUS 处平面的交点,因此该平面保持清晰,偏离它的物体则随距离变模糊。Stardust 的光圈由 Blender 相机的焦距和 f 值换算而来(半径 = 焦距 / 2N);下面的渲染把它从封面的 0.0625 开到 0.15。--lens、--aperture 和 --focus 可以覆盖场景文件中的设置。薄透镜的开销为 8.36 ms/spp,针孔为 8.06。
Stardust,2580x1080、2048 spp、DEPTH 12、AgX。下排:前景齿轮,1 倍。
| 针孔 | 薄透镜,光圈 0.15 |
|---|---|
 |  |
 | 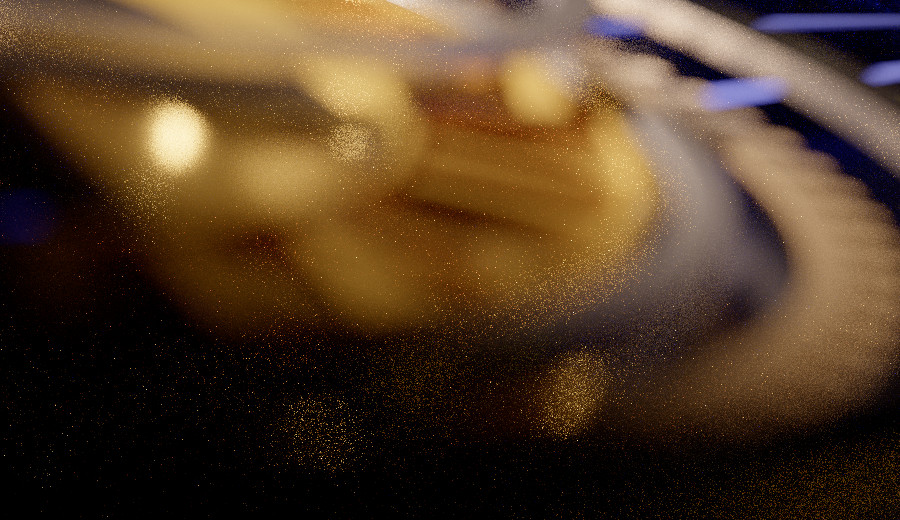 |
视图变换
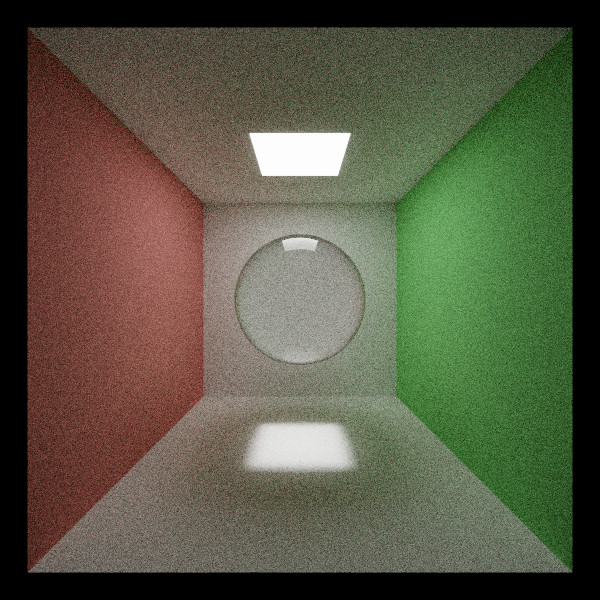
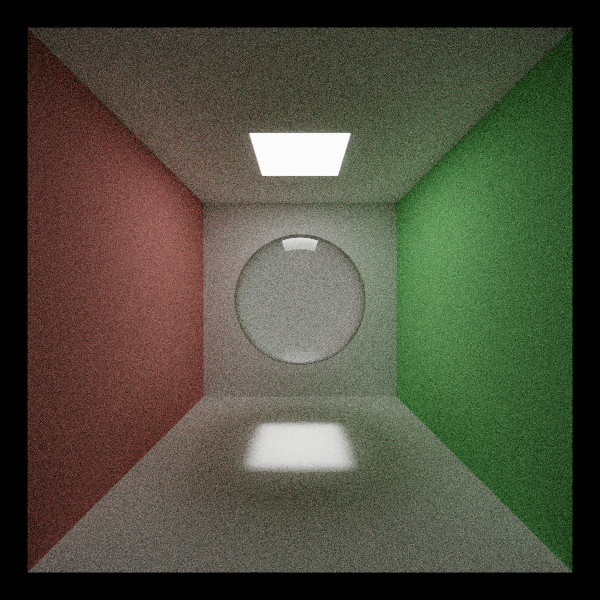
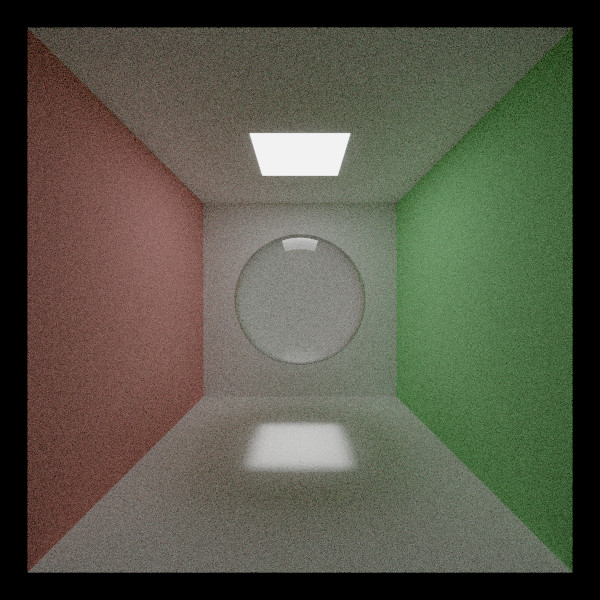
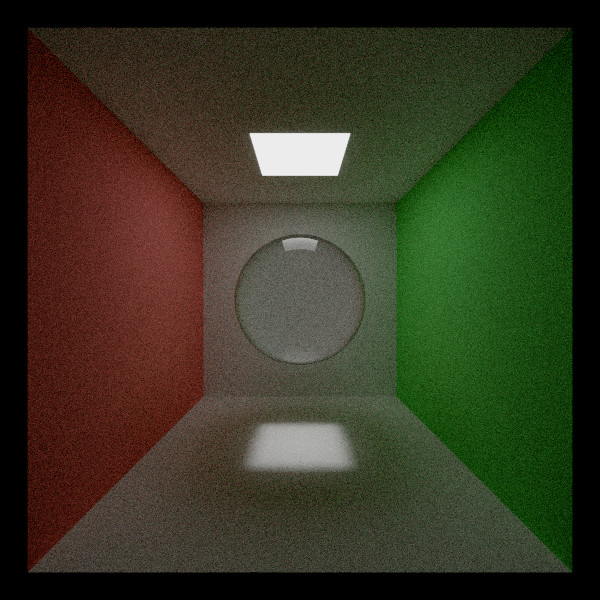
累积缓冲区始终保持场景线性,视图变换在显示和保存时走同一个函数,所以视口和 PNG 的结果一致。默认是 AgX punchy,来自 Benjamin Wrensch 基于 Troy Sobotka 的 AgX 所写的 Minimal AgX Implementation。ACES 提供 Krzysztof Narkowicz 的拟合和 Stephen Hill 的拟合(来自 MJP 的 BakingLab)。
Glass Cornell,600x600、1000 spp、曝光 1.0、DEPTH 8:
| ACES,Narkowicz 拟合 | ACES,Hill 拟合(1/0.6) |
|---|---|
 |  |
| AgX | AgX punchy |
 |  |
性能
设备端链接时优化
基础代码以 CUDA_SEPARABLE_COMPILATION ON 构建,在没有设备端链接时优化(device LTO)的情况下,来自其他文件的 __device__ 函数无法内联。cuobjdump --dump-sass 显示 boxIntersectionTest、sphereIntersectionTest 和 scatterRay 在核函数中都是真正的函数调用,参数要经过本地内存(local memory)传递。
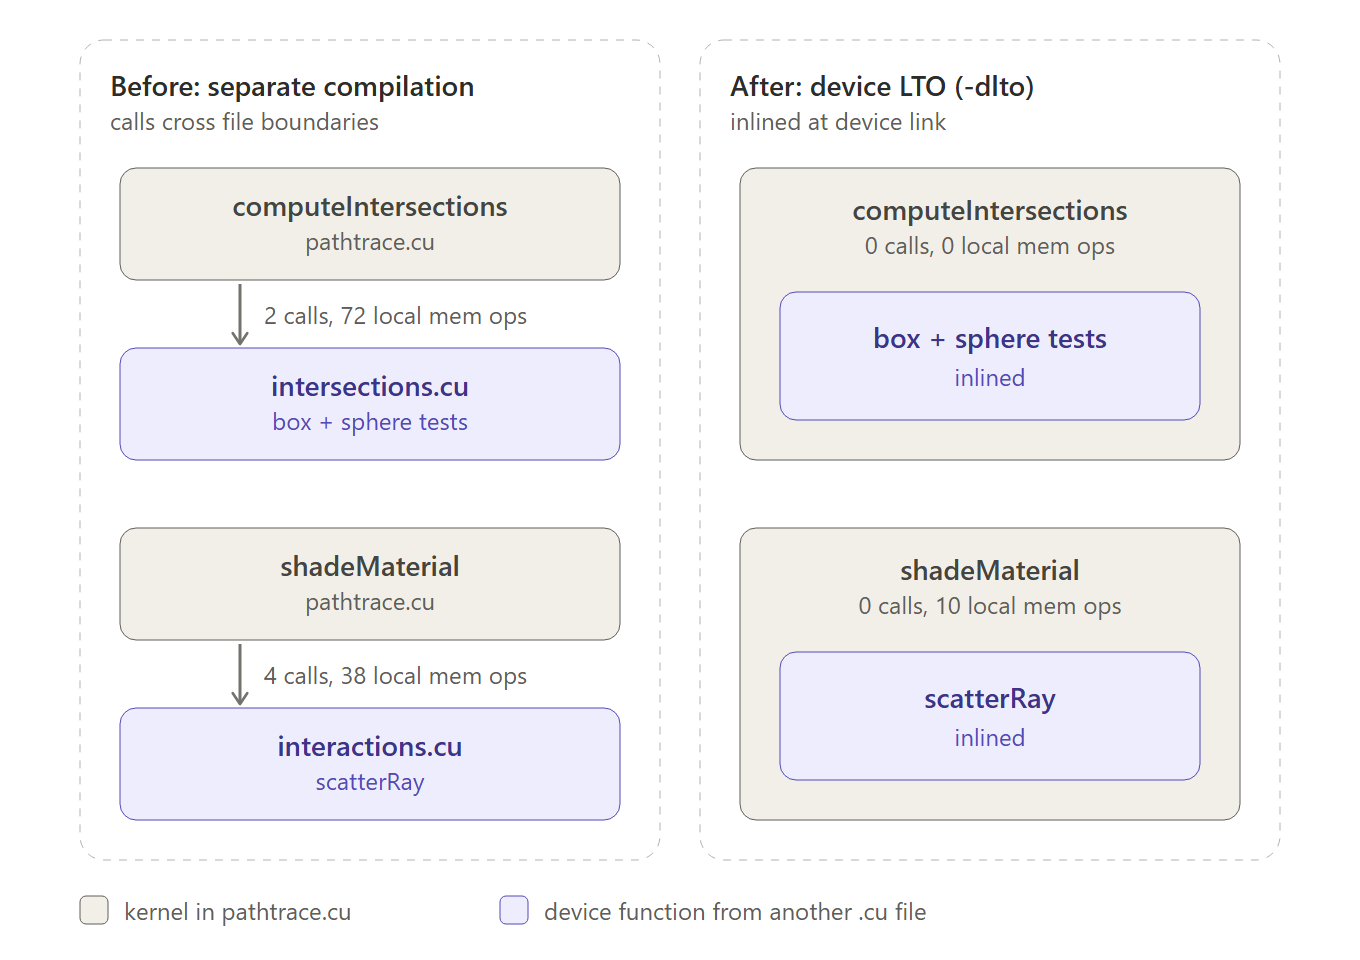
现在 Release 构建会在 CUDA 编译和设备链接选项中加入 -dlto。帧速度视分辨率提升了 25% 到 40%,代价是每次构建多出约 4 s 的设备链接时间。
压缩与排序:从 thrust 到 CUB,再加上设备端 LTO
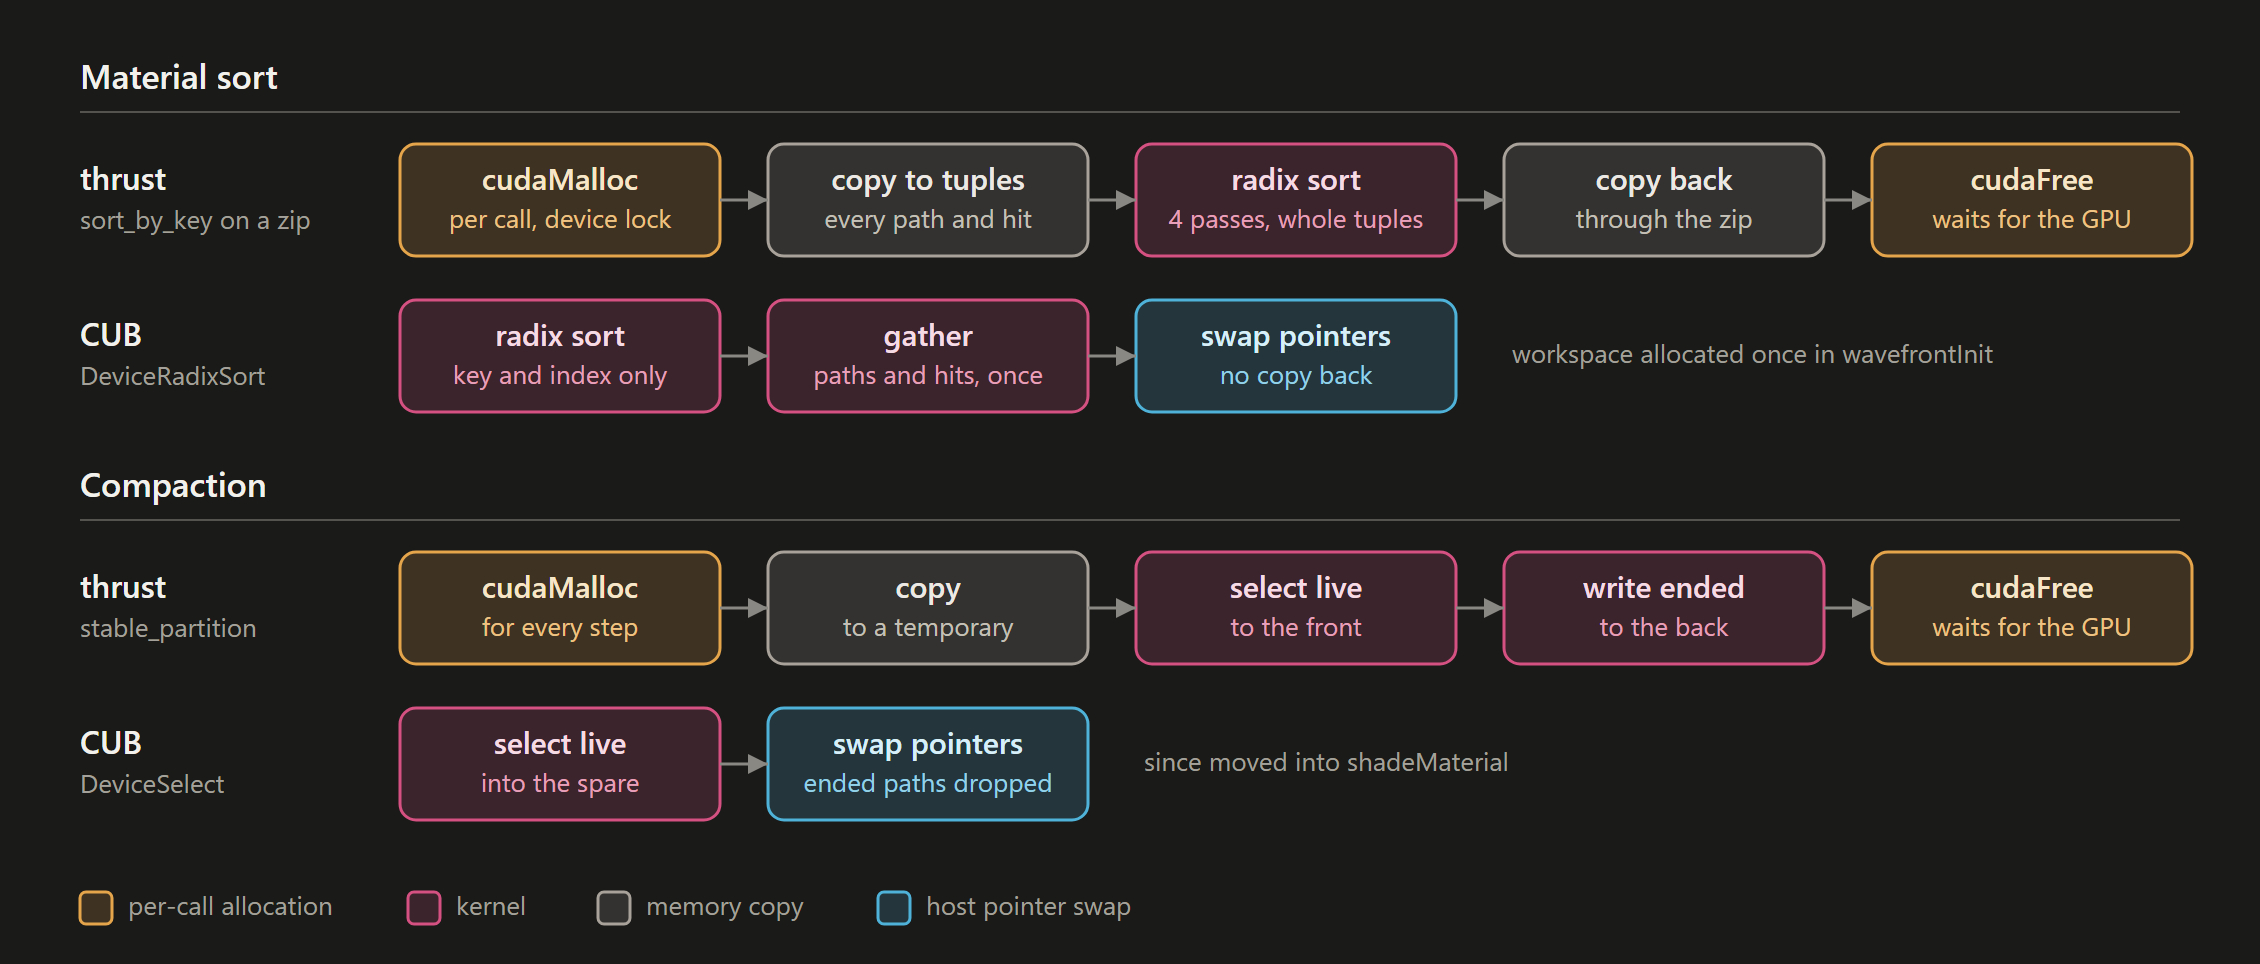
最初本渲染器用 thrust::stable_partition 做压缩,用 thrust::sort_by_key 做材质排序。开启排序时,400x400 下一个样本要 13 ms,对每个阶段计时后发现大部分帧时间都花在了排序上。
| 阶段 | 生成 | 求交 | 排序 | 着色 | 压缩 | 收集 |
|---|---|---|---|---|---|---|
| ms | 0.08 | 0.36 | 8.9 | 0.21 | 4.0 | 0.03 |
原因是 thrust::device 下的每次 thrust 调用都会用 cudaMalloc 分配临时内存,再用 cudaFree 释放,而 cudaFree 会等待所有未完成的 GPU 工作;此外,基于 zip 迭代器的 sort_by_key 在四轮基数排序中每轮都要复制每条路径。仅加一个缓存分配器就消除了这两个阶段 60% 到 70% 的耗时。CUB 版本只分配一次工作区,去掉了其余开销;它直接丢弃结束的路径,而不是把它们分区到末尾;并且只在材质数量所需的位上对(材质键,路径索引)对进行排序,最后做一次收集(gather)。
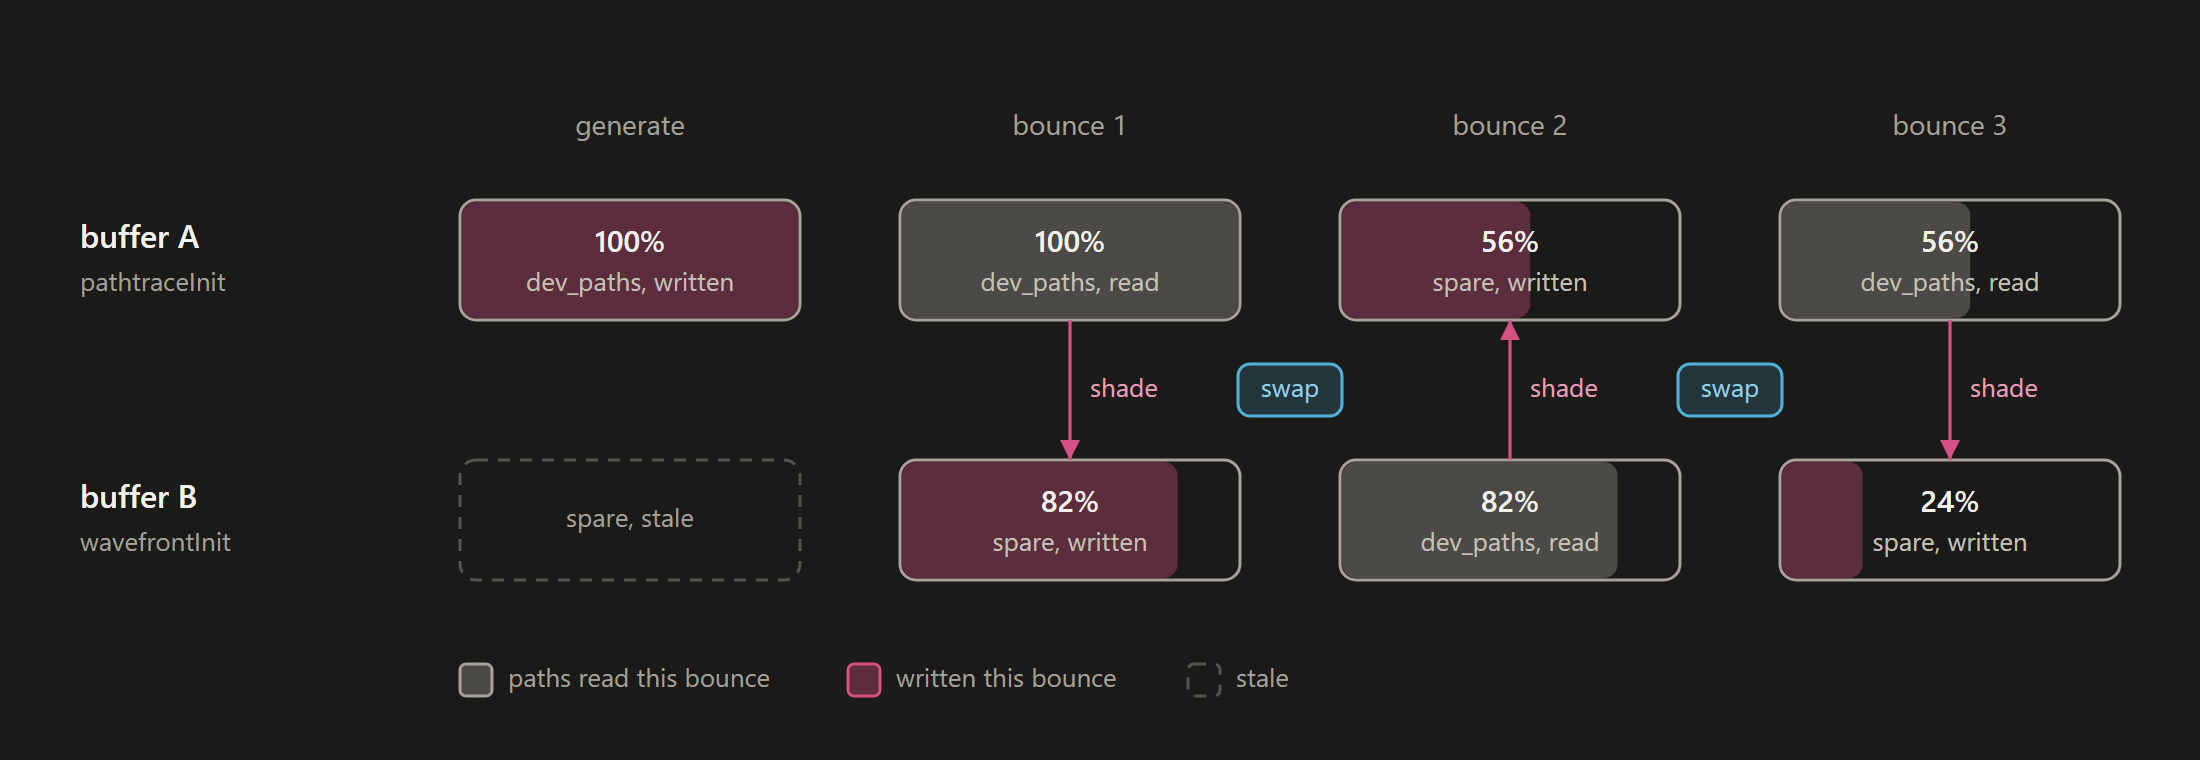
三次弹射中的缓冲区归属。每个条形代表一整个缓冲区,填充比例为存活路径的占比。
Cornell,5 次运行的中位数,每样本毫秒数。
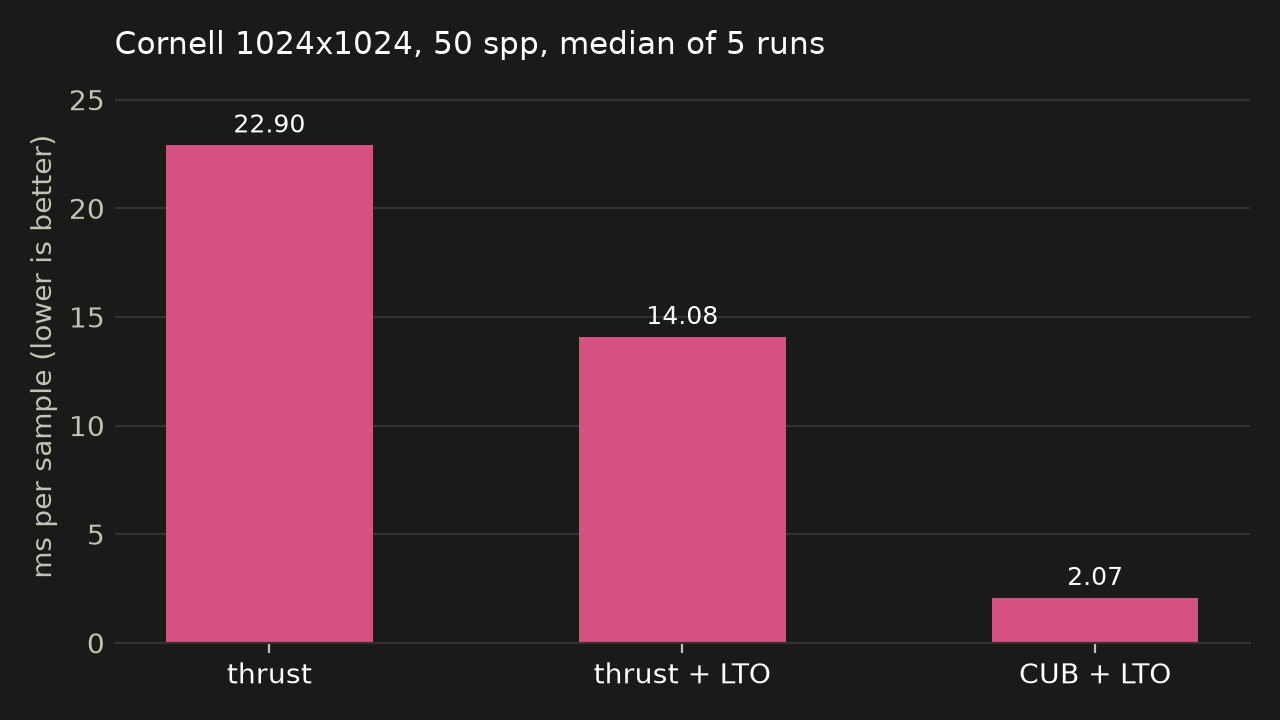
在 1024x1024 下,帧时间从每样本 22.90 ms 降到 2.07 ms,提升 11 倍。其中设备端 LTO 单独贡献了 1.6 倍。
把流压缩移进着色核函数
动机: 在 Cornell 1024x1024 的 Nsight Systems 性能分析中,CUB 压缩在 2.59 ms 的样本中占了 0.49 ms(19%;在 Intel Sponza 上为 6%)。它要读取 shadeMaterial 刚写入的每条路径,再把存活的路径写第二遍,并且每次弹射多出两次启动。
实现方式是 warp 聚合原子操作(warp-aggregated atomics)。shadeMaterial 把存活路径直接写入备用缓冲区。warp 先用 __ballot_sync 投票,0 号 lane 用一次 atomicAdd 为整个 warp 的存活路径预留空间,每条存活路径写到这个基址加上它在存活路径中的排名(__popc),因此写入保持合并(coalesced)。
1024x1024、100 spp,5 次运行的中位数,每样本毫秒数。
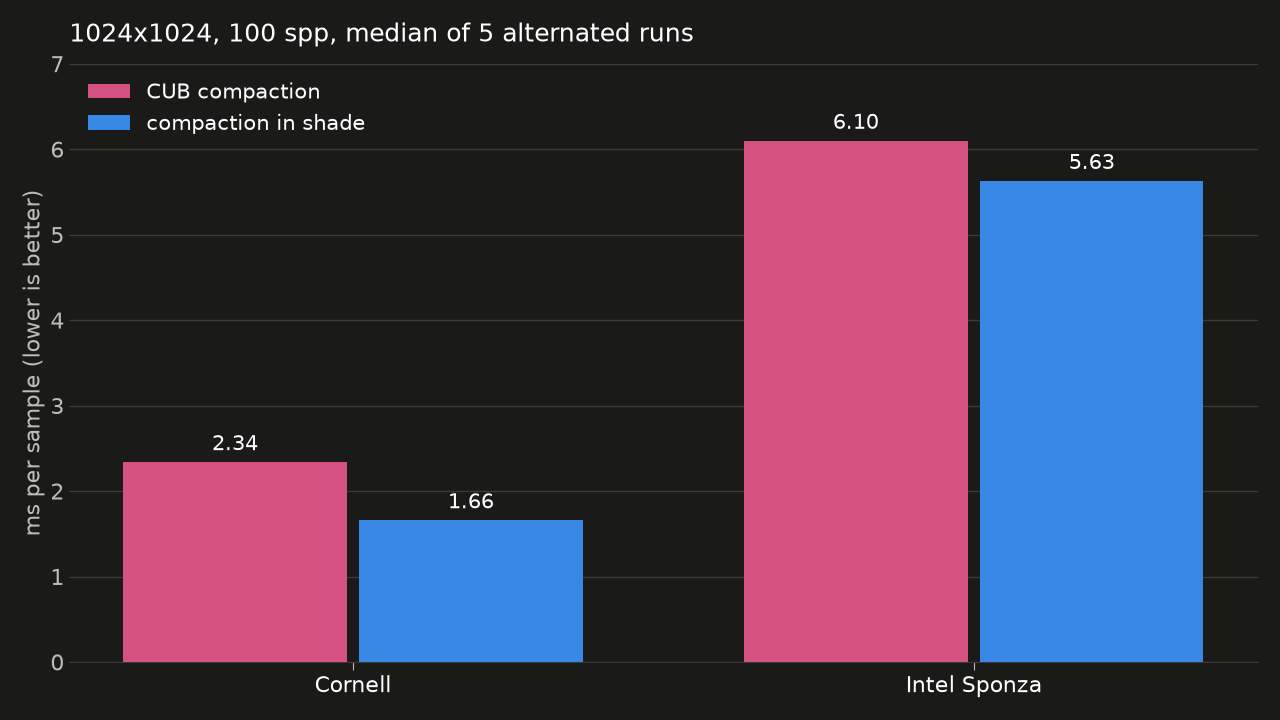
- 压缩核函数:没了,省下 0.49 ms。
shadeMaterial:从 0.67 降到 0.54 ms,因为它只写存活路径(到第 1 至第 3 次弹射时,已有 18% 到 50% 的路径结束)。单从字节数算约省 0.05 ms;其余收益从何而来我还没有研究。- 空闲时间:减少 0.10 ms,来自随压缩核函数一起消失的启动间隙。
把存活数量留在 GPU 上、而不是每次弹射都读回主机,在 Cornell 上只快了 0.07 ms,在 Intel Sponza 上快 0.1 到 0.2 ms,代价是要把整个样本提前排队给 GPU,并失去每次弹射的错误检查,所以我没有采用。
每次弹射的存活路径
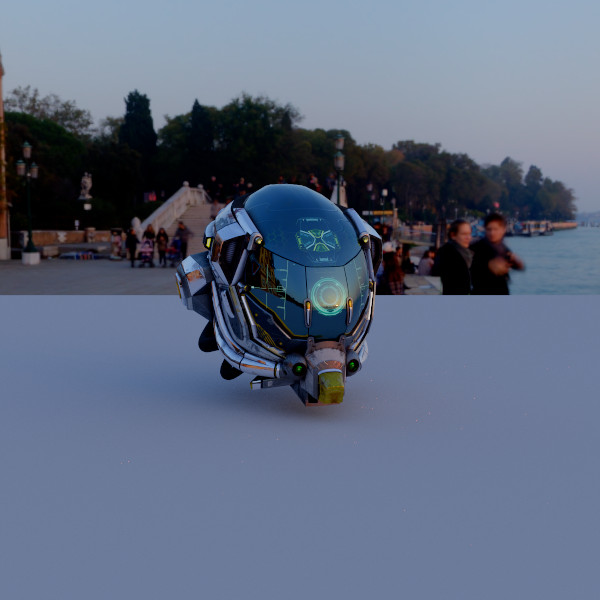
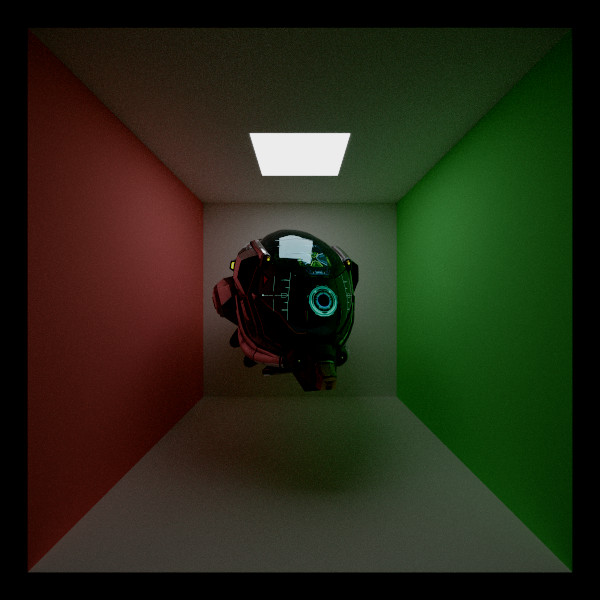
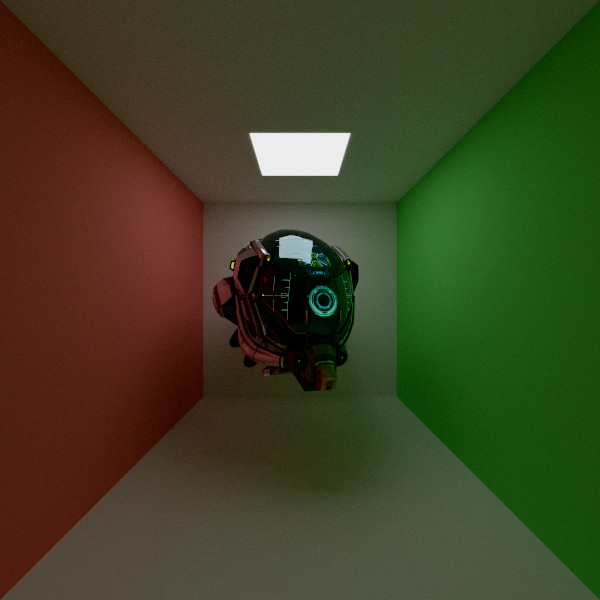
使用同一个 DamagedHelmet 的三个场景,从开放到封闭,1024x1024、DEPTH 8:HDRI 下平面上的头盔(helmet_plane.json)、正面敞开的标准 Cornell box(cornell_helmet.json),以及在相机后方加了第六面墙的封闭盒子(cornell_closed.json),其中路径只会在命中光源、被俄罗斯轮盘赌淘汰或达到 DEPTH 时结束。
| 平面上的头盔 | Cornell box,正面敞开 | 封闭 Cornell box |
|---|---|---|
 |  |  |
进入每次弹射时的存活路径,来自 --timing:
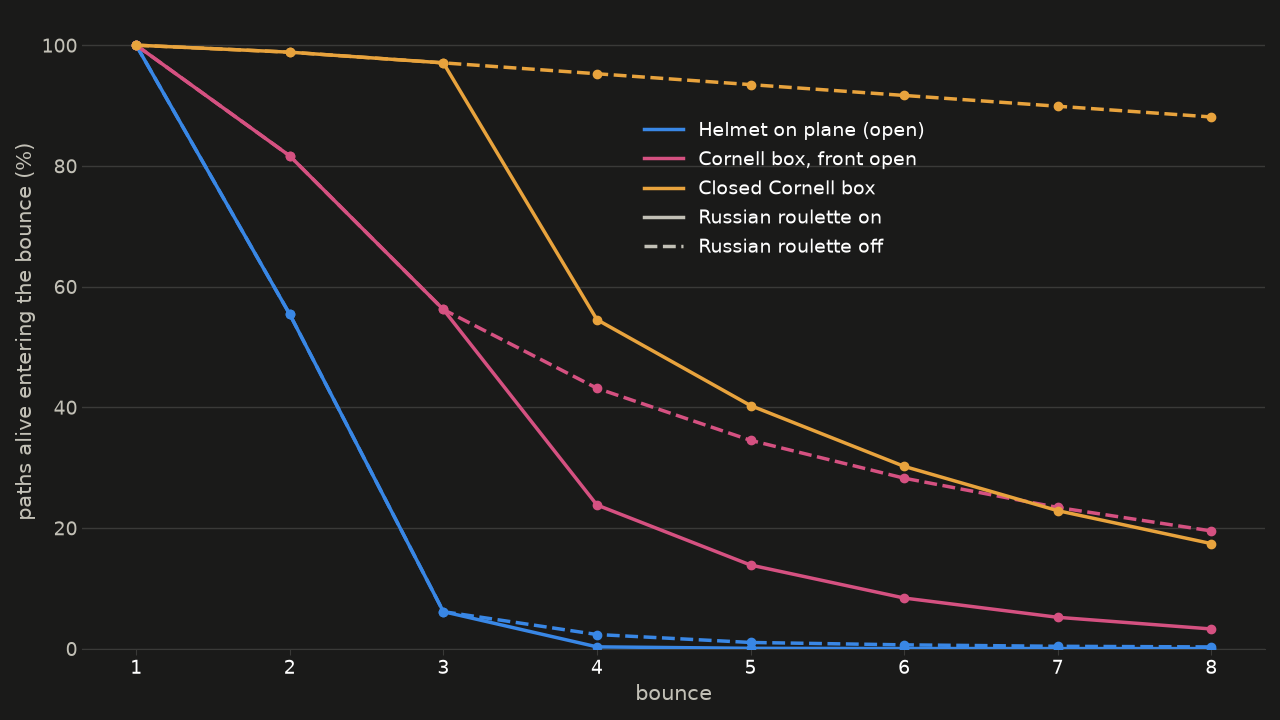
- 平面上的头盔:44.6% 的路径在第一次弹射就看到了天空,从平面弹出的光线大多也射向天空,所以到第 3 次弹射只剩 6.1%,俄罗斯轮盘赌几乎没有可淘汰的路径。
- Cornell box,正面敞开:没有俄罗斯轮盘赌时,每次弹射约有五分之一的路径从敞开的正面射出或命中光源而结束。开启后,剩余路径中有 58% 在第 3 次弹射结束,之后每次约 40%。
- 封闭 Cornell box:每次弹射只有 1% 到 2% 的路径结束,没有俄罗斯轮盘赌时,第 8 次弹射仍有 88% 存活。
开放与封闭场景
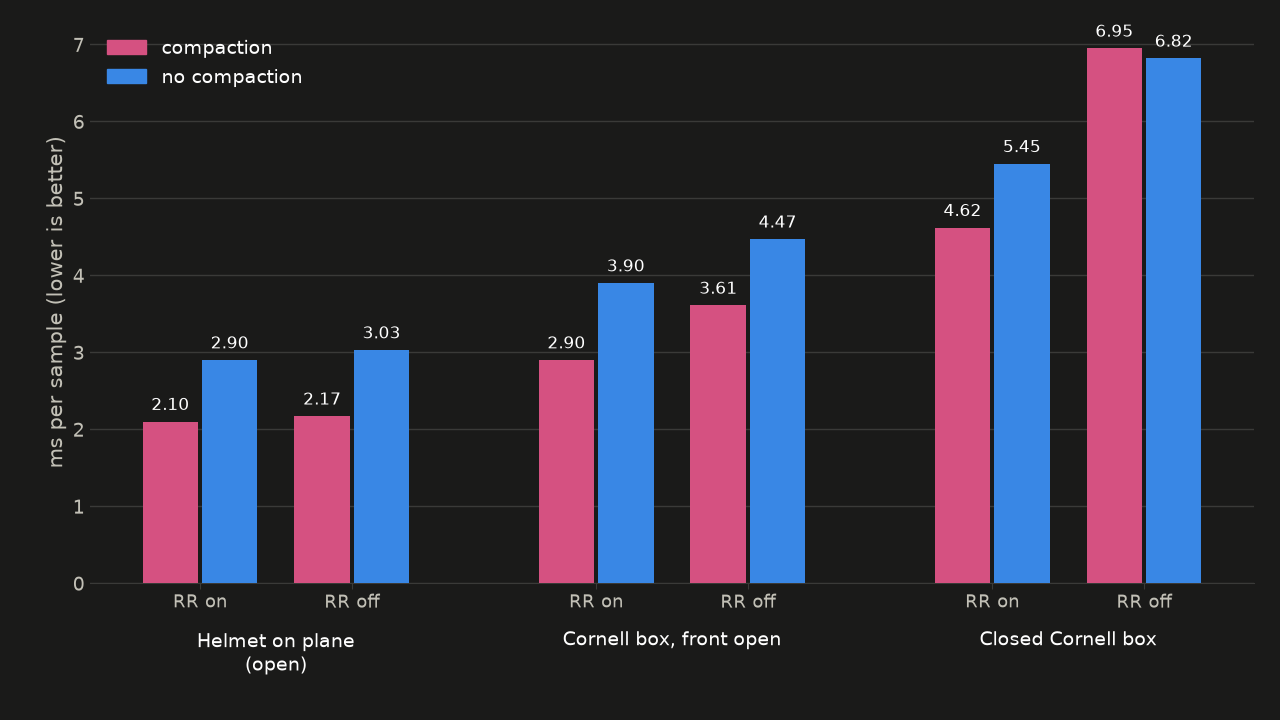
--no-compact 关闭压缩:每次弹射都对全部 1,048,576 条路径启动,核函数遇到已结束的路径会提前返回。两种模式渲染出相同的图像。
无界面,1024x1024、100 spp,5 次交替运行的中位数,每样本毫秒数:
开启俄罗斯轮盘赌时每次弹射的耗时,5 次 --timing 运行的中位数:
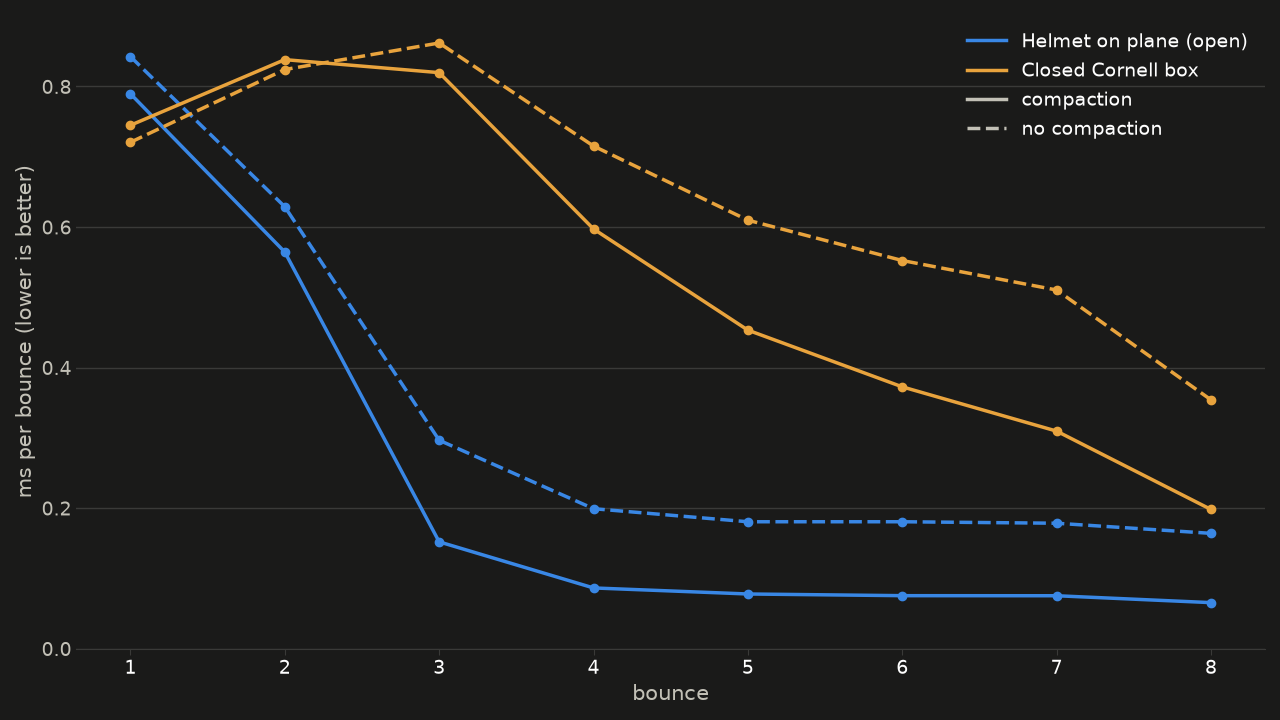
- 开放场景:压缩在平面头盔场景上节省 28%,在敞开的 Cornell box 中节省 26%。大部分路径结束后,一次压缩过的弹射约 0.08 ms(启动和数量读回),而全宽启动、线程加载路径后直接返回则约 0.18 ms。
- 封闭盒子:压缩只节省 15%,正好是俄罗斯轮盘赌淘汰掉的那部分。没有轮盘赌时反而慢 2%,因为它几乎什么都没丢弃,却仍要付出 warp 投票和原子操作的开销。
- 俄罗斯轮盘赌:在封闭盒子中节省 34%,在平面头盔场景上只节省 3%,因为那里很少有路径能活到轮盘赌开始的时候。
- 第 2 次弹射比第 1 次更贵,这发生在几乎所有路径都存活的封闭盒子中:相机光线朝相邻方向发出,而漫反射弹射光线不是,所以后者的遍历一致性更差。
俄罗斯轮盘赌
俄罗斯轮盘赌(Russian roulette,RR):从第三次弹射开始,路径以等于其通量(throughput)亮度的概率存活(最多 0.95),存活路径的通量再除以这个概率,从而保持估计无偏。--no-rr 可以关闭它。
无界面,3 次交错运行的中位数,每样本毫秒数。
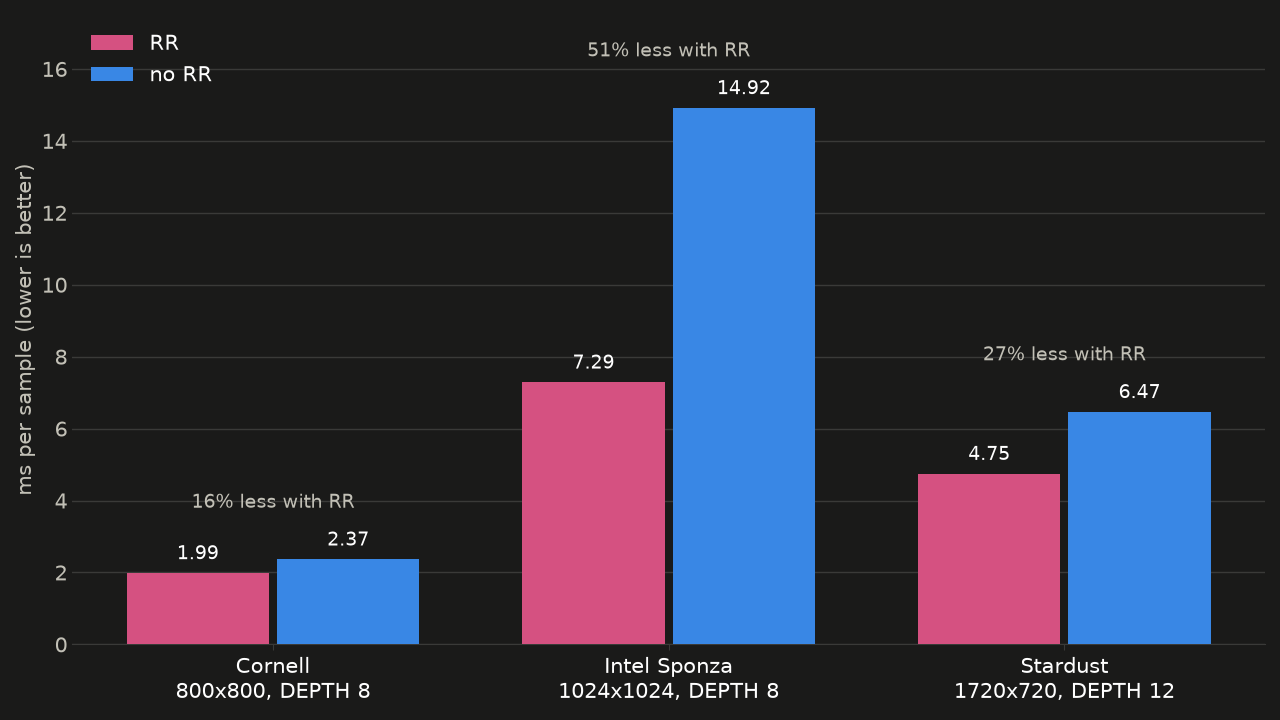
- 在第三次弹射结束的路径:Sponza 中开启 RR 为 96%,关闭为 17%。在暗色石材上弹射两次后,路径只剩百分之几的通量,所以大部分路径都赌输了。
- 噪声:在 512x512、256 spp 下,相对 8192 spp 无 RR 参考图的 RMSE,Sponza 中为 11.12 对 10.81(满值 255),Cornell 中为 4.94 对 4.23。按单位时间算,RR 在 Sponza 中的效率约为 1.6 倍,在 Cornell 中却只有约 0.85 倍。我猜是 Cornell 的白墙让被 RR 终止的路径仍保有大量通量,所以它引入的方差超过了它节省的 16% 时间。
材质排序
--sort 按路径命中的材质做基数排序,并在着色前按这个顺序收集路径,这样同一个 shadeMaterial warp 中的线程读取的是同一种材质。由于它性能更差,默认关闭。
无界面,1024x1024(Stardust 为 1720x720)、100 spp,每个条形来自一次 --timing 运行,按阶段统计每样本毫秒数:
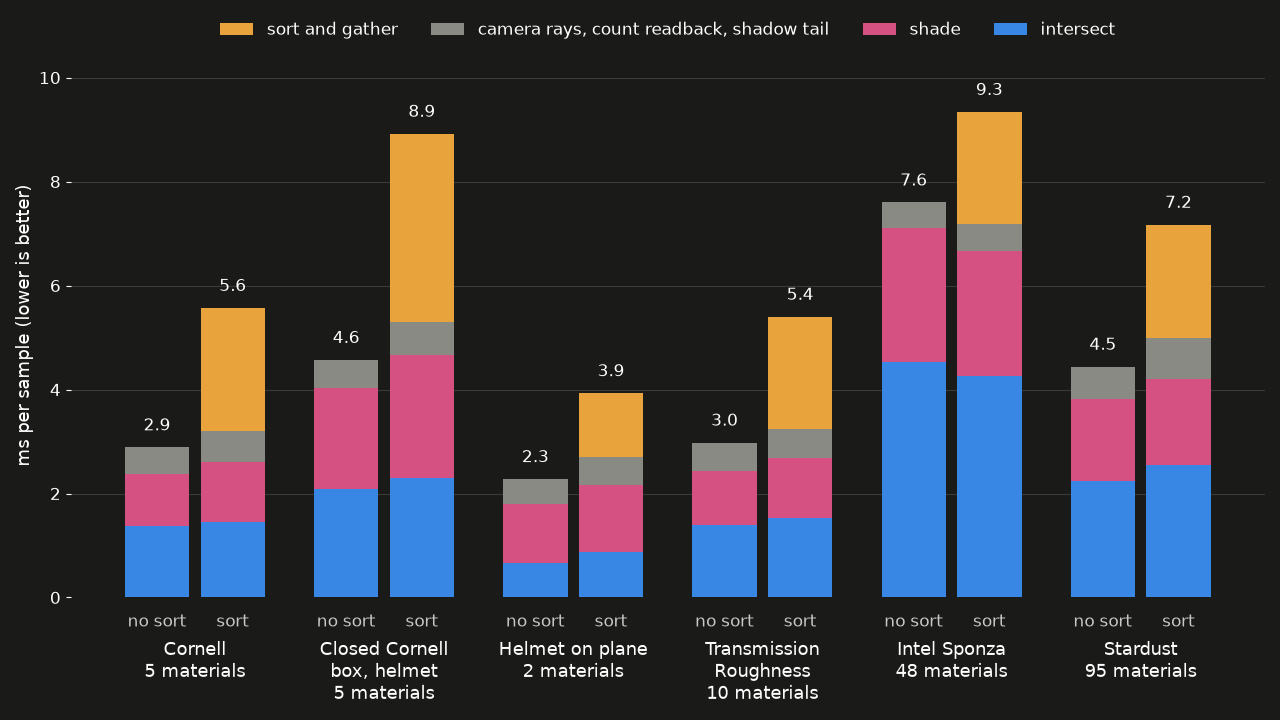
排序让每个场景都变慢 1.2 倍(Sponza)到 1.9 倍(Cornell),全部来自排序阶段。shadeMaterial 本身的变化最多 0.45 ms,而且只有拥有 48 种材质的 Sponza 变快了;只有少数几种材质的场景反而略微变慢。所有材质都走同一个 scatterPbr,路径采样哪个波瓣(lobe)是每条路径的随机选择,排不排序都一样,所以无论有多少种材质,排序能消除的分歧(divergence)都很少。我猜 Sponza 那一点收益来自排序后同一 warp 读取相同的纹理;我没有对此做性能分析。
为什么我的排序这么慢???
在 Nsight Compute 中用 warp 停顿采样(warp stall sampling)查看 glm 0.9.6 构建的 gatherByIndex 核函数,SASS 显示编译器把每个 pathsOut[i] = pathsIn[src] 变成了 3 对加载和存储,每个存储都依赖于它的加载。
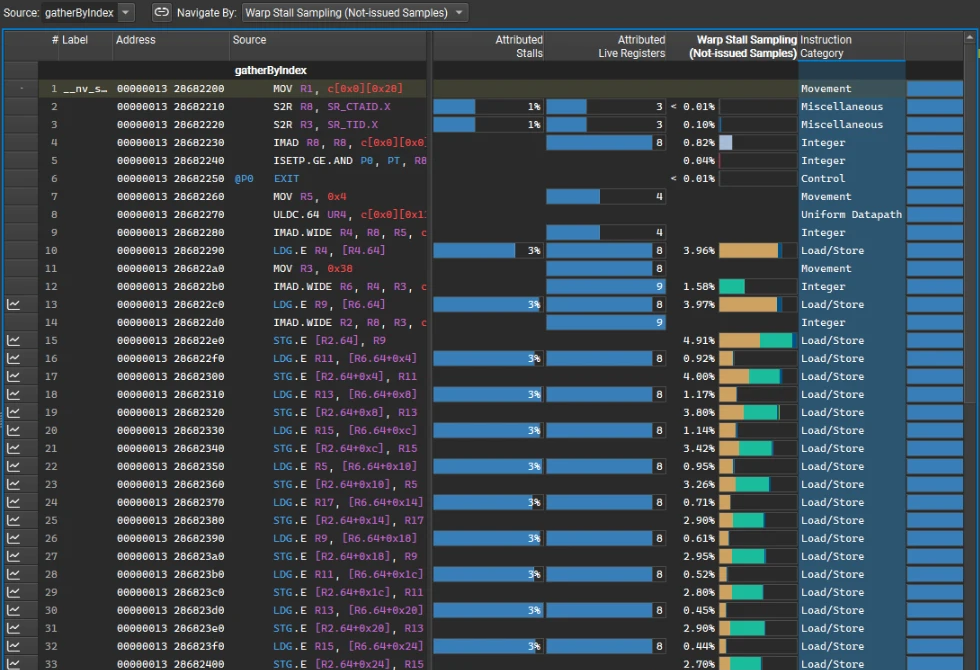
原因是基础代码使用的 glm 0.9.6 手写了向量的 operator=,这让每个包含 glm::vec3 的结构体都不再是平凡可复制(trivially copyable)的;同时编译器不知道两个 PathSegment* 指针是否重叠,无法重排加载和存储,只能保持原有顺序。
Nsight Compute 数据,gatherByIndex 核函数,glm 升级前后。
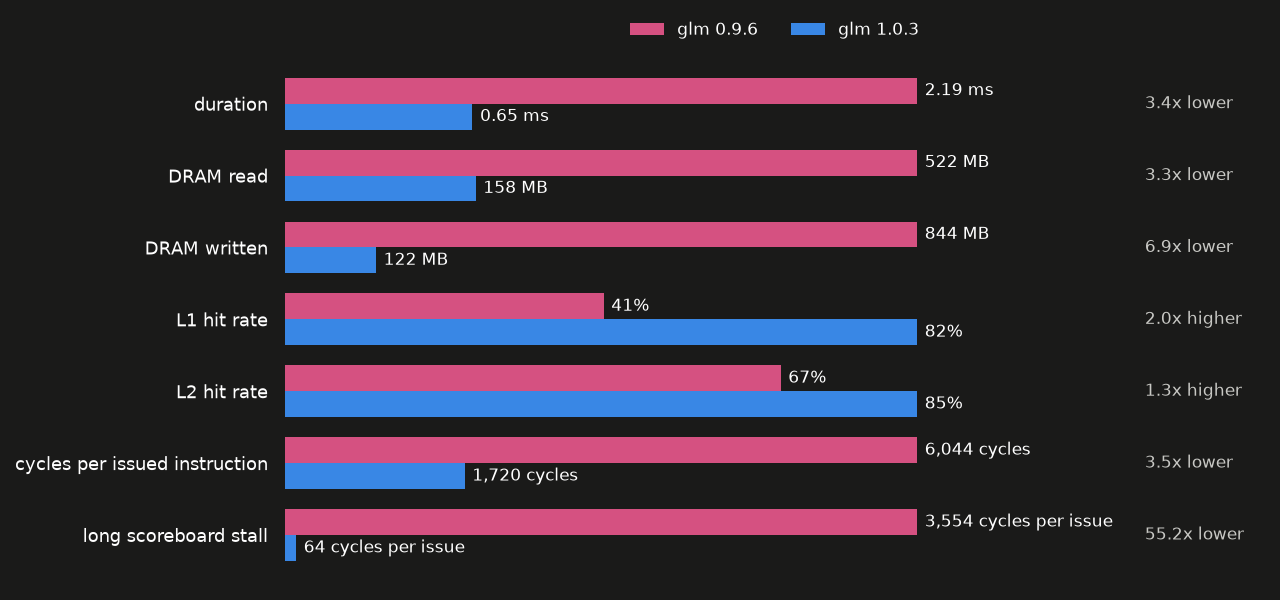
把 glm 升级到 1.0.3 后,其 operator= 为 = default,结构体重新变得平凡可复制,收集操作被编译成 29 次加载后接 29 次存储(在旧版 glm 下给指针加 __restrict__ 也能得到相同的代码)。核函数旁边的 static_assert 保证它一直如此。
无界面,1024x1024(Stardust 为 1720x720)、100 spp,每个条形来自一次 --timing 运行,统计每样本的排序阶段耗时:
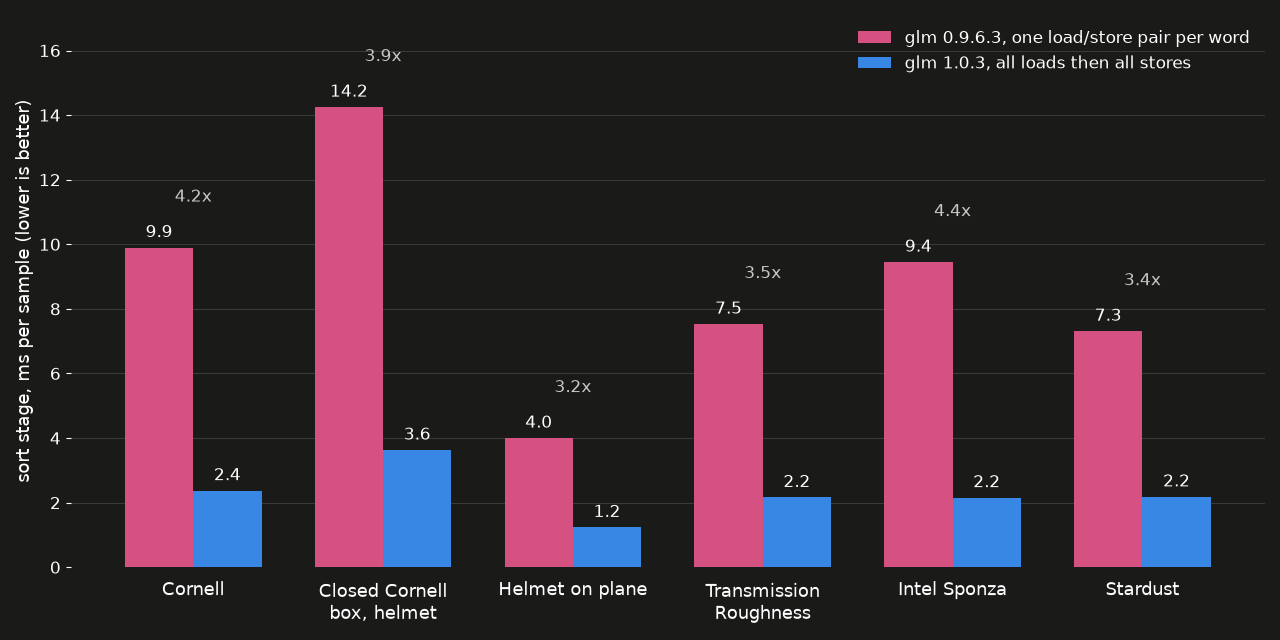
剩下的就是数据搬运本身的开销:排序后,一个 warp 的 32 个 lane 读取 32 个相距至少 56 字节的结构体,所以每次加载都会触及 32 个 sector,却只有 128 字节有用,开销约为连续复制的三倍。这比着色核函数获得的收益还多,所以排序保持关闭。
为什么排序在这里赢不了
有两点限制了排序能带来的收益。
- 排序唯一能做的是消除着色阶段的分歧,但排序本身的开销实打实地比着色还高。即使把分歧全部消除,也弥补不了。
- warp 分歧的来源并不是
materialID。shadeMaterial会根据未命中或命中分支,但未命中的路径反正会在下一阶段被压缩掉。然后在scatterPbr内部,warp 在采样哪个波瓣上产生分歧:清漆、金属、玻璃等等。每一次选择都是拿一个随机数和某个材质参数比较。即使是没有混合的材质,比如粗糙度 0、金属度 1,specularFactor仍然会按菲涅尔比例在清漆和漫反射基础层之间混合,从而引入分歧。
materialID 排序真正能赢的是纹理采样,这大概也是 Sponza 和 Stardust 这类纹理密集的场景能在着色上挽回一点点性能的原因。
除非材质求值变得非常复杂(比如 Blender 里复杂的着色节点图),我认为材质排序在这个路径追踪器里永远不会划算。
一路上的问题与翻车
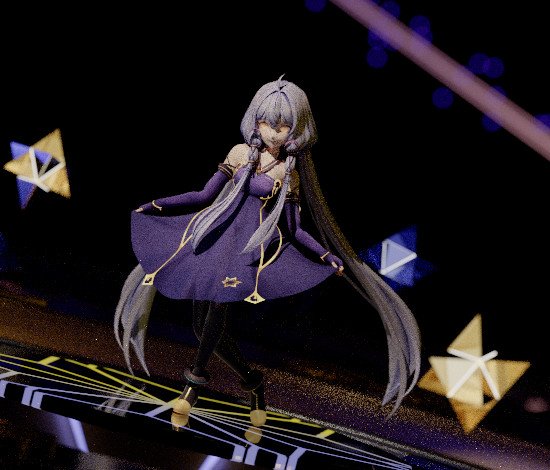
单张选取表的灯光链接让角色满是亮斑
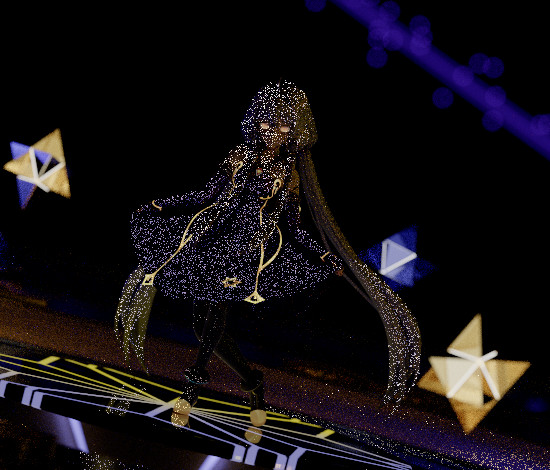
灯光链接的第一个版本保留了唯一的全局选取表,并丢弃接收者没有链接到所选光源的样本。在 Stardust 中,一盏非常亮的灯被设置为不照射角色,而照亮角色的是一盏暗得多的聚光灯,所以角色 99% 的光源选取都被丢弃了。少数选中聚光灯的样本各自带着完整的贡献除以一个极小的概率,于是出现了亮斑。按掩码划分的选取表在角色的表中给那盏亮灯的概率为 0,同样 2048 spp 的渲染就干净了。
角色裁剪,1 倍,2048 spp:
| 一张全局选取表 | 每个接收者掩码一张表 |
|---|---|
 |  |
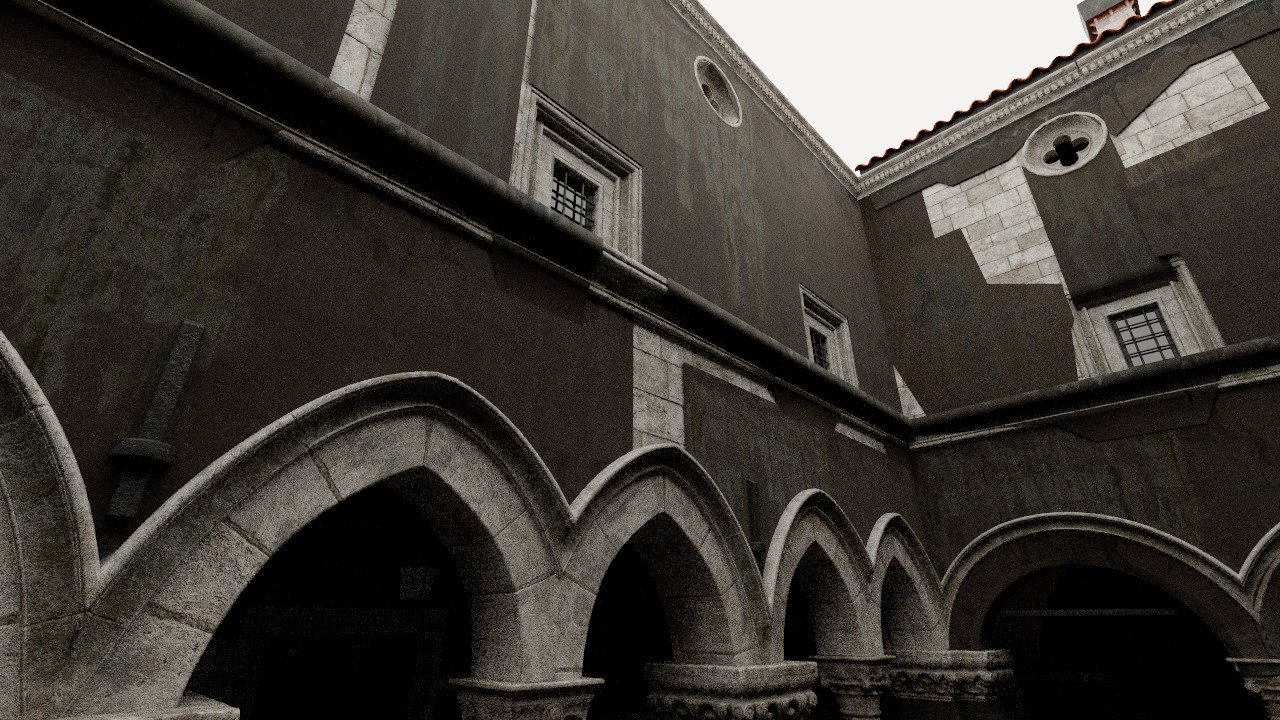
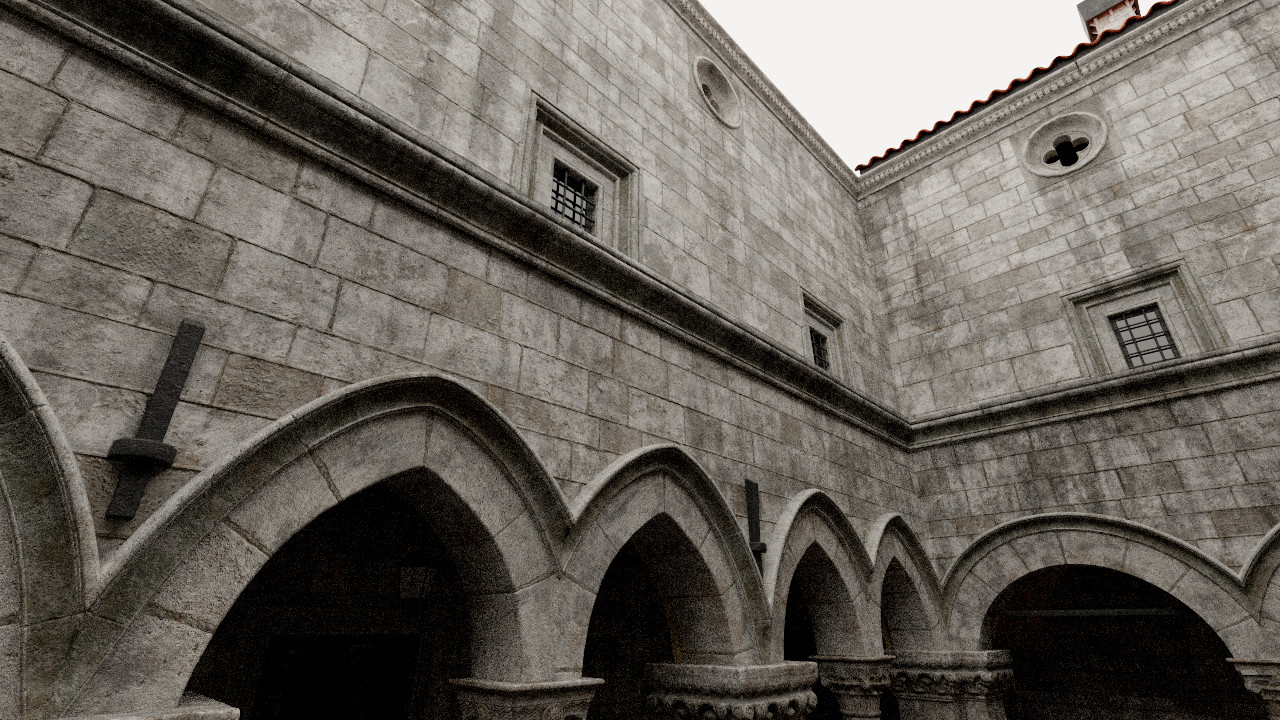
Sponza 的污渍贴花被渲染成实心墙面
Intel Sponza 的墙面带有一个 alphaMode: BLEND 的 dirt_decal 材质,而加载器把它当作不透明处理,于是深色污垢纹理盖住了墙面。现在 BLEND 命中以 alpha 的概率生效,概率取自像素、迭代次数、深度和三角形的哈希,因此两条求交路径会做出相同的判定。
| BLEND 按不透明处理 | BLEND 按覆盖率处理 |
|---|---|
 |  |
glm 1.0 在设备端被编译成了垃圾
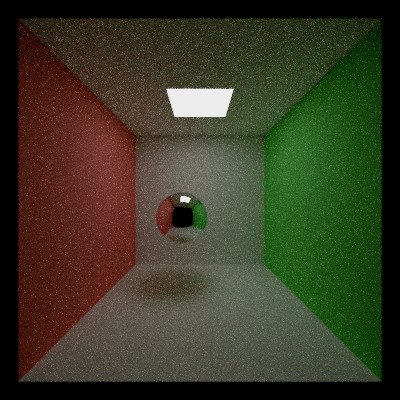
第一次用 glm 1.0.3 构建时(为什么要升级),每个场景都渲染成全黑,两条求交路径上的每条路径都在第一次弹射时结束。glm 1.0 通过 std::plus、std::multiplies 等 constexpr 主机函数来实现向量运算,而 nvcc 13.3 在没有设置 --expt-relaxed-constexpr 时不会从设备代码调用它们。它不报错,而是对每个实例化打印 warning #20013,然后把调用编译成空:在 GPU 上,glm::vec3(1, 2, 3) * 2.f 返回 (1, 2, 0),glm::dot 返回 NaN,所以每条相机光线都没有命中。现在每条 nvcc 命令都加上了这个标志,包括 OptiX IR 那条。升级后的渲染与旧版只有浮点漂移的差异:个别像素差一个色阶,以及少数萤火虫(firefly)噪点因为某个分支在最后一位上翻转而换了位置。
| 未加标志的 glm 1.0.3 | 加上 --expt-relaxed-constexpr |
|---|---|
 |  |
Schlick 在出射时用错了余弦
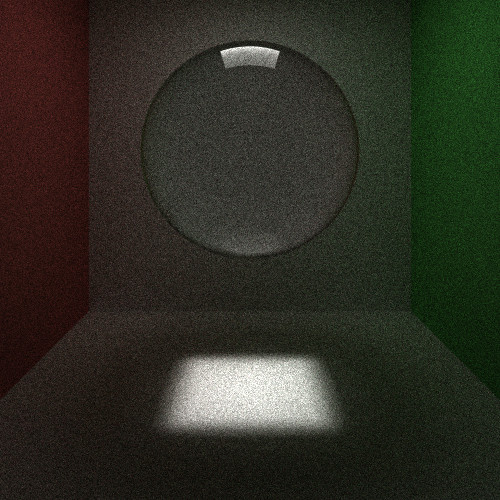
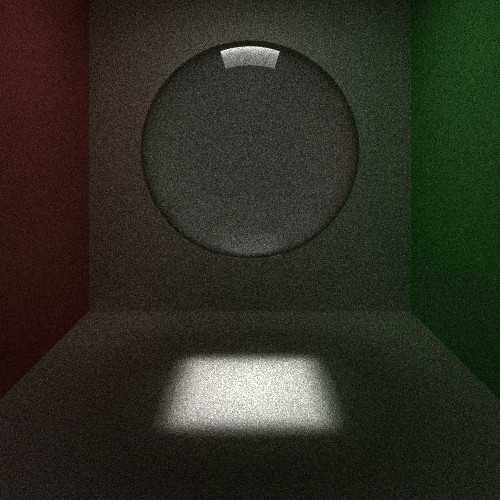
Schlick 近似需要的是界面空气一侧的余弦,对于离开玻璃的光线来说就是透射角。基础代码用的是入射角,所以反射率要到 90° 才达到 100%,而不是在临界角(IOR 1.5 时约 42°),刚好低于临界角的出射光线会漏出去,而不是反射回内部。修复后使用透射余弦,并把 k < 0 视为全内反射。
1000x1000、500 spp、DEPTH 8,裁剪到球体:
| 修复前 | 修复后 |
|---|---|
 |  |
像素差异,放大 8 倍:
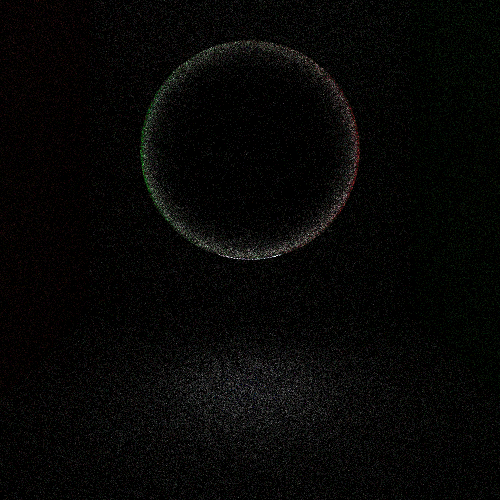
修复后的图像在边缘略暗:那部分光现在会在内部多弹射几次,而在深度 8 时其中一些路径触到了上限。有趣的是,把 DEPTH 提高到 32 会让球体明显变亮,远超这个 bug 的影响,所以玻璃确实需要比漫反射高得多的深度。
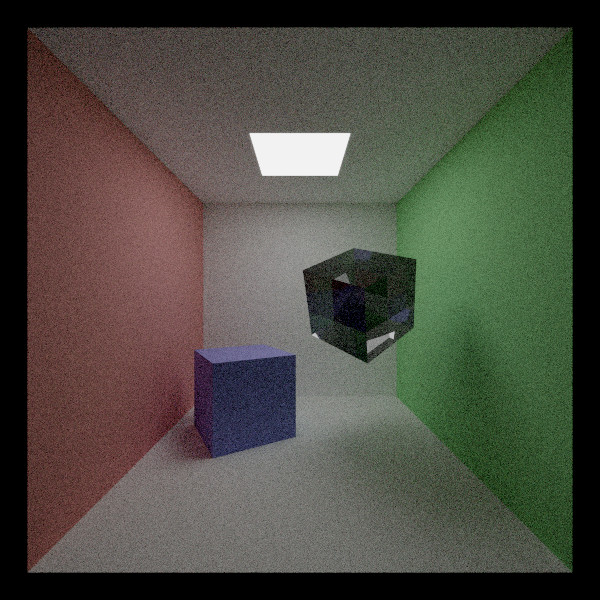
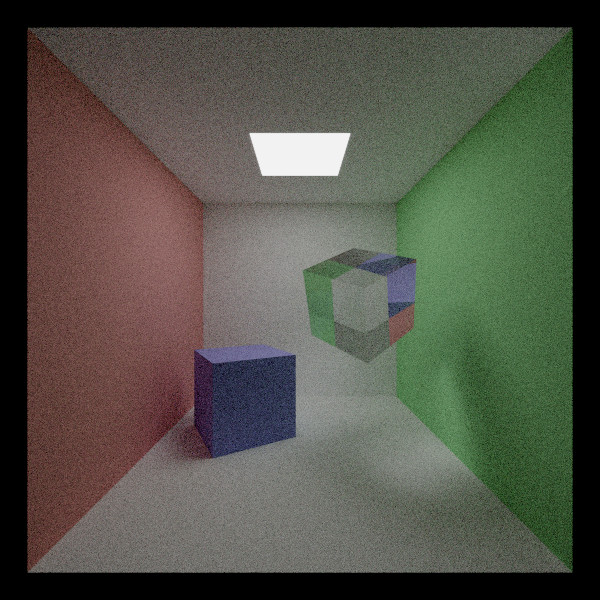
OptiX 立方体在出射命中时保留了朝外的法线
OptiX 立方体的命中程序在出射命中时返回面的朝外法线,而朴素的 boxIntersectionTest 返回的是朝向光线的法线。Cornell 中没有任何光线从立方体内部出发,所以直到一个玻璃立方体在 OptiX 下变暗,问题才暴露出来。在内部分支上翻转一次符号就修好了。
600x600、1000 spp、DEPTH 8、AgX、OptiX:
| 出射时朝外的法线 | 朝向光线的法线 |
|---|---|
 |  |
基础代码中的小修复
- 每次移动相机都会释放并重新分配所有设备缓冲区。 现在缓冲区只分配一次;相机变化时清空图像。
- 累积缓冲区每次迭代都被复制到主机,只为了让 S 键随时能保存。现在复制只在保存时进行。
- CUDA 出错时会先等待
getchar()再退出,这会让无界面运行卡住。已删除。
致谢
测试资产
| 模型 | 三角形 | 来源 |
|---|---|---|
| Box | 12 | Cesium,2017,CC BY 4.0 |
| Duck | 4,212 | Sony,2006,SCEA Shared Source License 1.0 |
| Suzanne | 3,936 | Norbert Nopper / UX3D,2017,CC0 |
| DamagedHelmet | 15,452 | theblueturtle_,2016,CC BY-NC 4.0;glTF 重建:ctxwing,2018,CC BY 4.0 |
| Sponza | 262,267 | Crytek(Frank Meinl),CryENGINE Limited License Agreement,glTF 转换版本来自 Khronos 仓库 |
| TransmissionRoughnessTest | 77,792 | Ed Mackey,Analytical Graphics,2021,CC BY 4.0 |
| DragonAttenuation | 134,995 | 龙:Stanford Computer Graphics Laboratory,1996,由 Morgan McGuire 于 2017 年转换,Stanford Graphics Library license;布料背景:Adobe,CC0 |
| ClearCoatTest | 37,116 | Ed Mackey,Analytical Graphics,2020,CC BY 4.0 |
| Intel Sponza(主体与窗帘) | 3,747,018 + 1,997,366 | Frank Meinl 与 Anton Kaplanyan,Intel,2022,CC BY 4.0;窗帘扩展由 Sponza Addon Package Crew 制作 |
| Bistro exterior | 2,829,226 | Amazon Lumberyard,2017 年 7 月,CC BY 4.0 |
| Bistro interior | 1,043,077 | Amazon Lumberyard,2017 年 7 月,CC BY 4.0 |
模型来自 Khronos glTF-Sample-Assets、Intel Sample Library 和 NVIDIA’s Open Research Content Archive。
第三方代码
tinygltf 2.9.7(MIT)、MikkTSpace(zlib)、tinyexr 1.0.13(BSD-3-Clause)、OptiX 9.1.0、stb_image 2.30、CUDA 13.3 自带的 Thrust 和 CUB,以及 glm 1.0.3。GLFW、GLEW、nlohmann/json、Dear ImGui 和 stb_image_write 来自基础代码。
参考文献
- Veach 1997:Eric Veach,Robust Monte Carlo Methods for Light Transport Simulation,博士论文,Stanford University,1997。
- Walter et al. 2007:Bruce Walter、Stephen R. Marschner、Hongsong Li、Kenneth E. Torrance,“Microfacet Models for Refraction through Rough Surfaces”,Eurographics Symposium on Rendering 2007。
- Dupuy and Benyoub 2023:Jonathan Dupuy、Anis Benyoub,“Sampling Visible GGX Normals with Spherical Caps”,High-Performance Graphics 2023。
- Karlík et al. 2019:Ondřej Karlík、Martin Šik、Petr Vévoda、Tomáš Skřivan、Jaroslav Křivánek,“MIS Compensation: Optimizing Sampling Techniques in Multiple Importance Sampling”,ACM Transactions on Graphics 38(6),SIGGRAPH Asia 2019。
- PBRT-v4:Matt Pharr、Wenzel Jakob、Greg Humphreys,Physically Based Rendering: From Theory to Implementation,第 4 版,MIT Press 2023。
工具
CUDA, OptiX, C++, OpenGL, GLFW, Dear ImGui, CUB, CMake