CUDA ハードウェア RT パストレーサー
NEE + MIS、ライトリンク、物理ベースカメラに対応したウェーブフロント型 GPU レンダラー
概要
CUDA と OptiX ハードウェアレイトレーシングで実装したウェーブフロント型パストレーサー(wavefront path tracer)。ペンシルベニア大学 CIS 5650「GPU Programming and Architecture」の課題(Project 3)として制作。
ソースコードは GitHub にて公開。テスト環境:Windows 11、AMD Ryzen 5950X @ 4.3GHz(PBO 有効)、64GB RAM(3200 MT/s)、RTX 3090 24GB。
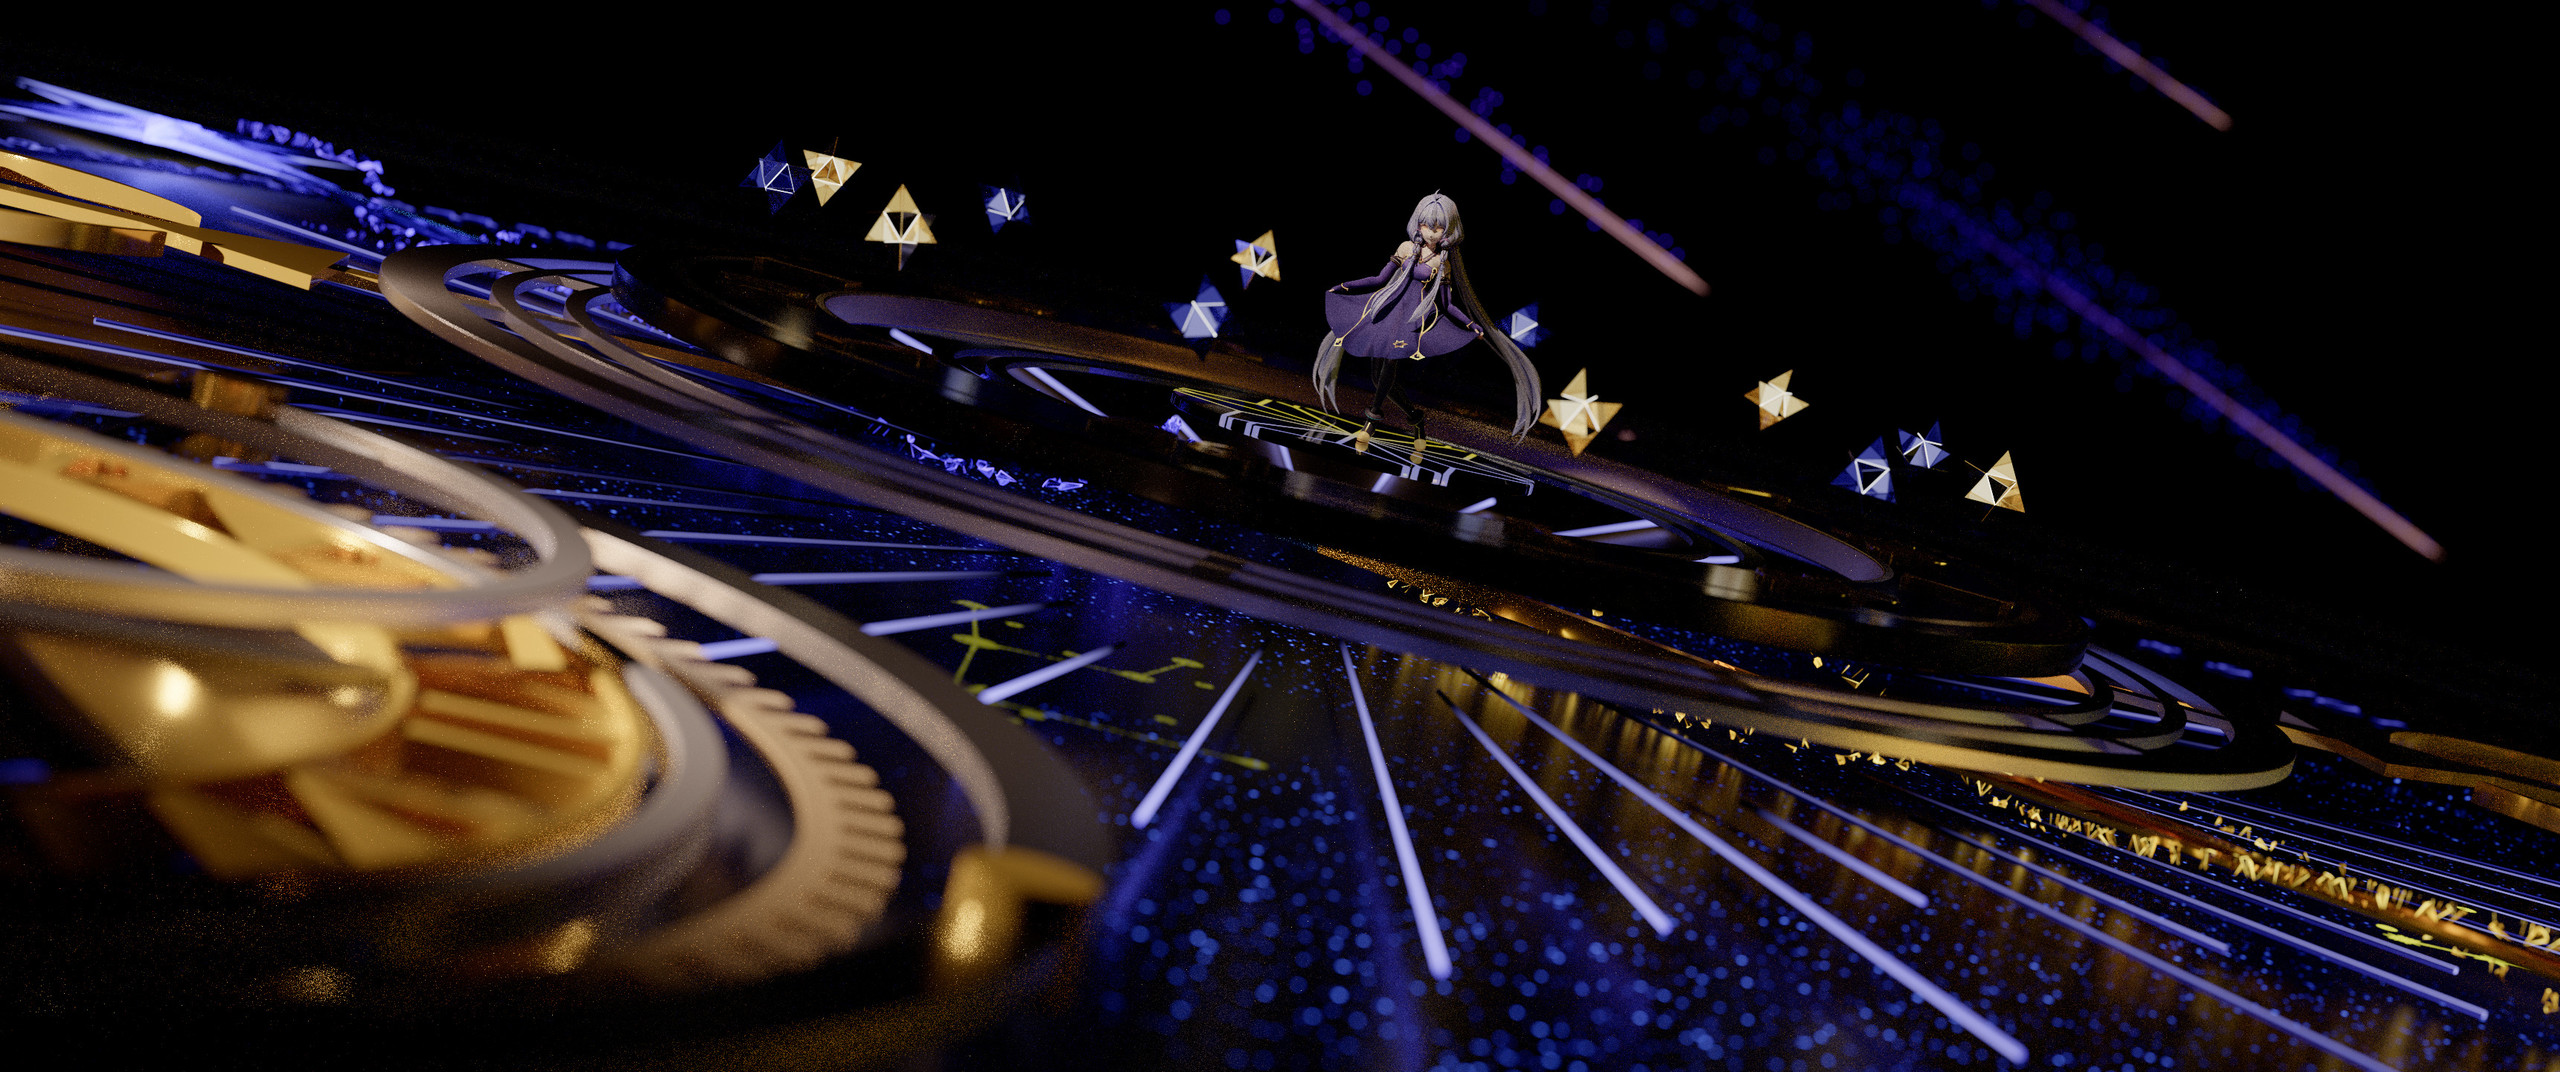
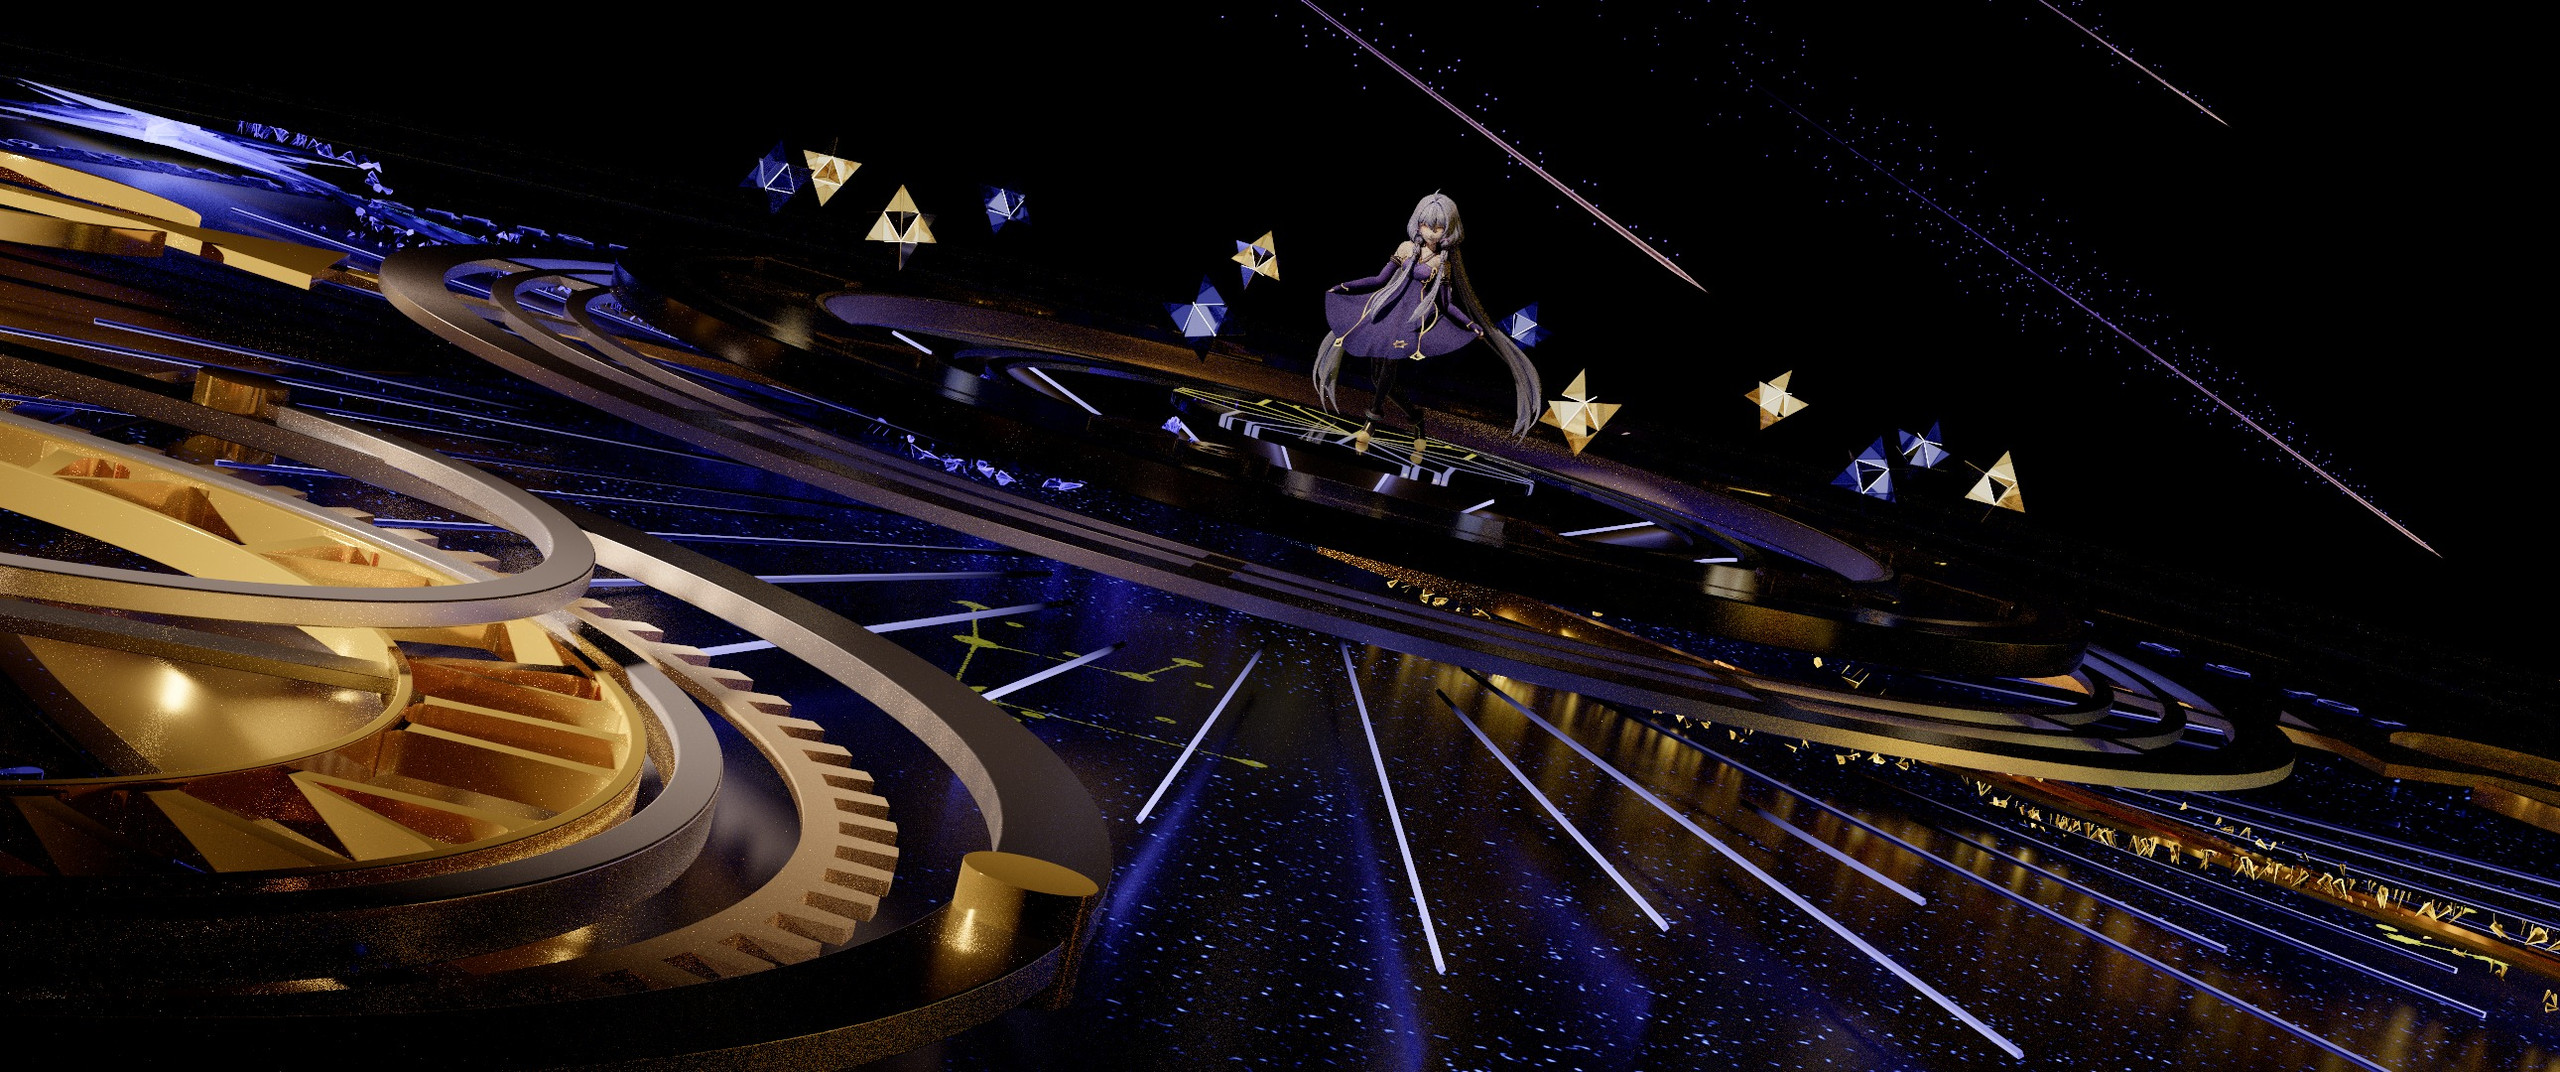
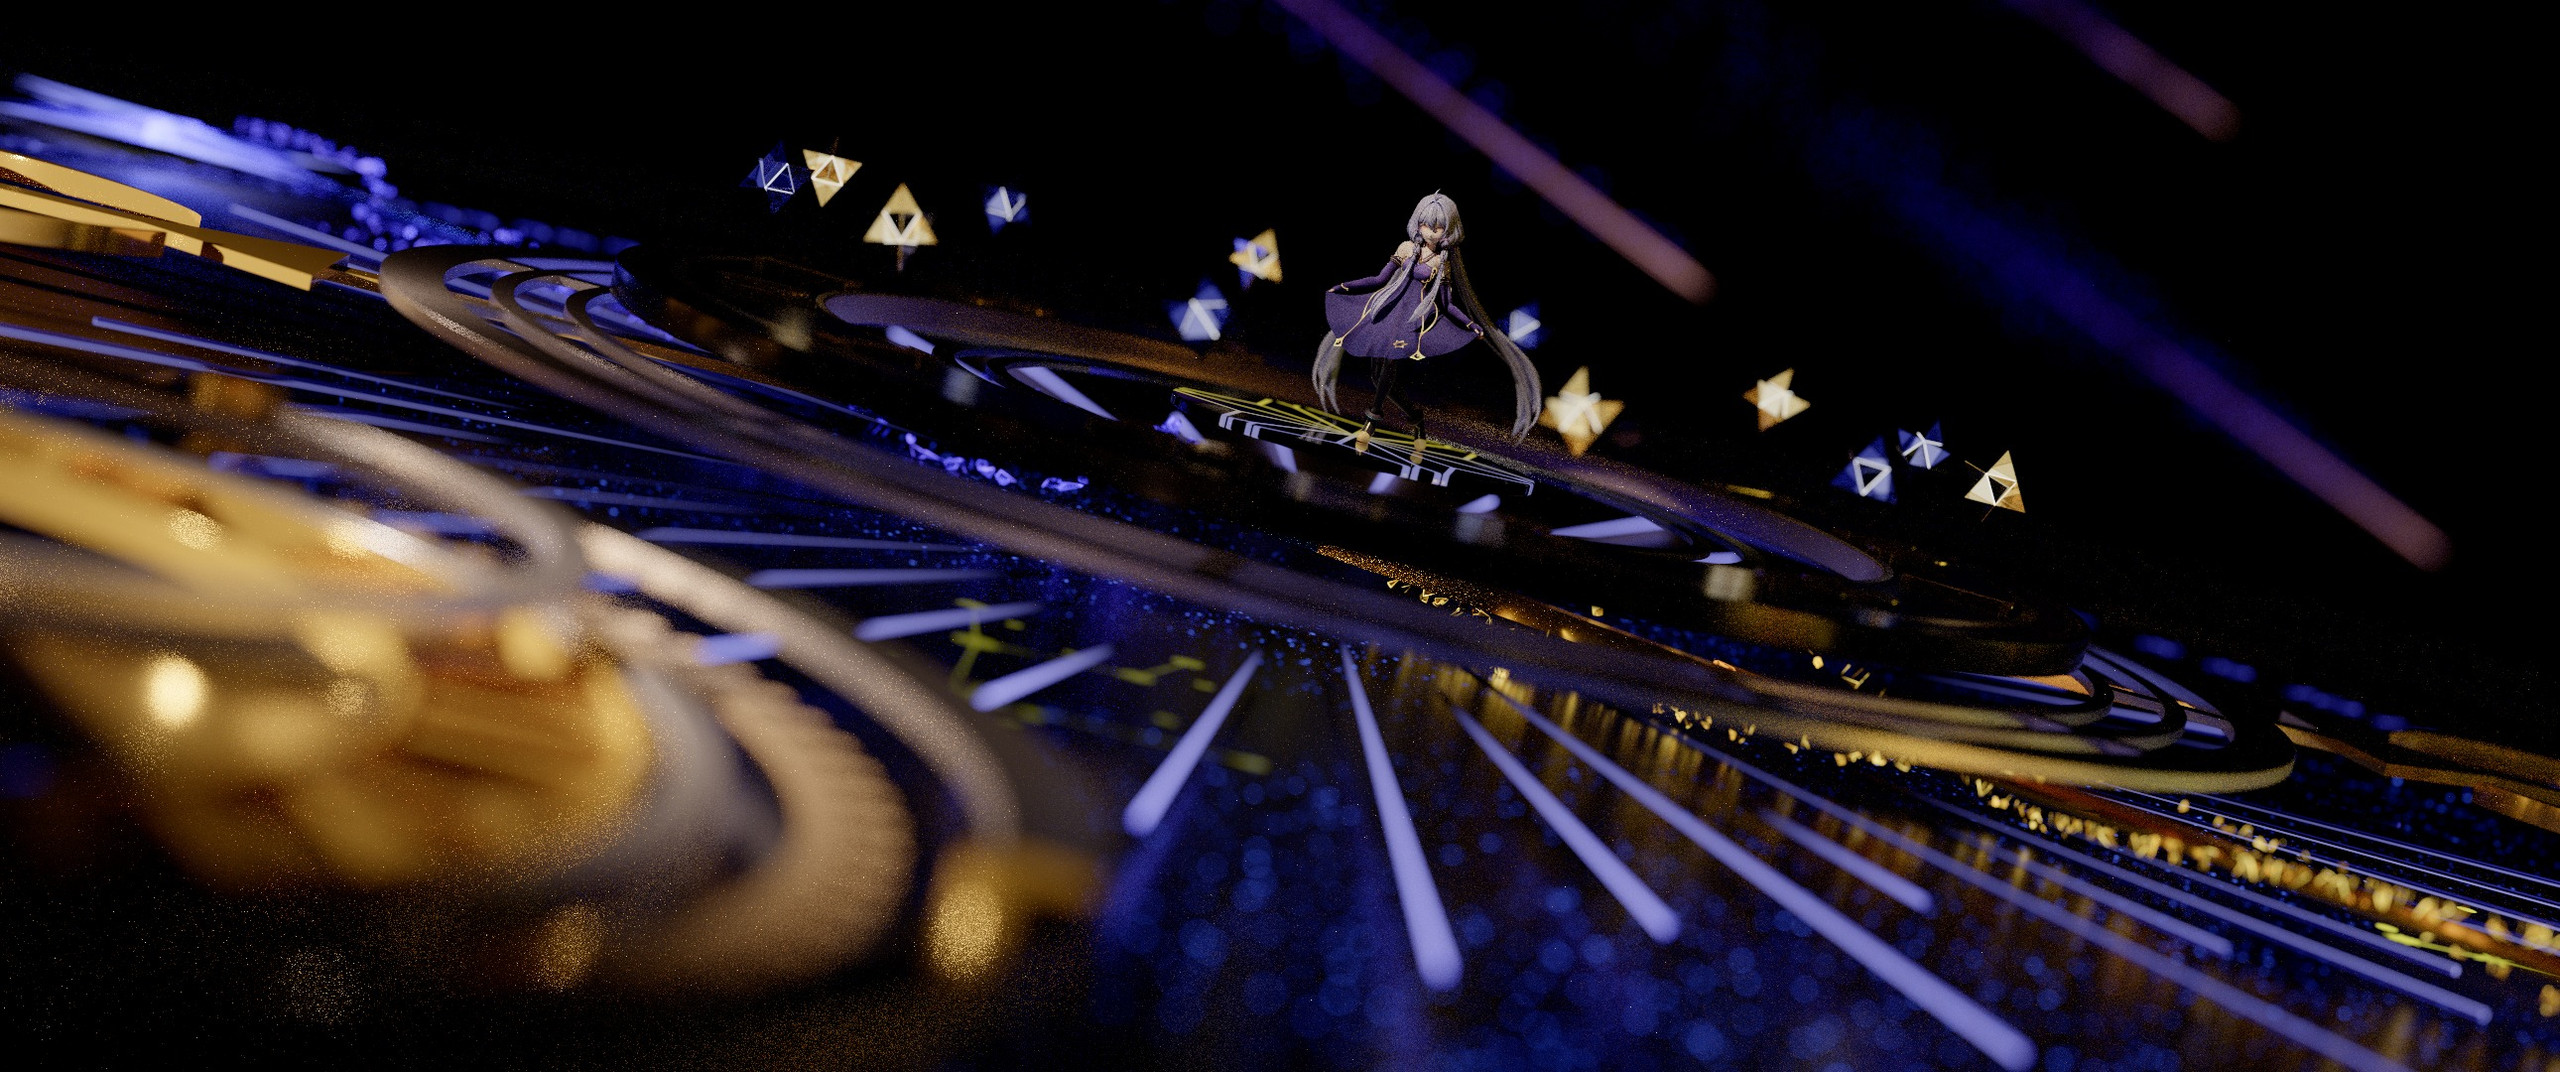
Stardust:自作の Blender シーン(三角形 8.8 M、うち発光 2.4 M、ライトリンク使用)。3440x1440、2048 spp、DEPTH 12、AgX、デノイズなし、RTX 3090 で 33.4 s(16.3 ms/sample)。
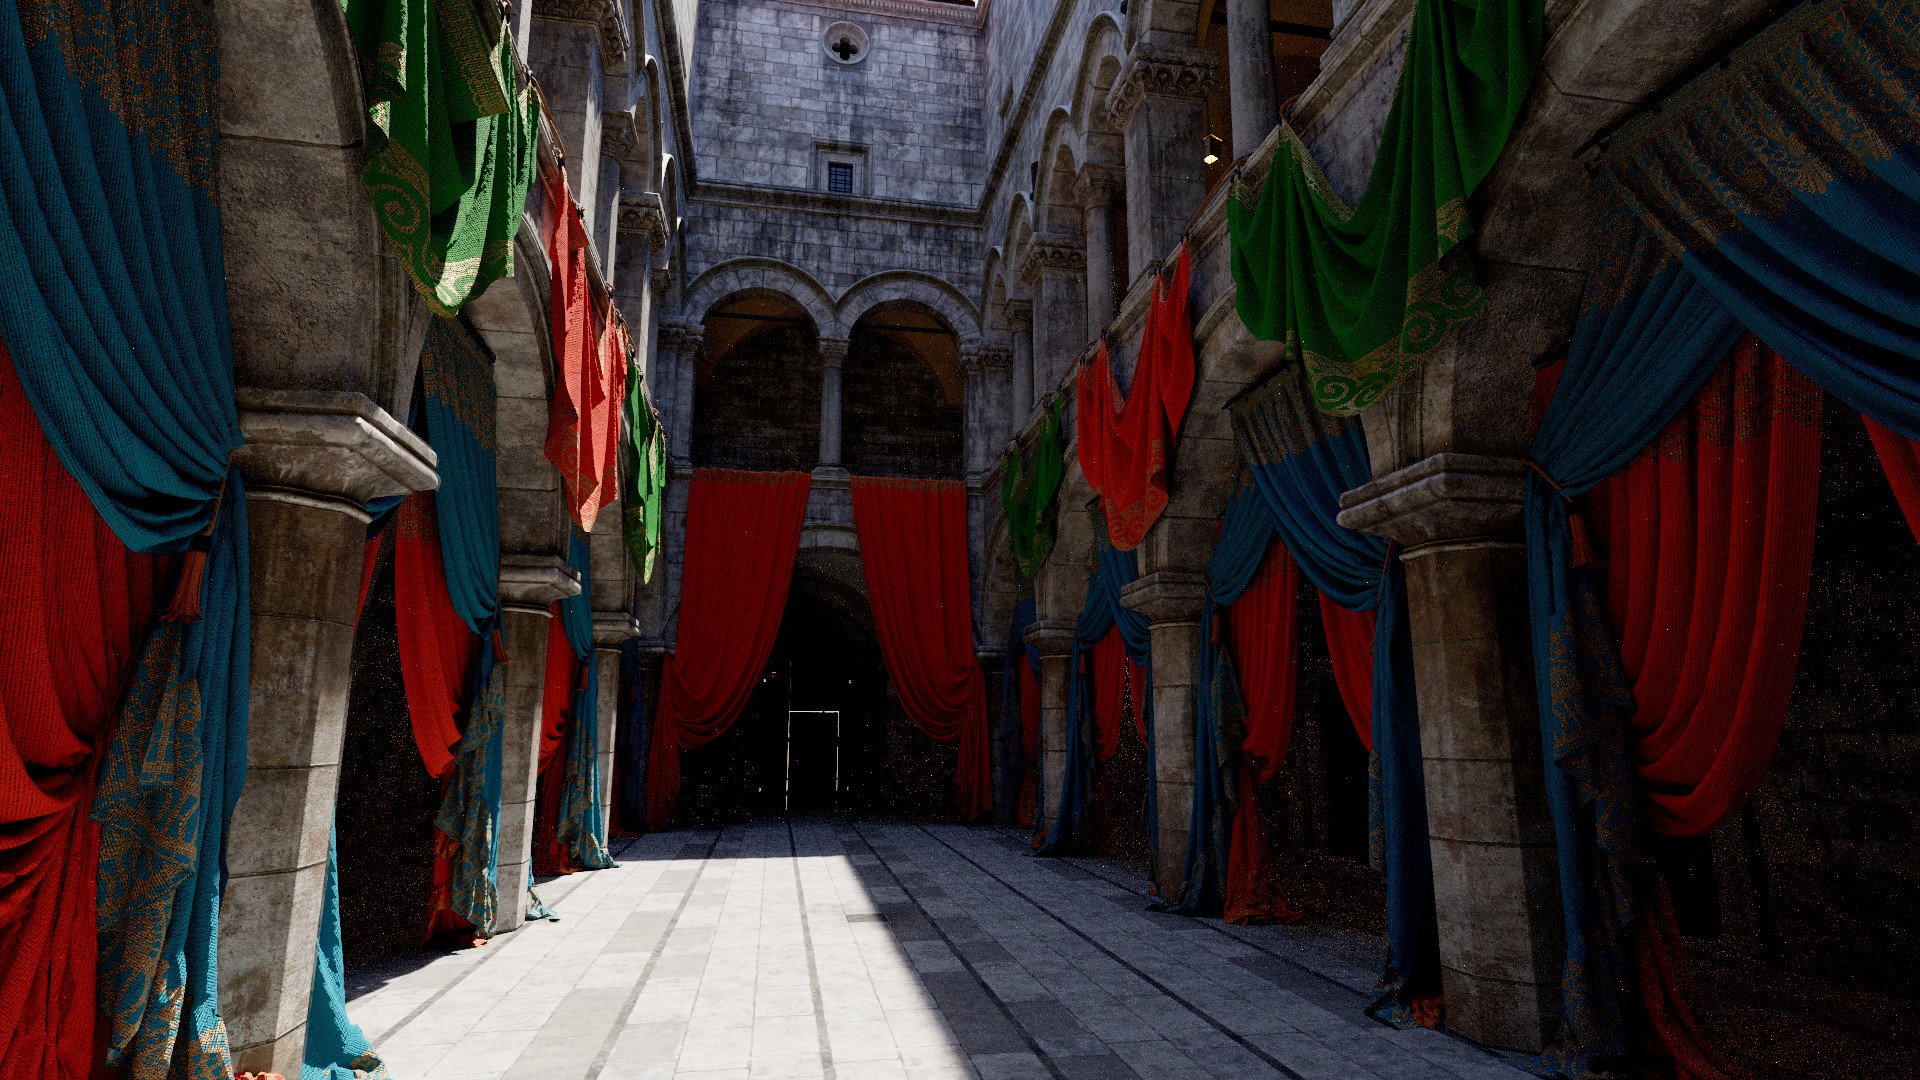
Sponza:カーテンパッケージ付きの Intel Sponza。1920x1080、1024 spp、DEPTH 8、AgX punchy、デノイズなし、RTX 3090 で 12.5 s(12.2 ms/sample)。
機能
レンダリング
- OptiX ハードウェアレイトレーシング上のウェーブフロント型パストレーサー
- テクスチャとノーマルマップに対応した glTF シーンとメッシュ
- glTF metallic-roughness マテリアル:透過(transmission)、ボリューム吸収、クリアコート、スペキュラー、アルファマスクとブレンド
- 発光メッシュおよびポイント・スポット・ディレクショナルライトに対する MIS 付きの Next Event Estimation(NEE)
- Blender のライトリンク
- MIS compensation 付きの重点サンプリングによる環境マップ
- 薄レンズによる被写界深度と確率的アンチエイリアシング
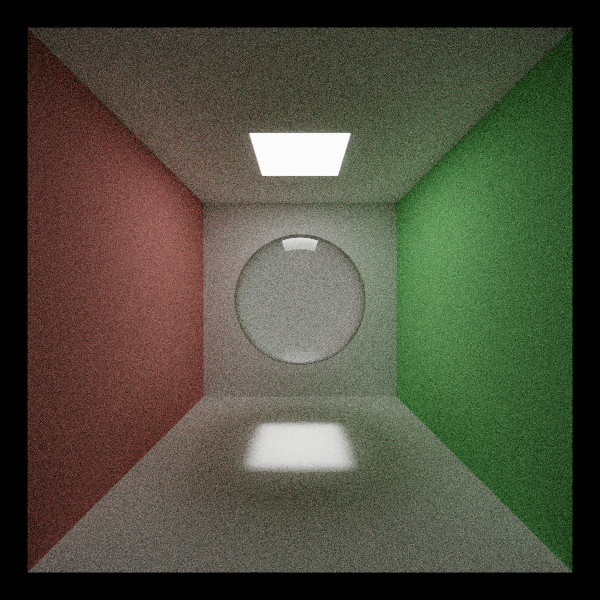
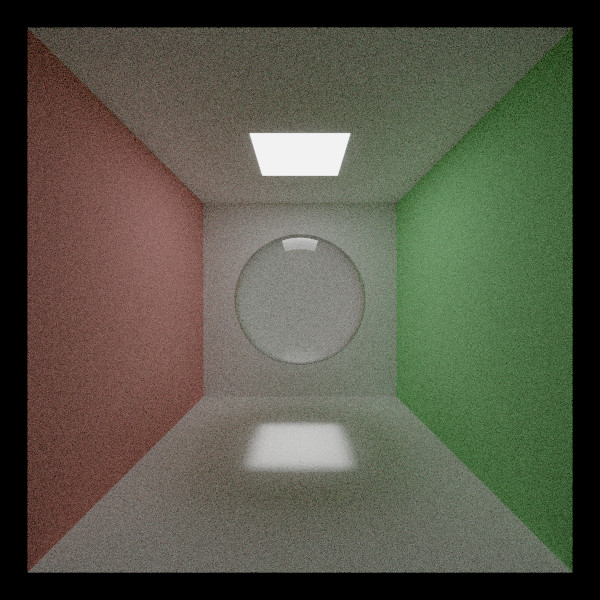
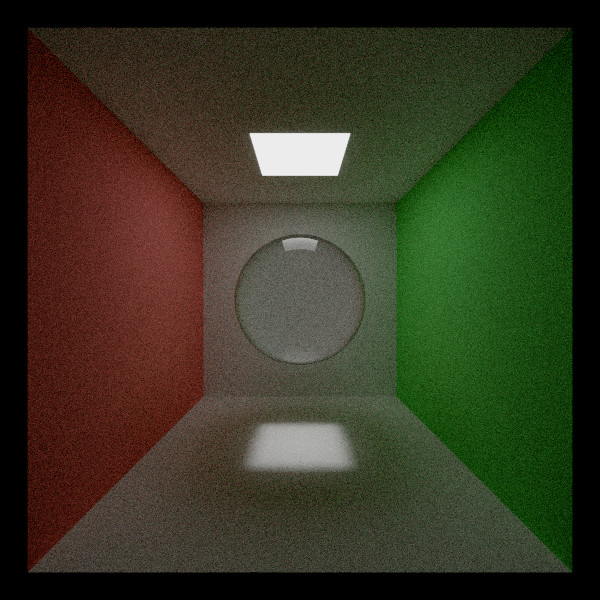
- AgX と ACES のビュー変換
- 物理ベースのカメラ・レンズシステム:開発中。
パフォーマンス
- warp 集約アトミック(warp-aggregated atomics)によるシェードカーネル内でのストリームコンパクション
- CUB の基数ソートによるマテリアルソート(オプション)
- ロシアンルーレット
- デバイスリンク時最適化
その他
- Unreal 風のビューポートカメラと ImGui でのシーン切り替え
- コマンドラインからのヘッドレスレンダリング
レンダリングパイプライン
このレンダラーはウェーブフロント型のパストレーサーで、バウンスの各ステージが生存中の全パスに対する 1 回の起動(launch)になり、終了したパスはコンパクションで取り除かれる。交差判定は OptiX のハードウェアレイトレーシングで行う。
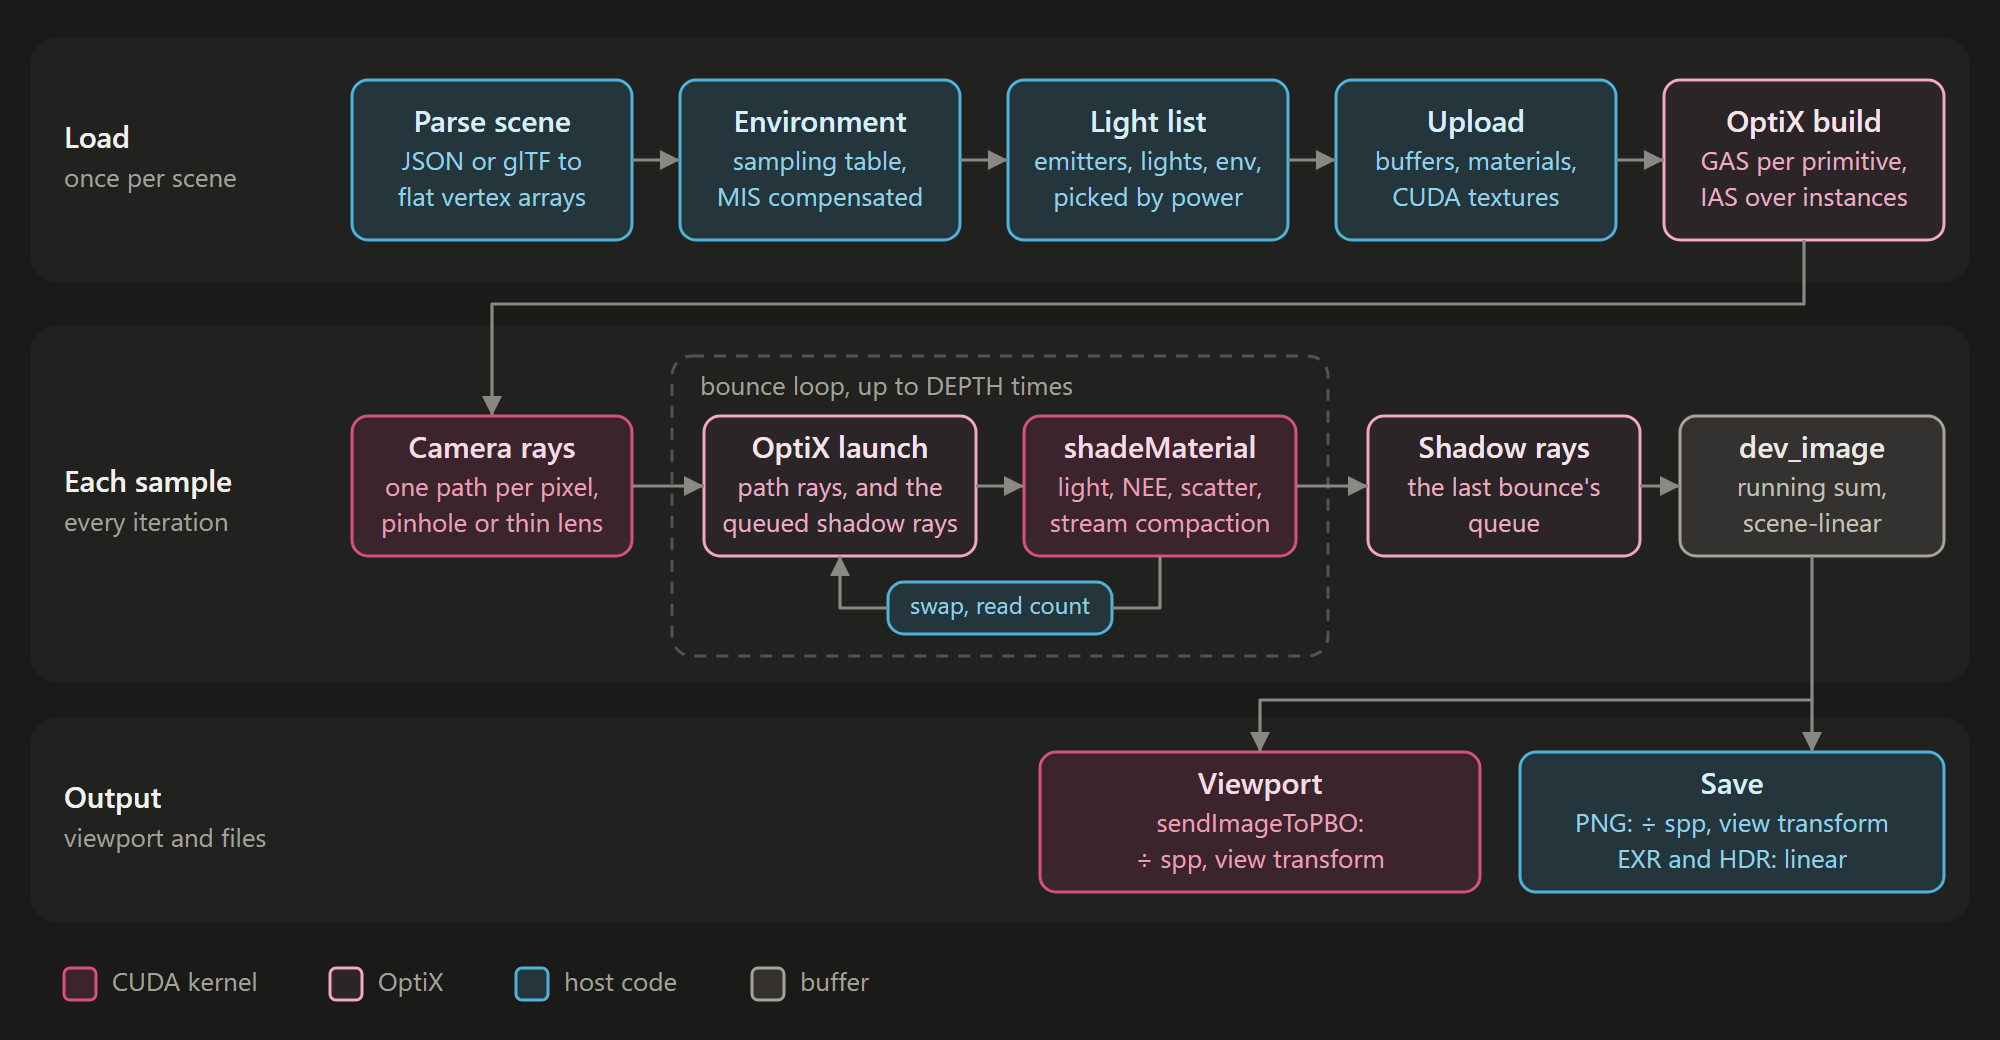
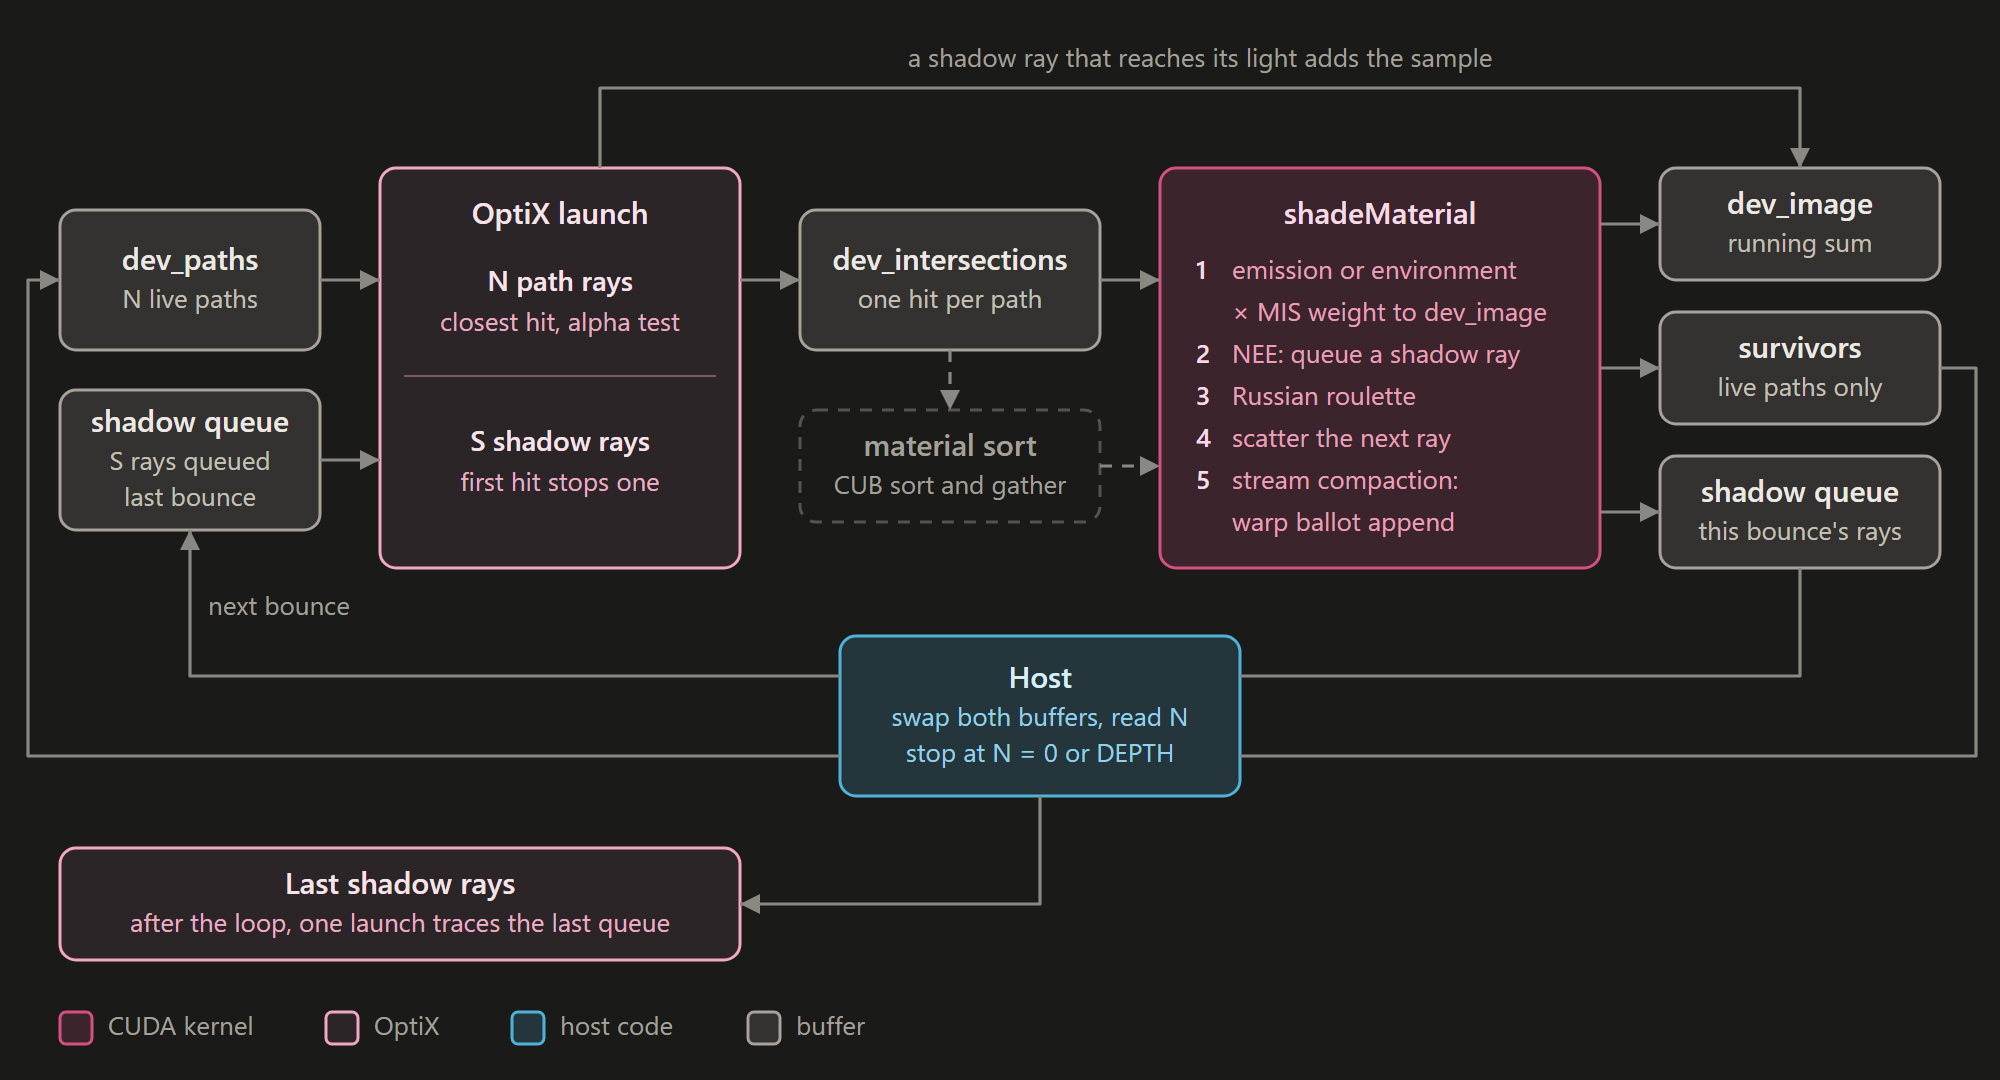
各バウンスは OptiX の起動 1 回と CUDA カーネル 1 つで構成される。OptiX の起動は生存パスを最も近いヒットまでトレースし、同じ起動の中で前のバウンスがキューに積んだシャドウレイもトレースするので、バウンスごとに起動を 1 回節約できる。続いて shadeMaterial が MIS で重み付けした発光を加算し、選んだライトに向けたシャドウレイをキューに積み、ロシアンルーレットを行い、次の方向をサンプリングして、生き残ったパスを warp 集約アトミックで次のバウンスのバッファに直接書き込む(ストリームコンパクション)。破線の枠はマテリアルソート(--sort)で、ほとんどのシーンで遅くなるのでデフォルトではオフ。
レンダリング機能
メッシュ:glTF の読み込み
glTF と glb ファイルは tinygltf(v2.9.7)で読み込む。シーン全体として読み込むことも、シーン JSON 内の "TYPE":"mesh" オブジェクトとして読み込むこともできる。タンジェントを持たないノーマルマップ付きメッシュは MikkTSpace でタンジェントを生成する。テクスチャは sRGB をハードウェアでデコードする CUDA テクスチャオブジェクトで、欠けているテクスチャはベースカラーのスロットでマゼンタとして描画されるので、壊れたアセットはレンダリング結果ですぐにわかる。
OptiX は glTF プリミティブごとに三角形の GAS を 1 つ、インスタンス全体に対して IAS を 1 つ構築する。--no-optix を指定するとナイーブなカーネルにフォールバックし、すべての三角形を判定して NEE なしでレンダリングする。
三角形数ごとのナイーブループ vs OptiX
1024x1024、1 サンプルあたりの ms、3 回実行の中央値。
| シーン | 三角形数 | 深度 | ナイーブ | OptiX |
|---|---|---|---|---|
| cornell(球と立方体、メッシュなし) | 0 | 8 | 8.41 | 8.63 |
| cornell-box(研究用シーン) | 36 | 66 | 11.56 | 11.43 |
| cornell_helmet | 15,452 | 8 | 320 | 8.42 |
| transmission_roughness | 77,792 | 12 | 1,511 | 7.37 |
| dragon_attenuation | 134,995 | 16 | 3,146 | 7.52 |
| sponza | 262,267 | 8 | 5,553 | 10.20 |
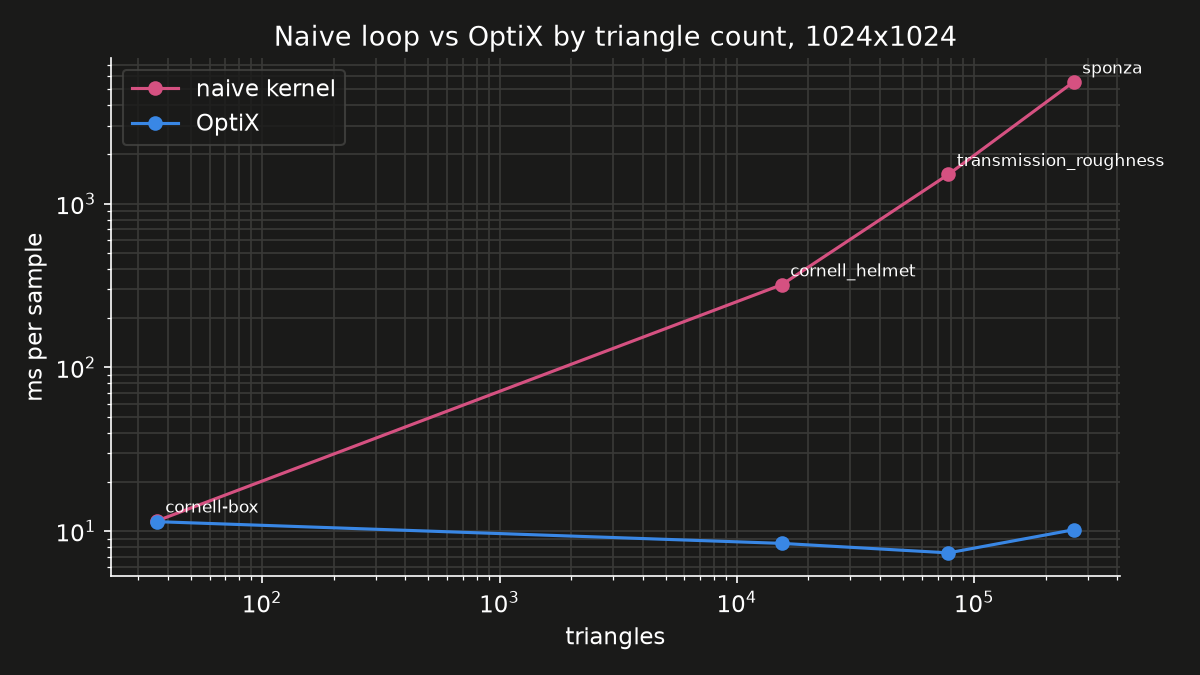
ナイーブカーネルの時間は三角形数に比例して増え、三角形 1000 個あたり 1 サンプル約 20 ms 増える。すべてのパスがすべてのバウンスですべての三角形を判定するからだ。OptiX は Sponza まで Cornell のフレーム時間の 15% 以内に収まり、Intel Sponza(三角形 5.7 M)でも 12.7 ms で済む。
マテリアル:glTF metallic-roughness
このレンダラーのマテリアルは glTF 2.0 の metallic-roughness パラメータを受け取り、仕様の Appendix B にあるリファレンス BRDF でシェーディングする。それを KHR_materials_transmission、volume、ior、specular、clearcoat、emissive_strength で BSDF に拡張している。ノーマルマップ、アルファマスク、アルファブレンド(確率的カバレッジとして)に対応。透過は glTF デフォルトの薄壁(thin-walled)ではなくソリッドな境界として扱うことにした。KHR_materials_volume 拡張なしの Blender エクスポートにはそのほうがよく合うからだ。
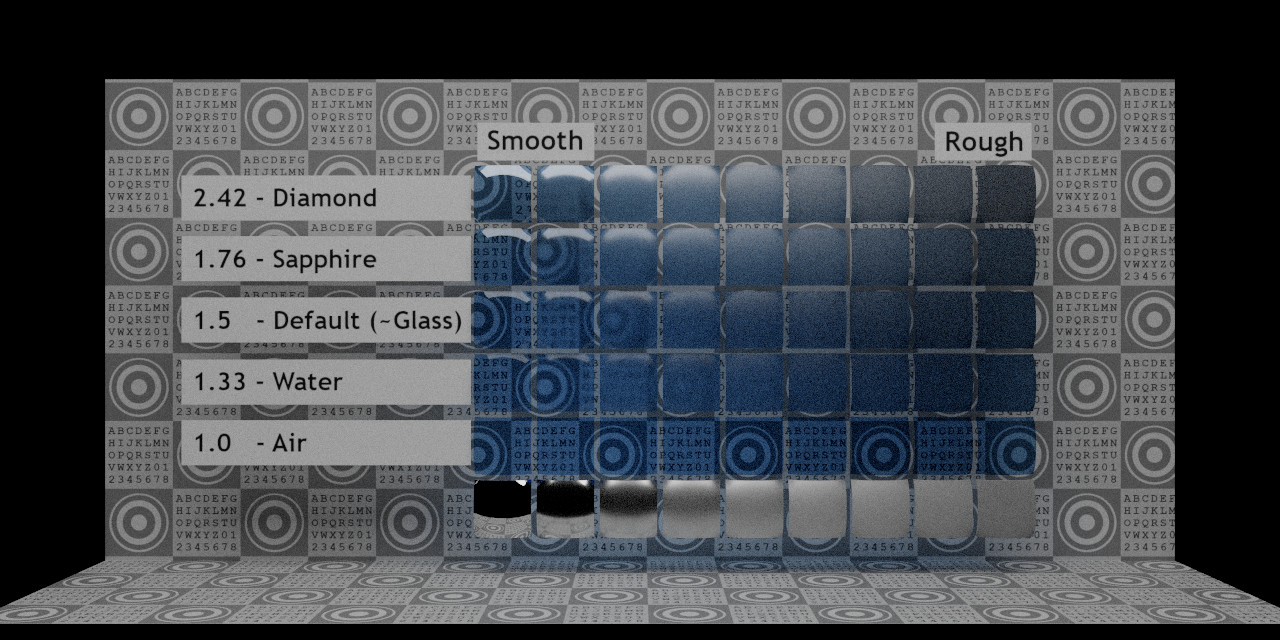
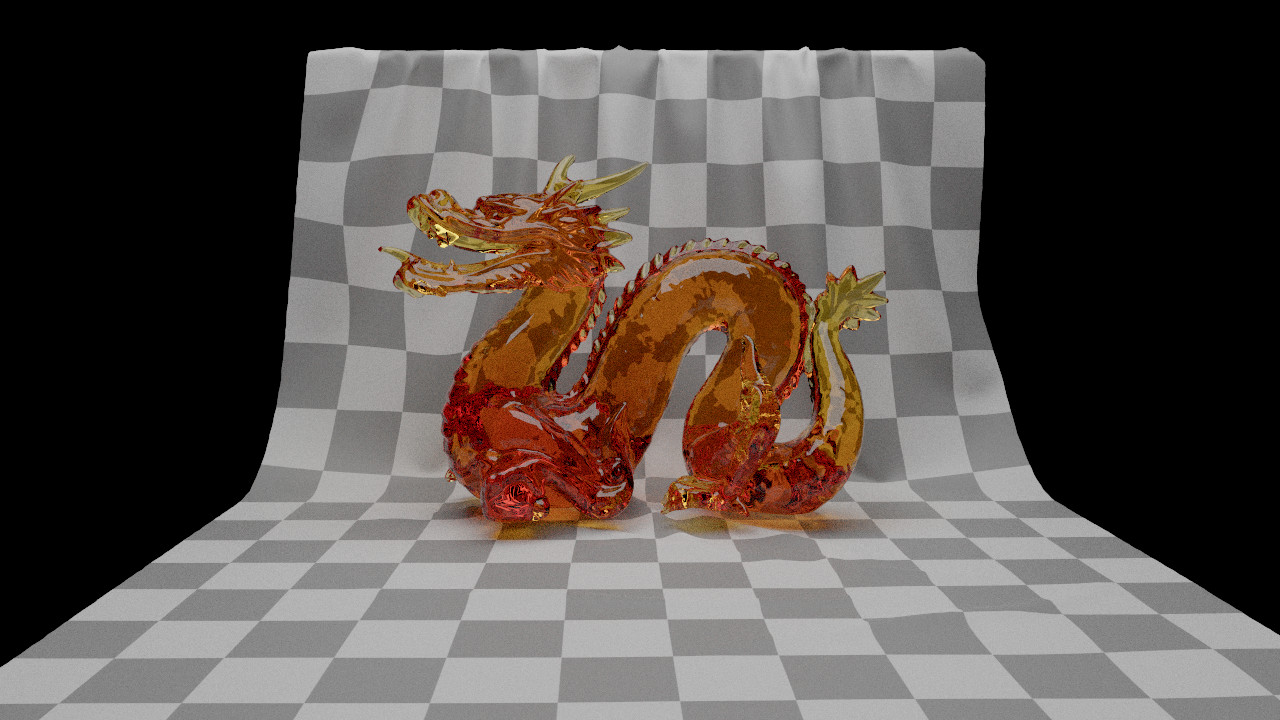
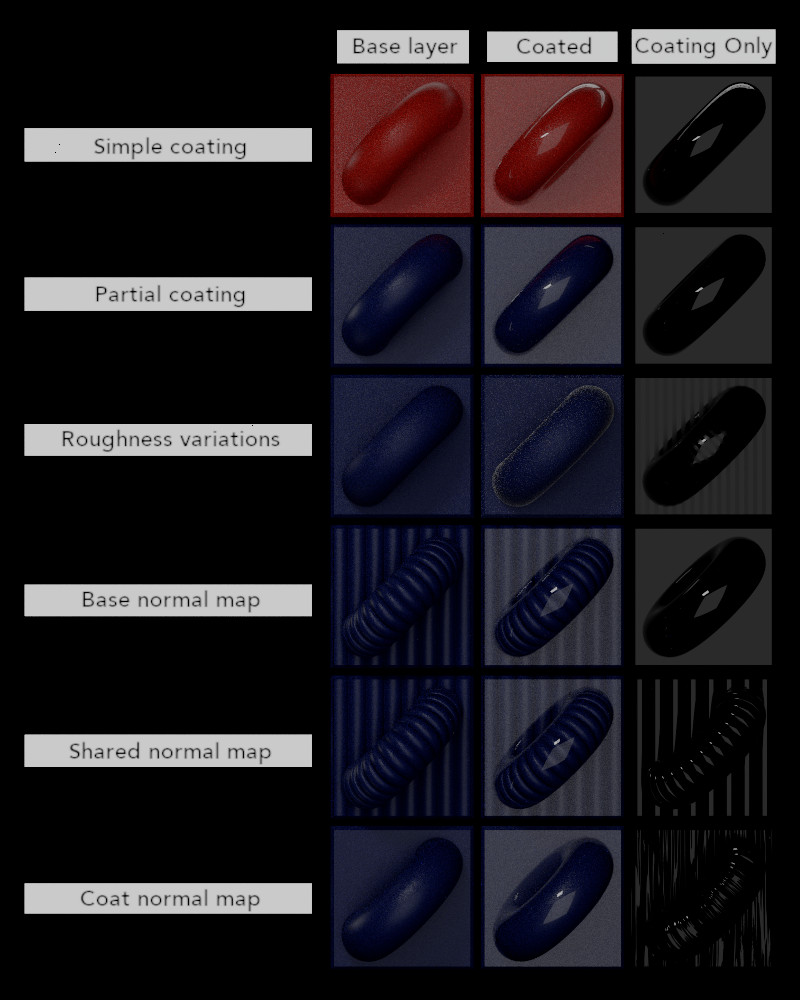
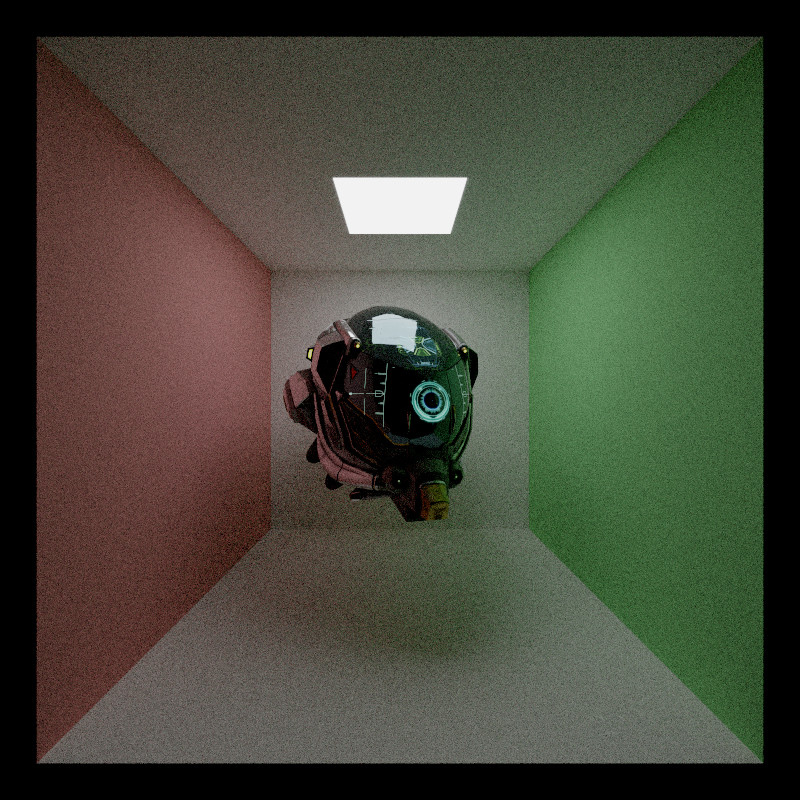
Khronos の 3 つのマテリアルテストにはライトが含まれていないので、シーンファイルにライトパネルを追加した。1024 spp、AgX でレンダリング。
| TransmissionRoughnessTest, 1280x640 | DragonAttenuation, 1280x720 |
|---|---|
 |  |
| ClearCoatTest, 800x1000 | DamagedHelmet, 800x800 |
 |  |
- TransmissionRoughnessTest:ior は 1.0(上)から 2.42 まで、roughness は右に行くほど大きくなる。ior 1.0 の行はシャープなまま。そこではレイがまったく屈折しないからだ。
- DragonAttenuation:吸収色と吸収距離は 1 組だけ。細い尾はより淡い黄色に、厚い胴体は深いオレンジになる。
- ClearCoatTest:ベースレイヤーの広いハイライト(左)、コートの鋭いハイライト(右)、その両方(中央)。
- DamagedHelmet:ノーマル、metallic-roughness、エミッシブの各マップ。
NEE と MIS
パスの最後のヒットを除くすべてのヒットで、ライト上の 1 点を選び、そこへ向かうシャドウレイをキューに積む。多重重点サンプリング(multiple importance sampling, MIS)は、このライトサンプルと、同じ発光体に当たった BSDF サンプリングのレイとを power heuristic(Veach 1997)で重み付けする。ライトはパワーに比例して選ばれる:発光三角形、KHR_lights_punctual のポイント・スポット・ディレクショナルライト、そして環境マップ。十分なサンプル数があれば NEE + MIS と BSDF サンプリングのみは同じ平均値に収束し、8 つのテストシーンで差は 0.1% 以内だった。--no-nee またはビューポートパネルのチェックボックスでオフにできる。
Veach MIS、1024x1024、64 spp、AgX、OptiX。
| BSDF サンプリングのみ | NEE + MIS |
|---|---|
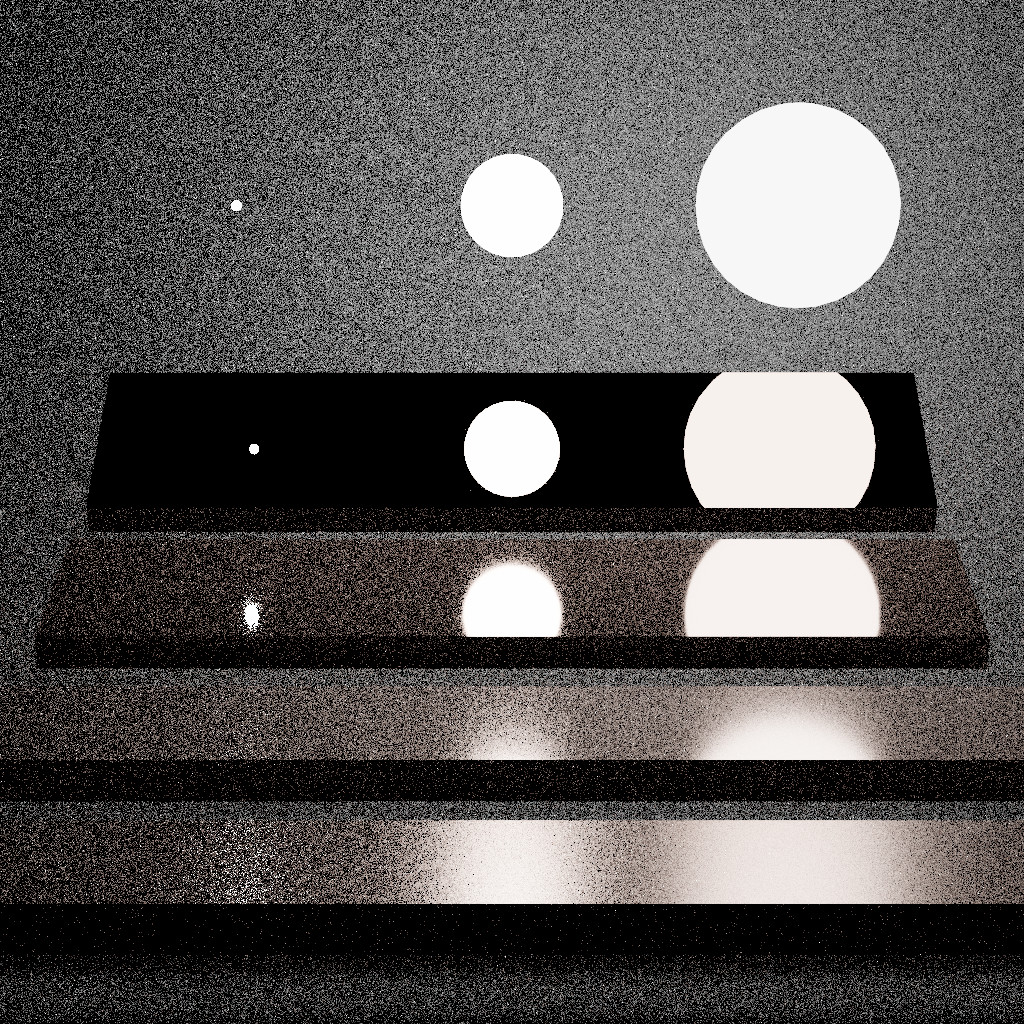 | 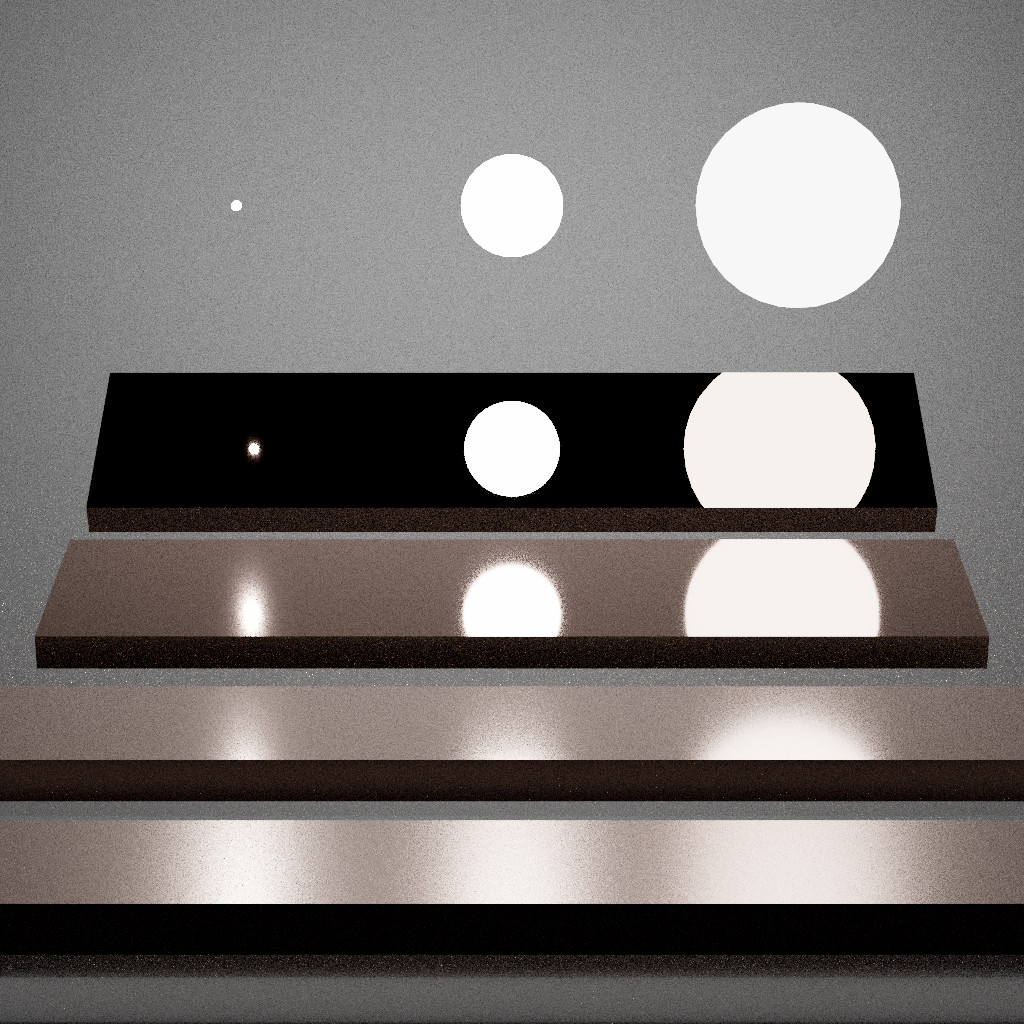 |
- ノイズ:4096 spp のレンダリングに対する RMSE が 62.8 から 9.1(255 段階中)に下がり、分散は 48 分の 1。
- フレーム時間:NEE ありで 2.34 ms/spp、なしで 1.46。
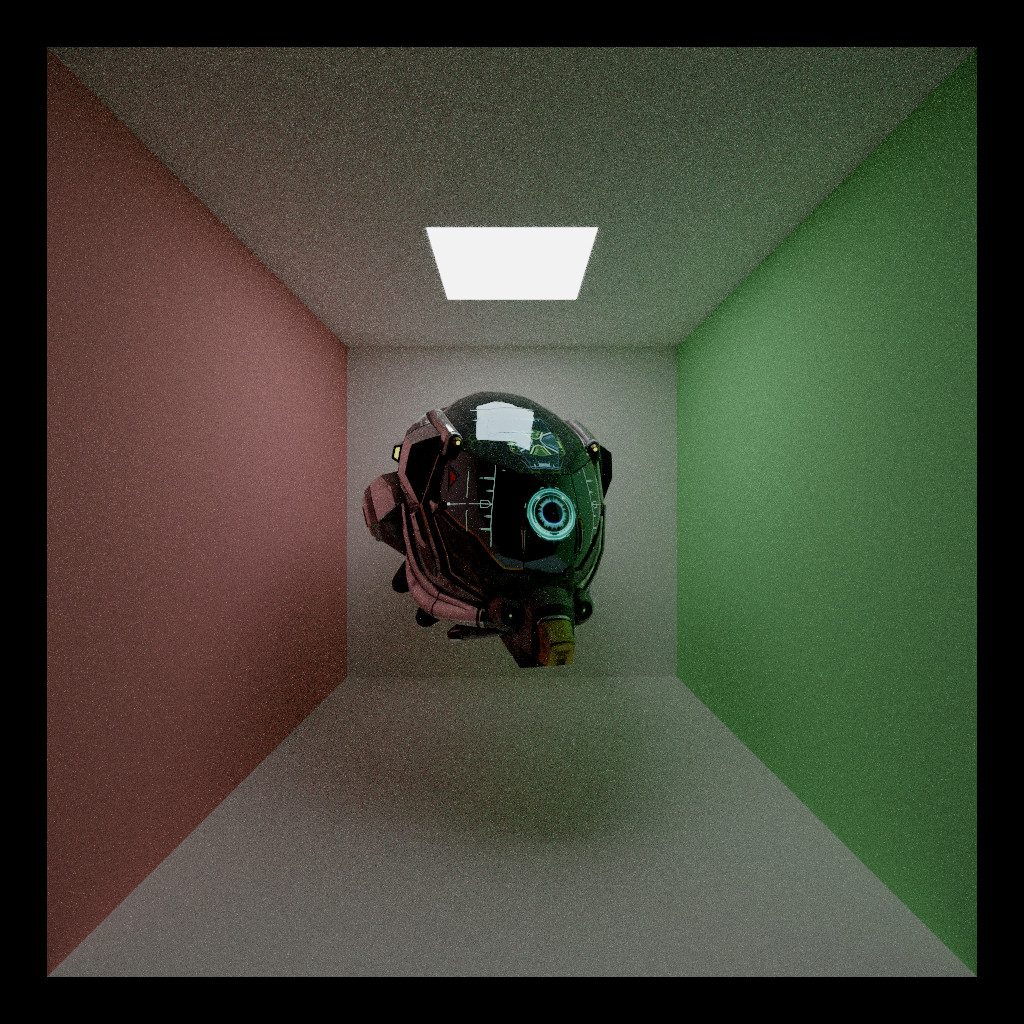
ライトパワーにおけるエミッシブテクスチャ
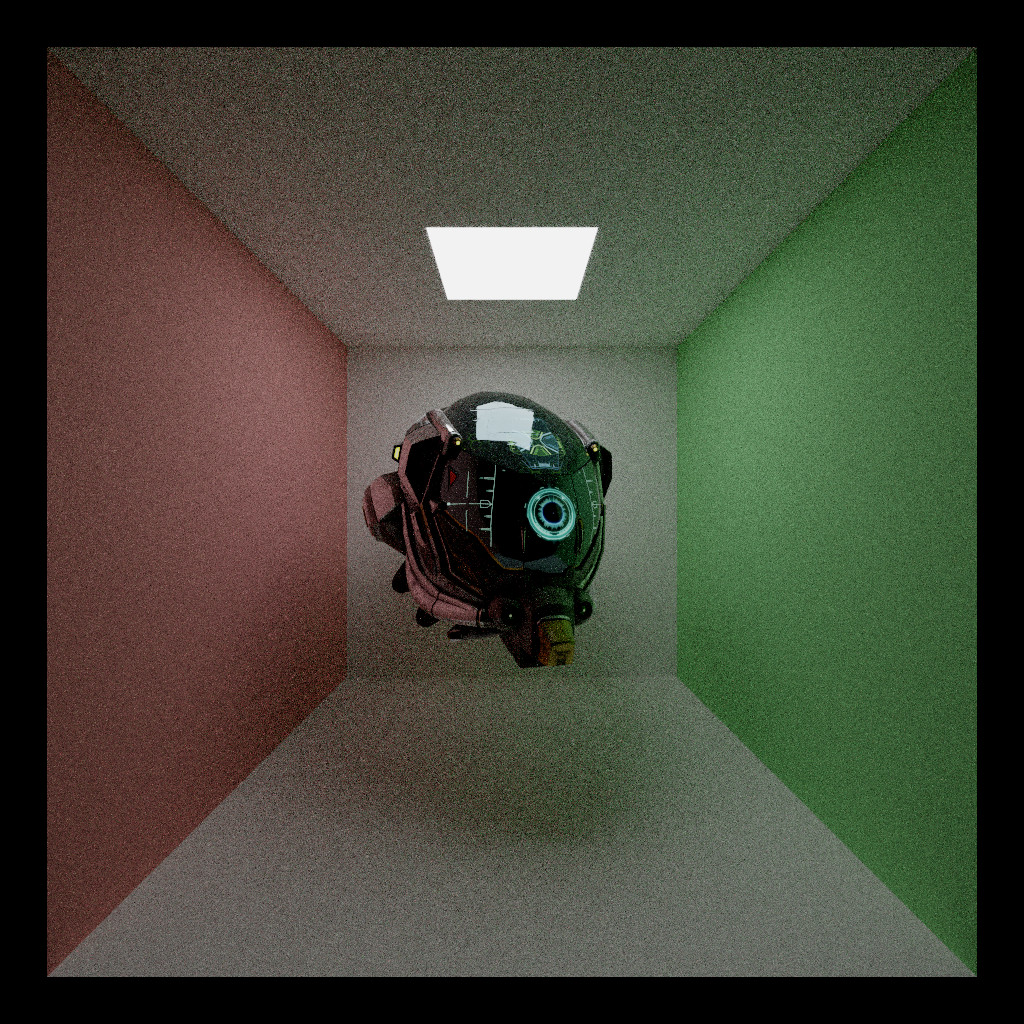
発光三角形の選択重みは、エミッション係数にエミッシブテクスチャの平均値を掛けたもの(PBRT-v4 が画像エリアライトを重み付けする方法と同じ)。DamagedHelmet はエミッションテクスチャを持つモデルのとても良い例で、エミッション係数 1 の三角形が多いのに、エミッションテクスチャの大部分は黒い。テクスチャの平均値を考慮する前は、発光三角形がライト選択の 63% を占め、そのほぼすべてが何も返さなかった。テクスチャの平均値を考慮した今は 0.3% になっている。
cornell_helmet、1024x1024、64 spp、AgX。下段:ヘルメット手前の床を 2 倍で拡大。
| 修正前:エミッション係数のみ | 修正後:係数 x テクスチャ平均 |
|---|---|
 |  |
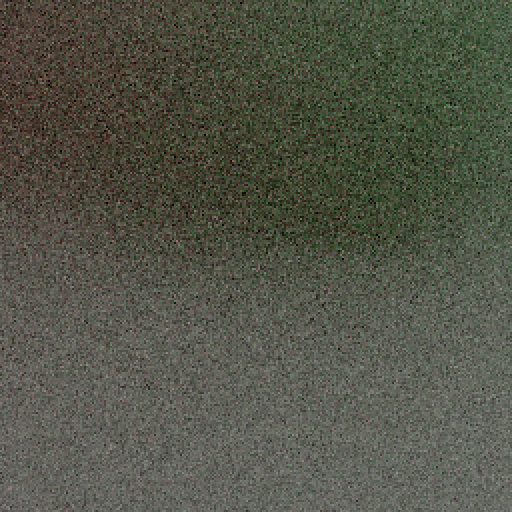 | 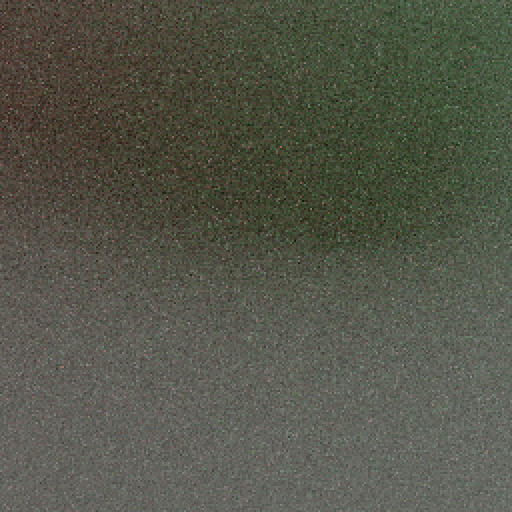 |
- ノイズ:4096 spp に対する RMSE が 12.9 から 9.2(255 段階中)に下がる。サンプル数を 2 倍にしたのとほぼ同等。
- フレーム時間:3.0 vs 2.9 ms/spp。
ライトリンク
ライトリンク(light linking)は、ライトがレシーバーコレクション内のオブジェクトだけを照らすようにする機能。Stardust はこれに依存したシーンだ。レシーバーが選ばれたライトにリンクされていなければライトサンプルを破棄し、BSDF レイが見つけた発光体のうち、その面がリンクされていないものの発光も同様に破棄するので、MIS の重みの合計は 1 のまま保たれる。ライト選択にはシーン内の異なるレシーバーマスクごとに 1 つのテーブルを使うので、面は自分に届き得るライトだけを選ぶ(理由)。
環境マップのサンプリング
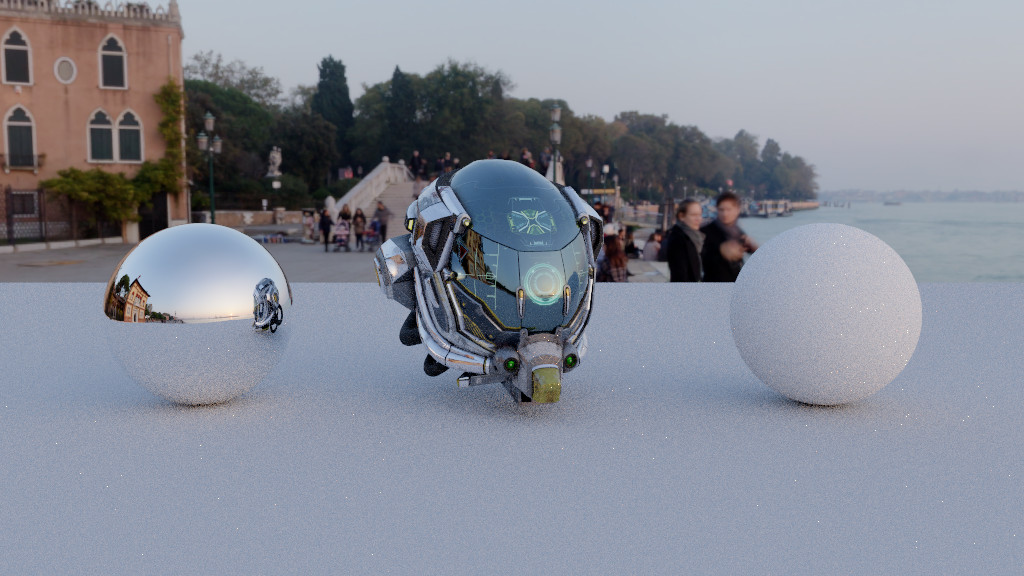
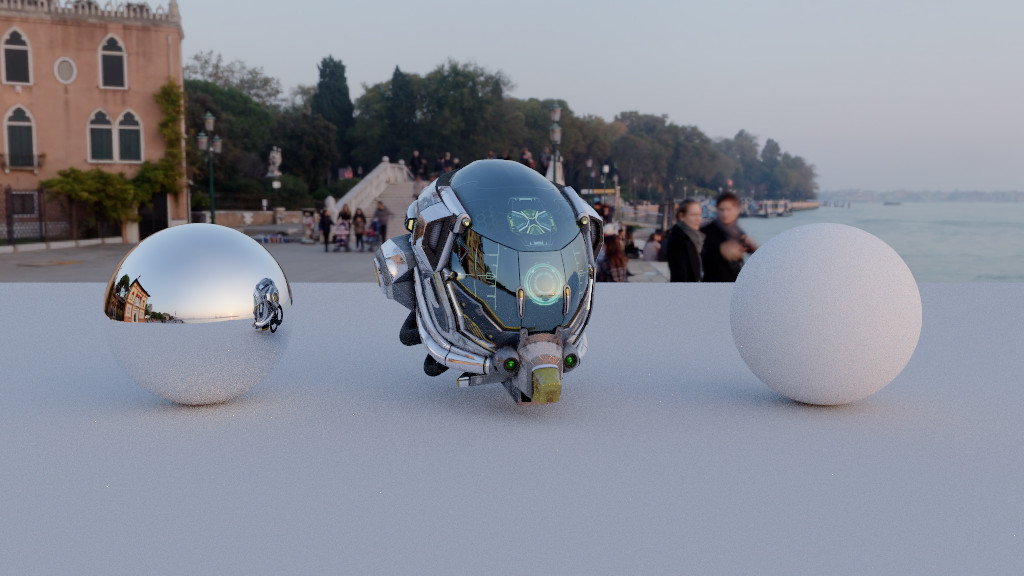
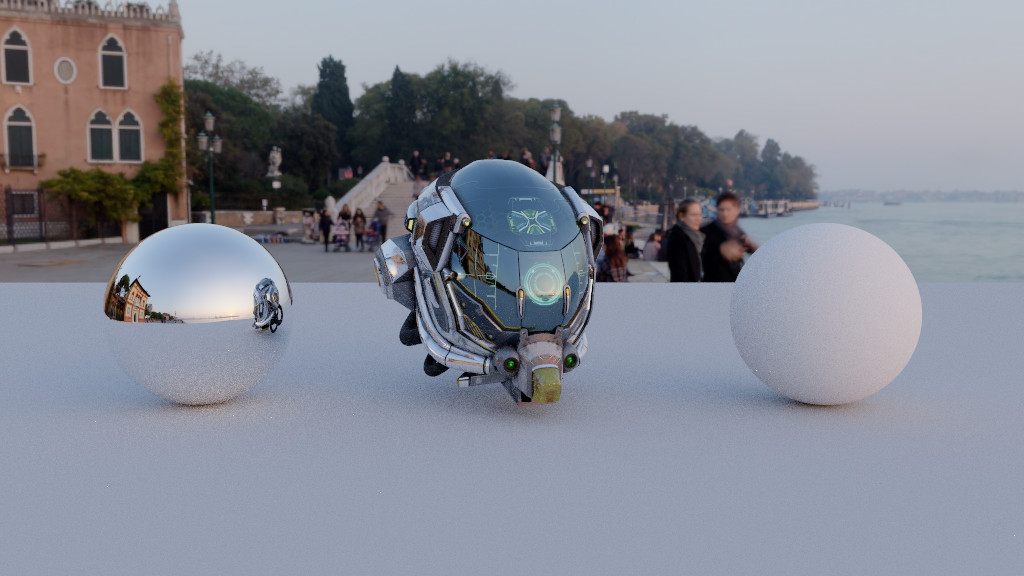
環境光を BSDF サンプリングだけで拾う場合、夕焼けの HDRI の下にある拡散面は偶然にしか太陽に当たらない。それが下の左列に見えるざらつきだ。環境マップは NEE が選ぶライトの 1 つで、マップの輝度に基づく 2D テーブルからサンプリングし、MIS で BSDF サンプリングと重み付けする。MIS compensation(Karlík et al. 2019)はテーブルを構築する前にマップの平均値を差し引くので、選択は太陽と明るい部分に集中し、空の均一な部分は BSDF サンプリングがカバーする。
venice_sunset_4k.hdr 下の hdri_helmet、1024x576、64 spp、AgX。下段:拡散球の手前の床を 2 倍で拡大。
| BSDF サンプリングによる環境光 | 環境光の NEE + MIS | MIS compensation あり |
|---|---|---|
 |  |  |
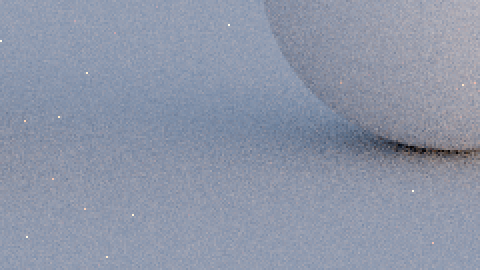 | 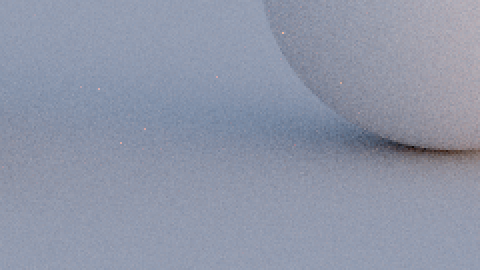 | 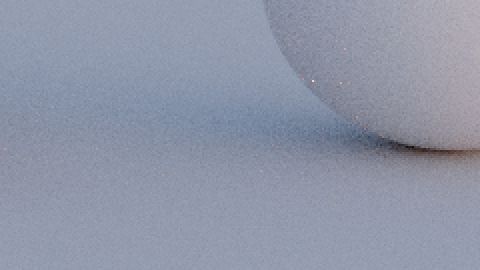 |
- ノイズ:4096 spp に対する RMSE は 4.34、2.85、2.69(255 段階中)。
- フレーム時間:1.11、1.55、1.37 ms/spp。
- 床に残る斑点はクロム球に反射した太陽で、どのライトサンプルも届かないコースティクスだ。
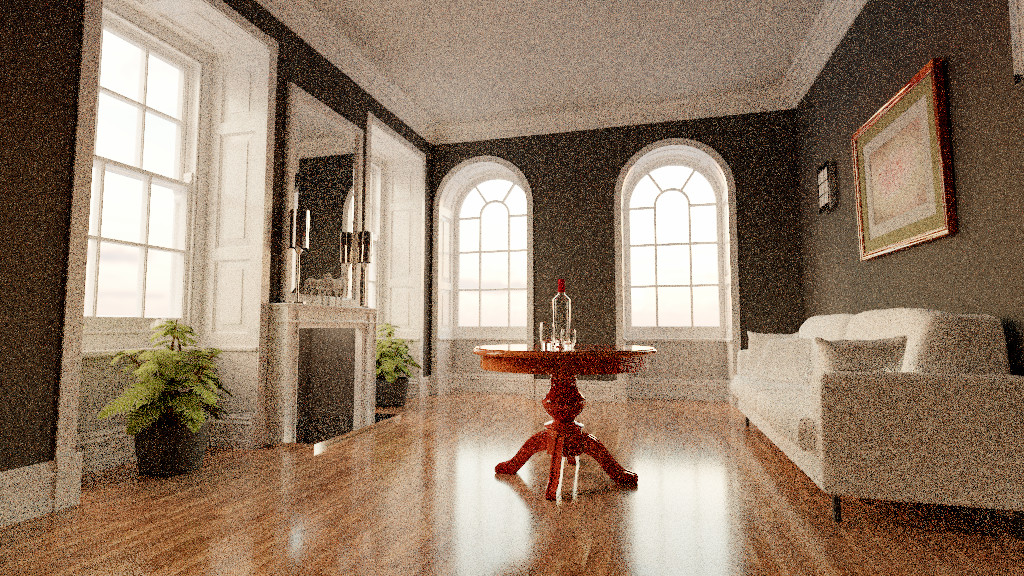
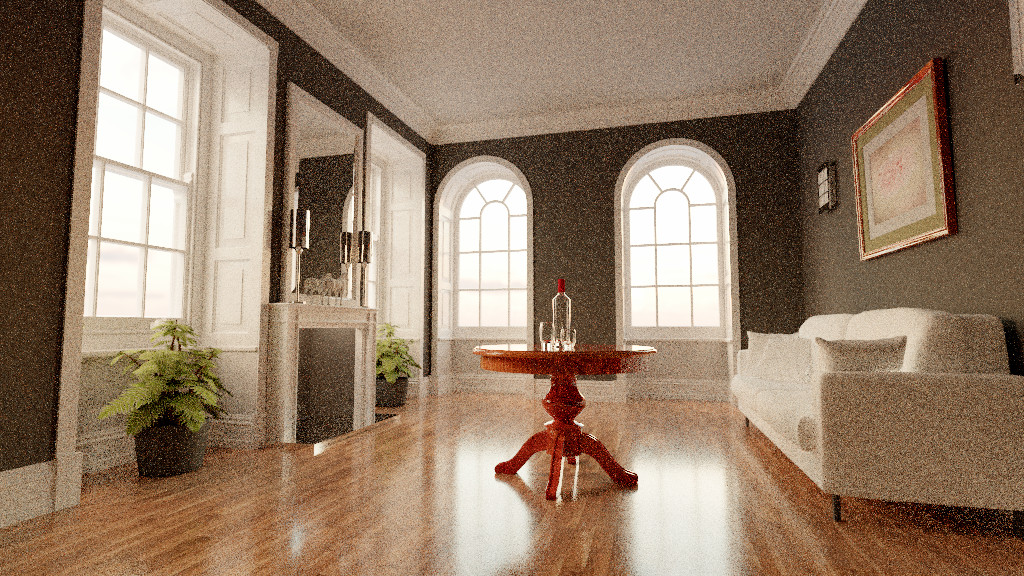
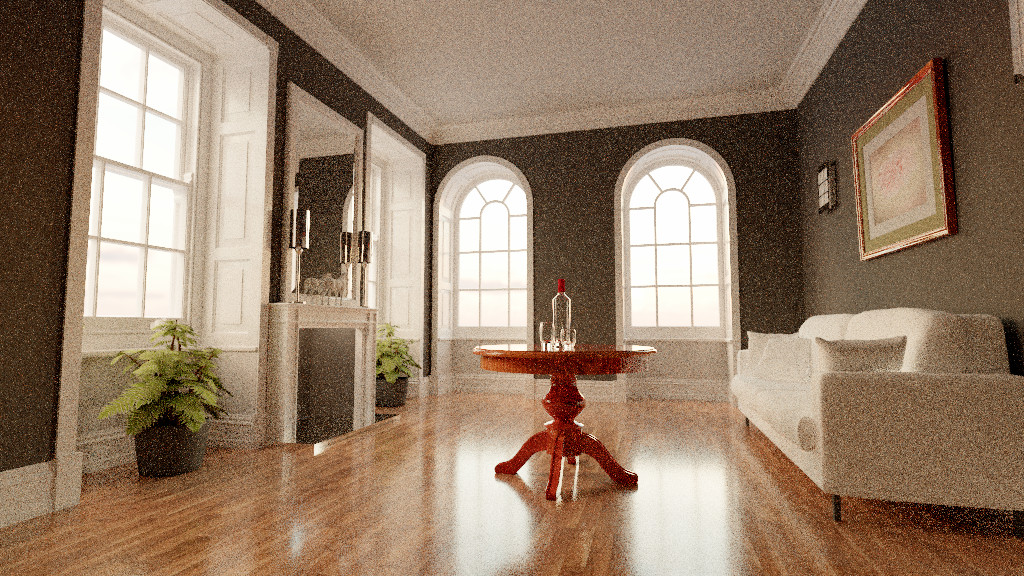
living-room、空のマップのみで照明、1024x576、256 spp、AgX。下段:右側の窓の上の天井と壁を 2 倍で拡大。
| BSDF サンプリングによる環境光 | 環境光の NEE + MIS | MIS compensation あり |
|---|---|---|
 |  |  |
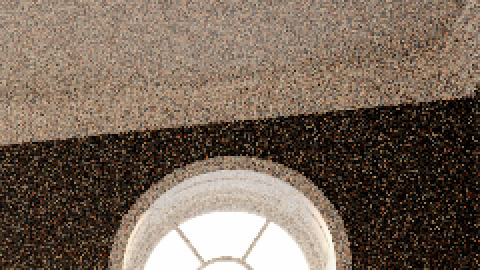 | 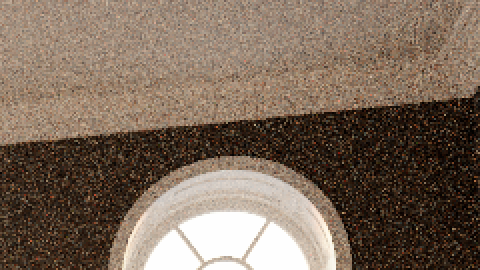 | 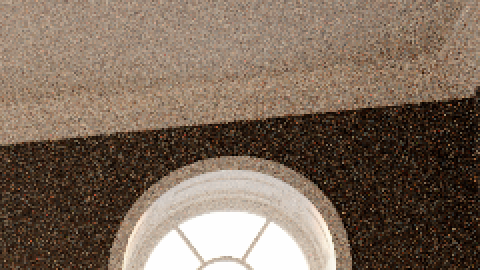 |
- ノイズ:2048 spp に対する RMSE は 24.5、16.1、14.9。
- フレーム時間:4.34、7.42、6.85 ms/spp。部屋の内側から出る環境光のシャドウレイは、ほとんどが壁に当たって終わる。
アンチエイリアシング
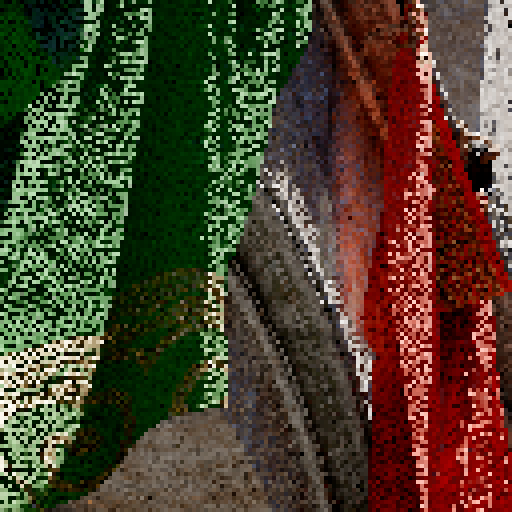
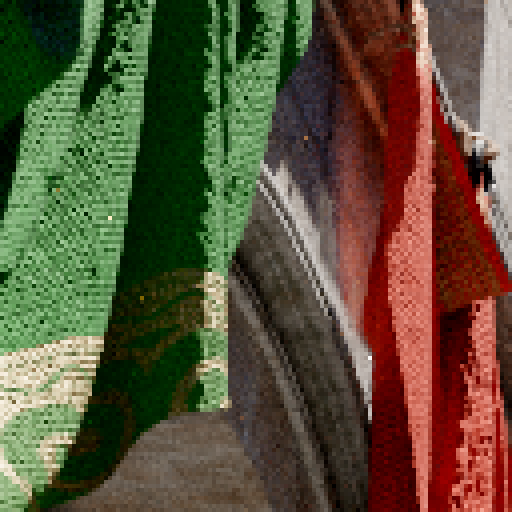
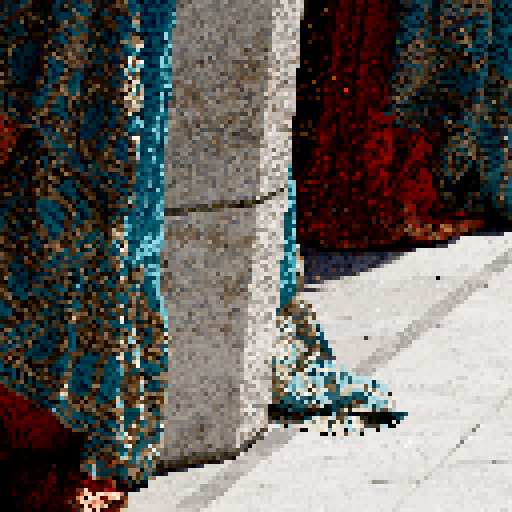
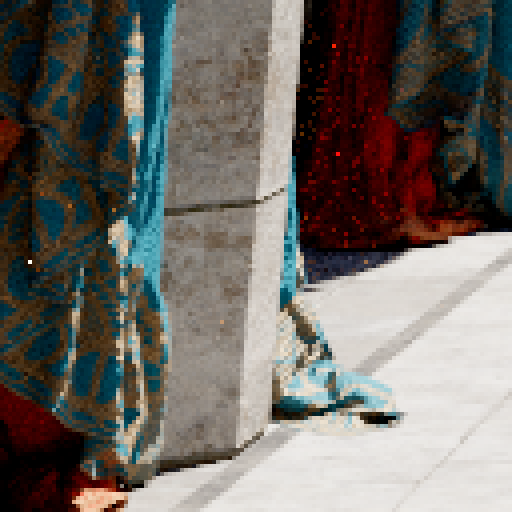
各サンプルでは、ピクセルのカメラレイを中心ではなくピクセル内のランダムな点に通すので、サンプルが蓄積されるにつれてエッジやテクスチャがピクセル全体で平均化される。ミップマップがないので、このジッターが唯一のテクスチャフィルタリングでもある。ジッターがなければ、細かいテクスチャのディテールがエイリアシングで斑点になる。比較用に --no-aa を指定するとすべてのレイがピクセル中心を通る。ジッターのコストは測定できないほど小さく、どちらも 7.81 ms/spp。
Intel Sponza、1024x1024、1024 spp、AgX punchy。128x128 の切り抜きを 4 倍で拡大:
| アンチエイリアシングなし | アンチエイリアシングあり |
|---|---|
 |  |
 |  |
被写界深度
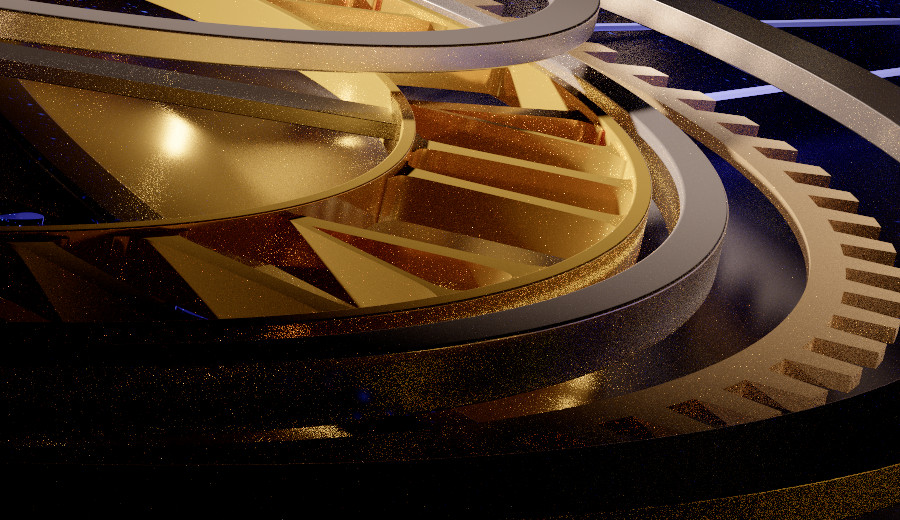
薄レンズ(thin lens)カメラは、各レイを半径 APERTURE の円盤上のランダムな点から出し、ピンホールのレイが FOCUS の平面と交わる点に向ける。これによりその平面はシャープなまま、そこから外れたものは距離に応じてぼける。Stardust の絞りは Blender カメラの焦点距離と F 値から求めている(半径 = 焦点距離 / 2N)。下のレンダリングではカバー画像の 0.0625 から 0.15 に開いている。--lens、--aperture、--focus でシーンファイルの値を上書きできる。薄レンズのコストは 8.36 ms/spp で、ピンホールは 8.06。
Stardust、2580x1080、2048 spp、DEPTH 12、AgX。下段:手前の歯車を等倍で表示。
| ピンホール | 薄レンズ、aperture 0.15 |
|---|---|
 |  |
 | 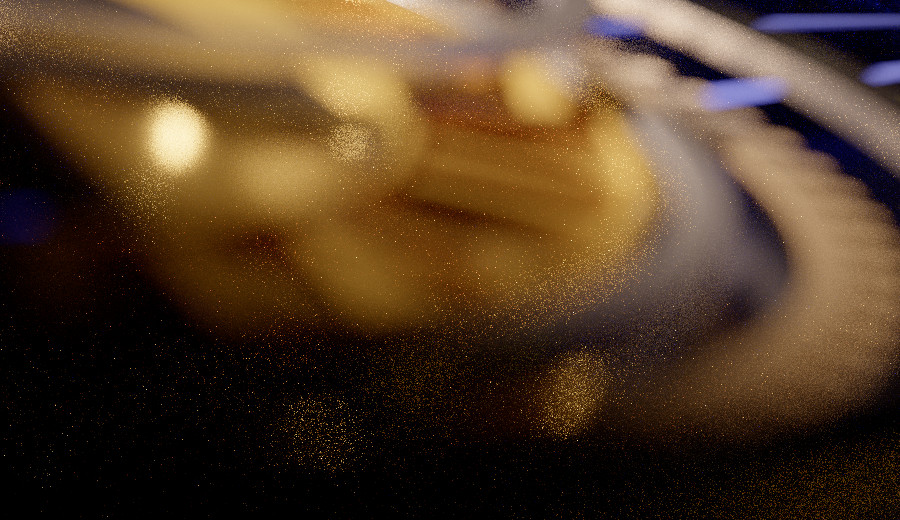 |
ビュー変換
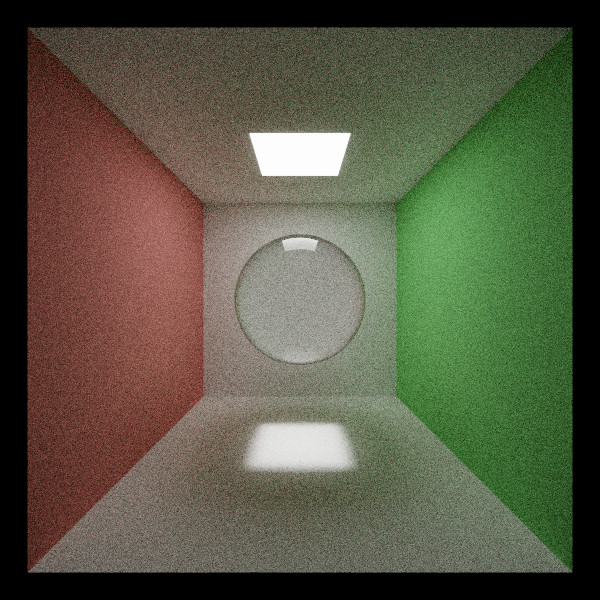
蓄積バッファはシーンリニアのまま保持し、ビュー変換は表示時と保存時に同じ関数で実行するので、ビューポートと PNG が一致する。デフォルトは AgX punchy で、Troy Sobotka の AgX を Benjamin Wrensch が実装した Minimal AgX Implementation に基づいている。ACES は Krzysztof Narkowicz の fit と Stephen Hill のもの(MJP の BakingLab より)の 2 種類がある。
Glass Cornell、600x600、1000 spp、exposure 1.0、DEPTH 8:
| ACES, Narkowicz fit | ACES, Hill fit (1/0.6) |
|---|---|
 |  |
| AgX | AgX punchy |
 |  |
パフォーマンス
デバイスリンク時最適化
ベースコードは CUDA_SEPARABLE_COMPILATION ON でビルドされており、デバイスリンク時最適化(device link-time optimization)なしでは別ファイルの __device__ 関数をインライン化できない。cuobjdump --dump-sass で確認すると、boxIntersectionTest、sphereIntersectionTest、scatterRay がカーネル内で実際の関数呼び出しになっていて、引数はローカルメモリ経由で渡されていた。
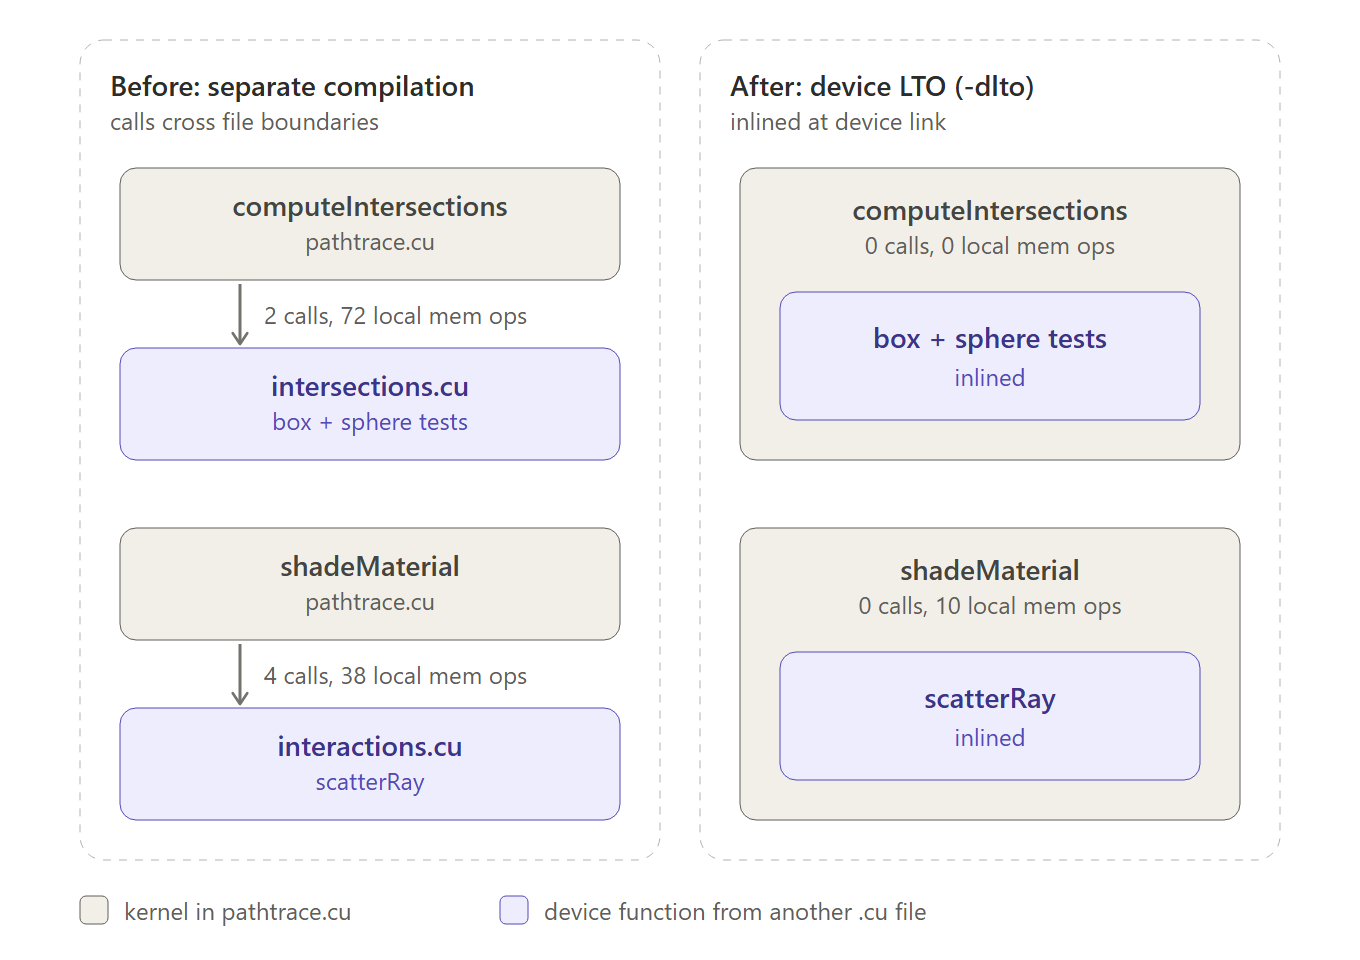
現在は Release ビルドで CUDA のコンパイルとデバイスリンクのオプションに -dlto を追加している。フレームは解像度に応じて 25〜40% 速くなったが、ビルドごとにデバイスリンクの時間が約 4 s 増える。
コンパクションとソート:デバイス LTO と合わせて thrust から CUB へ
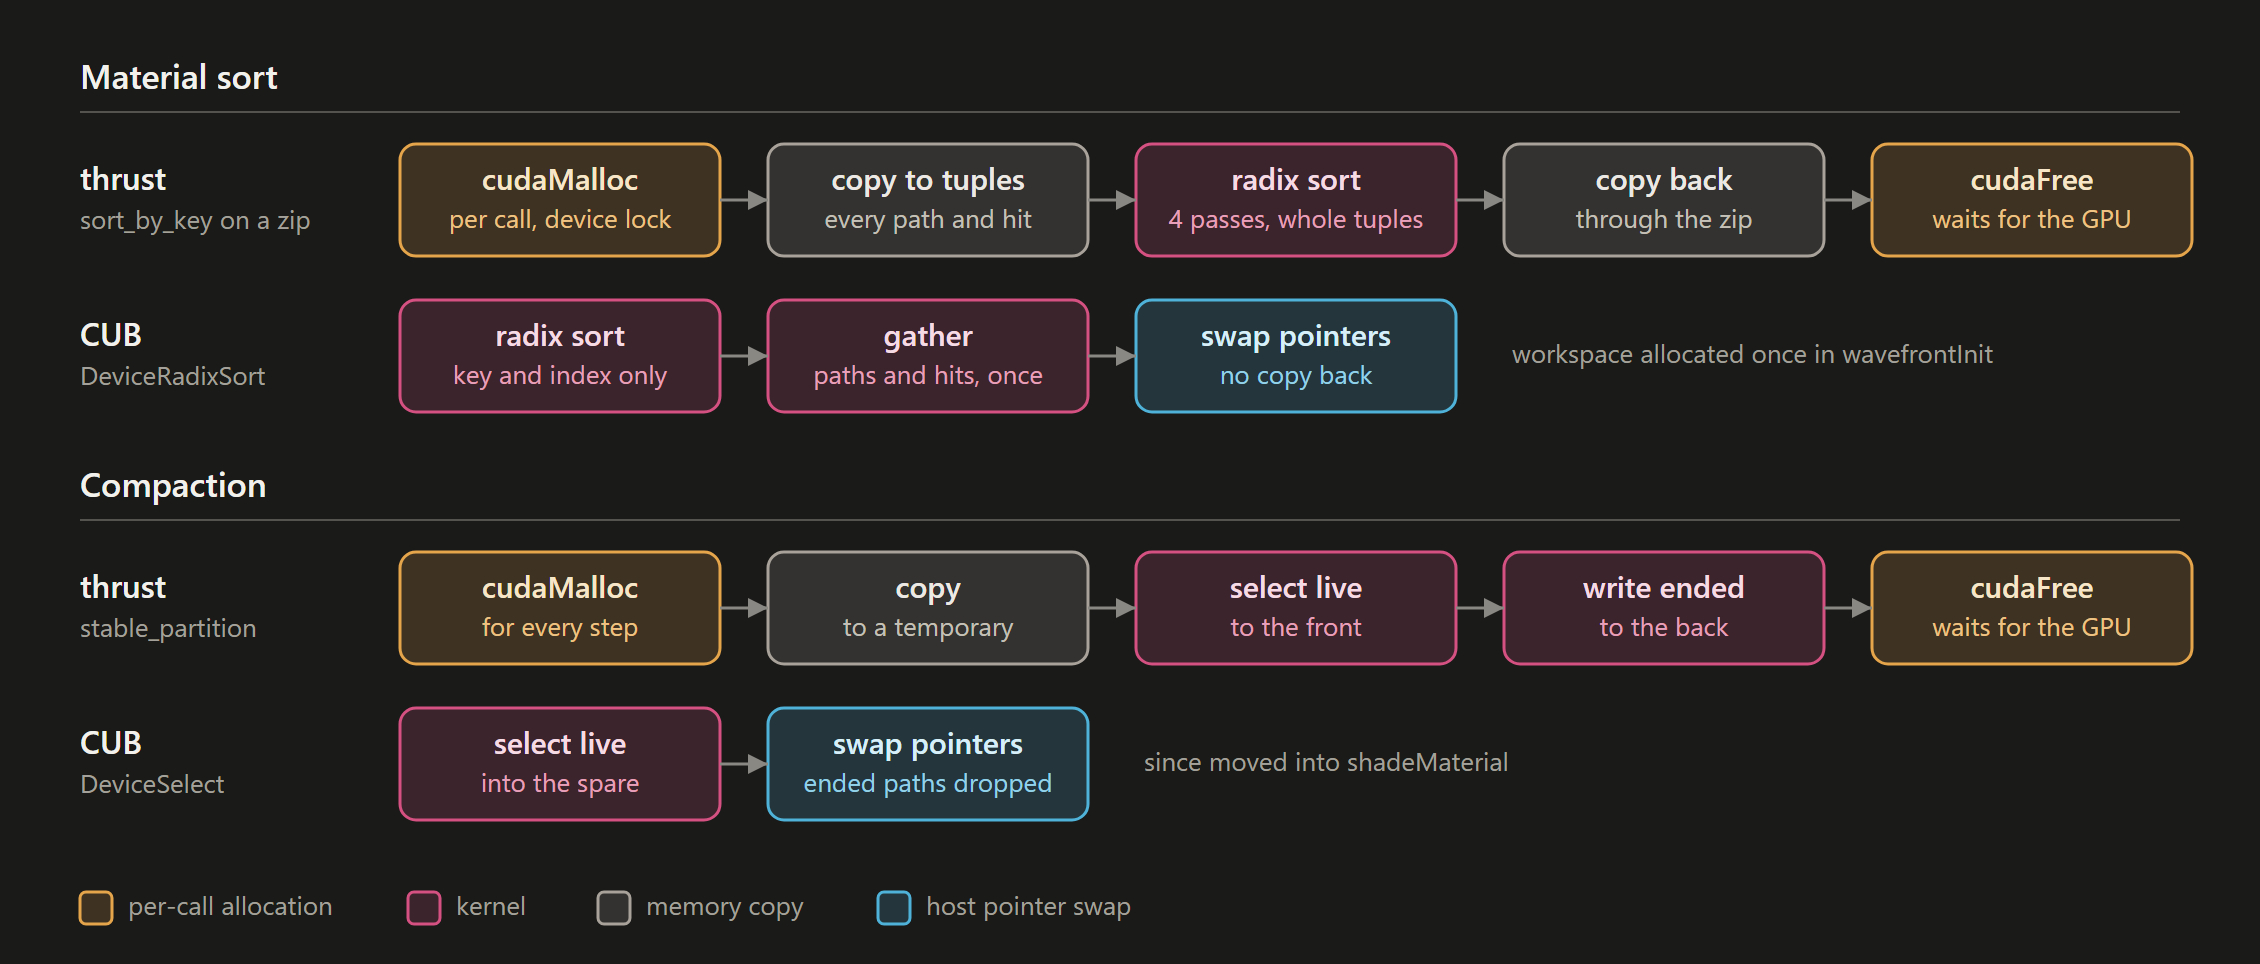
当初このレンダラーはコンパクションに thrust::stable_partition、マテリアルソートに thrust::sort_by_key を使っていた。ソートを有効にすると 400x400 の 1 サンプルに 13 ms かかり、各ステージの時間を計測するとフレーム時間の大半がソートに費やされていた。
| ステージ | 生成 | 交差判定 | ソート | シェード | コンパクション | ギャザー |
|---|---|---|---|---|---|---|
| ms | 0.08 | 0.36 | 8.9 | 0.21 | 4.0 | 0.03 |
これは thrust::device 下のすべての thrust 呼び出しが cudaMalloc でスクラッチメモリを確保して cudaFree で解放しており、cudaFree が未完了の GPU 処理をすべて待つからだ。さらに zip イテレータ上の sort_by_key は、4 回の基数パスのたびにすべてのパスをコピーしていた。キャッシングアロケータだけで両ステージの 60〜70% を削減できた。CUB 版はワークスペースを一度だけ確保することで残りのオーバーヘッドを取り除き、終了したパスを後ろへパーティションするのではなく捨て、マテリアル数に必要なビットだけで(マテリアルキー, パスインデックス)のペアをソートしてから 1 回のギャザーを行う。
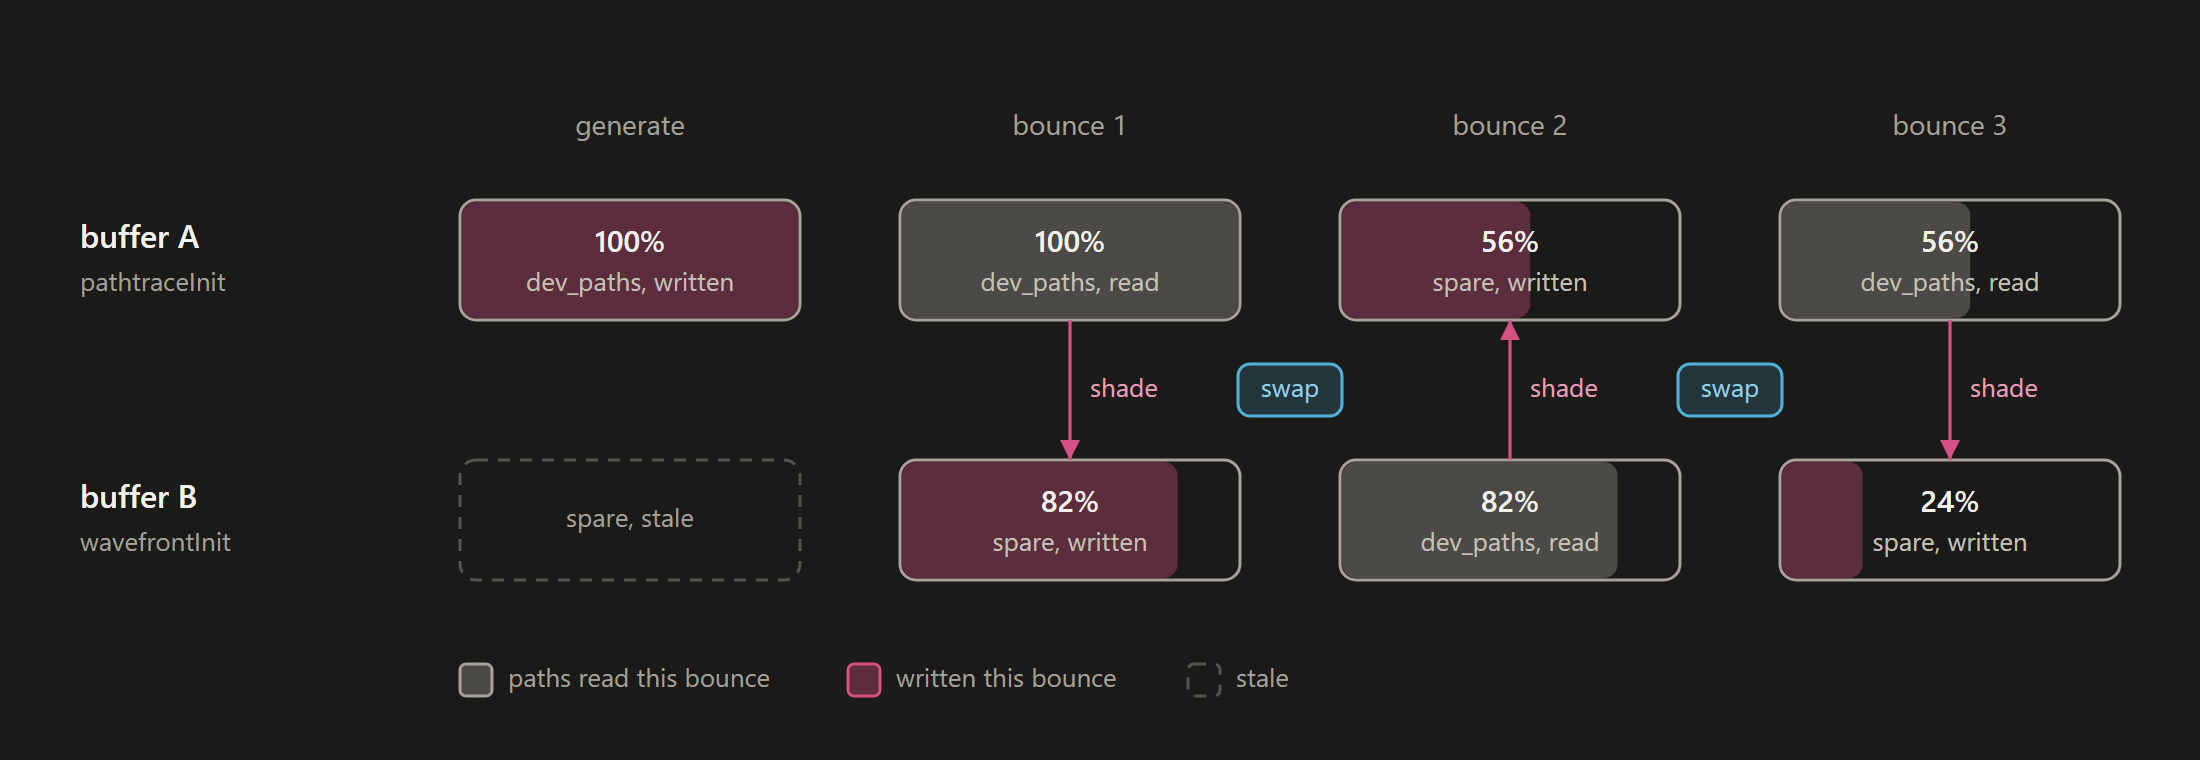
3 バウンスにわたるバッファの所有関係。各バーはバッファ全体を表し、生存パスの割合まで塗られている。
Cornell、5 回実行の中央値、1 サンプルあたりの ms。
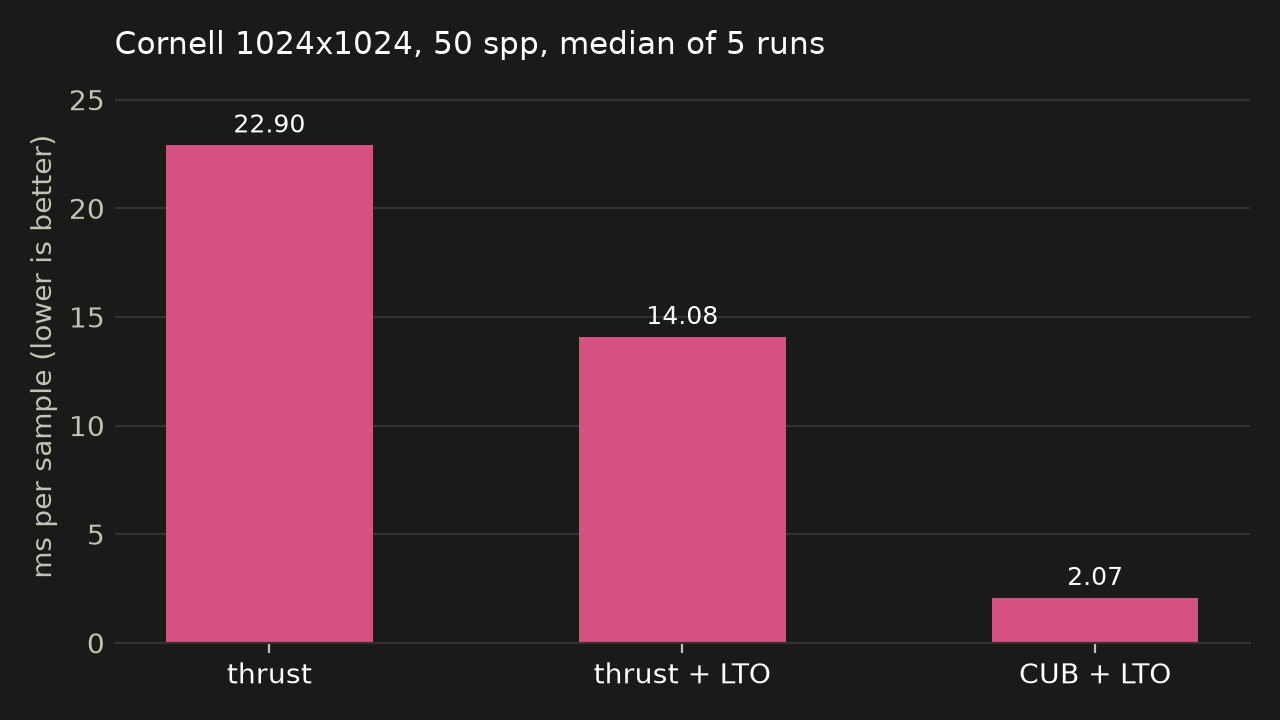
1024x1024 ではフレームが 1 サンプルあたり 22.90 ms から 2.07 ms になり、11 倍速くなった。そのうちデバイス LTO 単独で 1.6 倍。
コンパクションをシェードカーネル内に移動
動機: Cornell 1024x1024 の Nsight Systems プロファイルでは、CUB のコンパクションが 2.59 ms のサンプルのうち 0.49 ms を占めていた(19%。Intel Sponza では 6%)。shadeMaterial が書き込んだばかりの全パスを読み、生存パスをもう一度書き込み、さらにバウンスごとに起動が 2 回増える。
仕組みは warp 集約アトミックだ。shadeMaterial は生き残ったパスを予備のバッファに直接書き込む。warp が __ballot_sync で投票し、lane 0 が 1 回の atomicAdd で warp 内の生存パス分の領域を確保し、各生存パスはそのベースに生存パス内での自分の順位(__popc)を足した位置に書き込む。これでストアはコアレスされたままになる。
1024x1024、100 spp、5 回実行の中央値、1 サンプルあたりの ms。
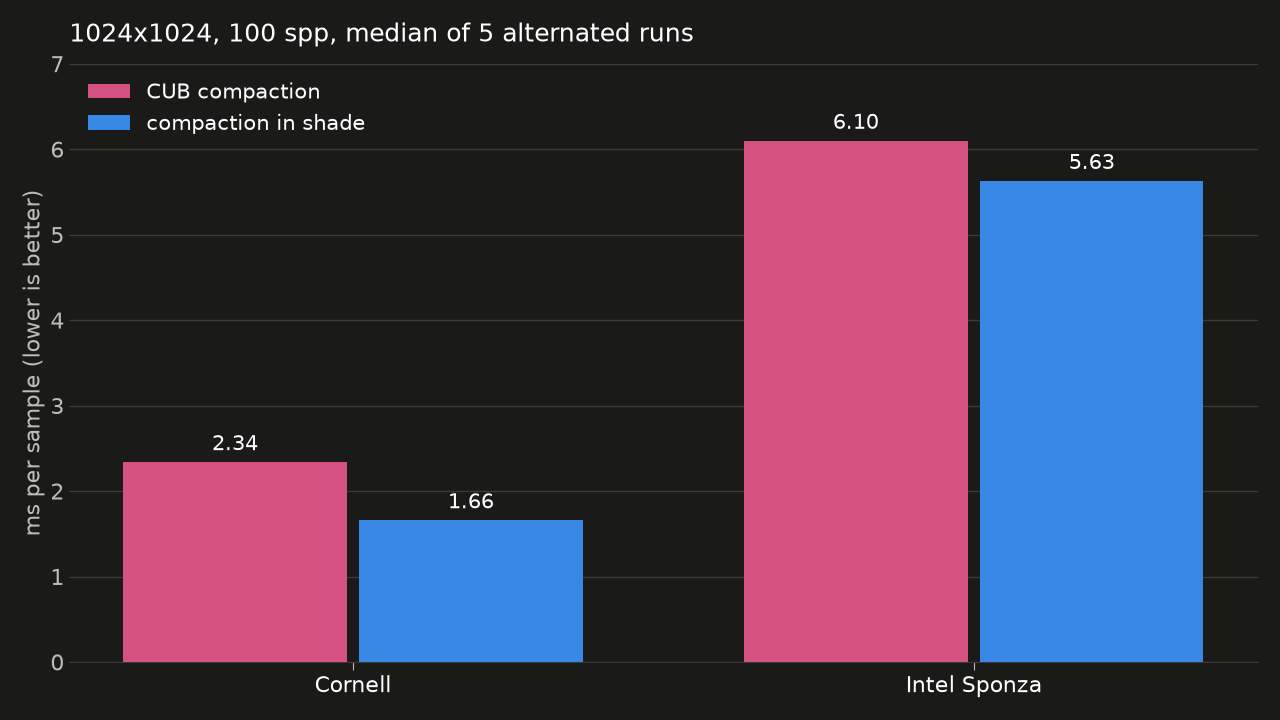
- コンパクションカーネル:消滅、0.49 ms 削減。
shadeMaterial:0.67 から 0.54 ms に。生存パスだけを書き込むようになったため(バウンス 1〜3 の時点でパスの 18〜50% が終了していた)。バイト数だけで見れば約 0.05 ms 分のはずで、残りがどこから来ているのかは調べていない。- アイドル時間:0.10 ms 減少。コンパクションカーネルとともになくなった起動間の隙間の分。
生存パス数を毎バウンス読み戻す代わりに GPU 上に保持しても、改善は Cornell で 0.07 ms、Intel Sponza で 0.1〜0.2 ms にとどまった。その代償として GPU より先にサンプル丸ごとをキューに積むことになり、バウンスごとのエラーチェックも失うので、採用しなかった。
バウンスごとの生存パス
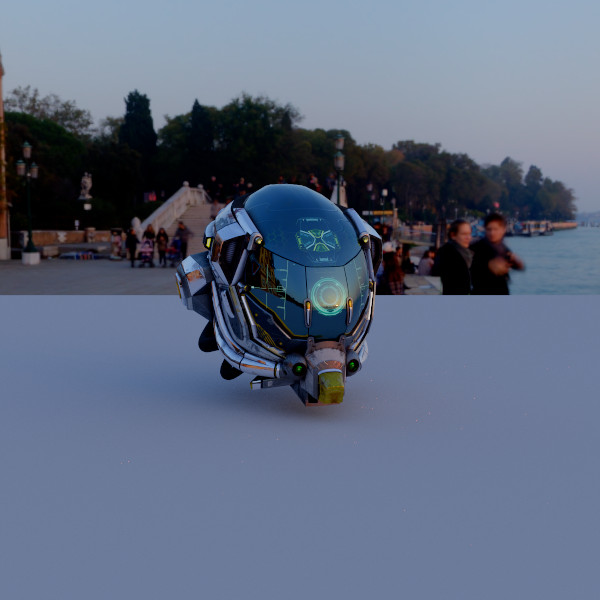
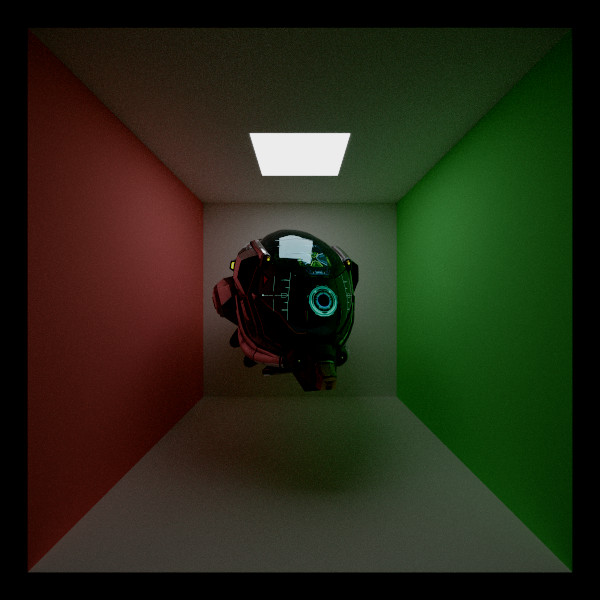
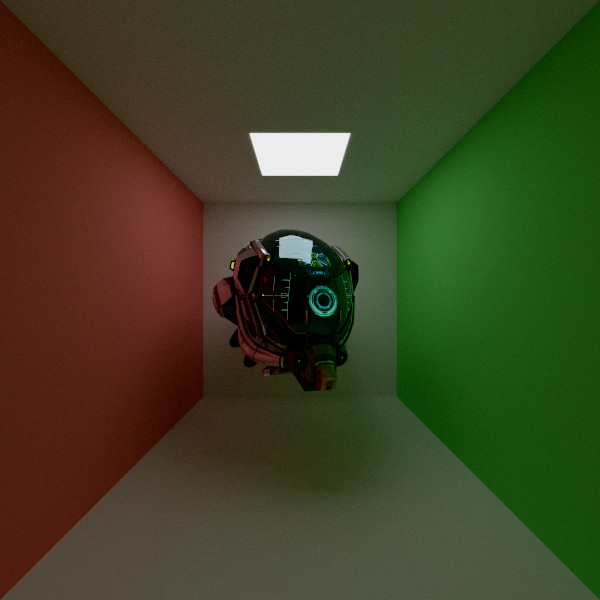
同じ DamagedHelmet を使い、開いたものから閉じたものまで 3 つのシーンを用意した(1024x1024、DEPTH 8):HDRI 下の平面に置いたヘルメット(helmet_plane.json)、前面が開いた標準の Cornell ボックス(cornell_helmet.json)、そしてカメラの後ろに 6 枚目の壁を置いた閉じたボックス(cornell_closed.json)。閉じたボックスでは、パスが終了するのはライトに当たったとき、ロシアンルーレット、または DEPTH に達したときだけだ。
| 平面上のヘルメット | Cornell ボックス、前面開放 | 閉じた Cornell ボックス |
|---|---|---|
 |  |  |
各バウンス開始時の生存パス(--timing より):
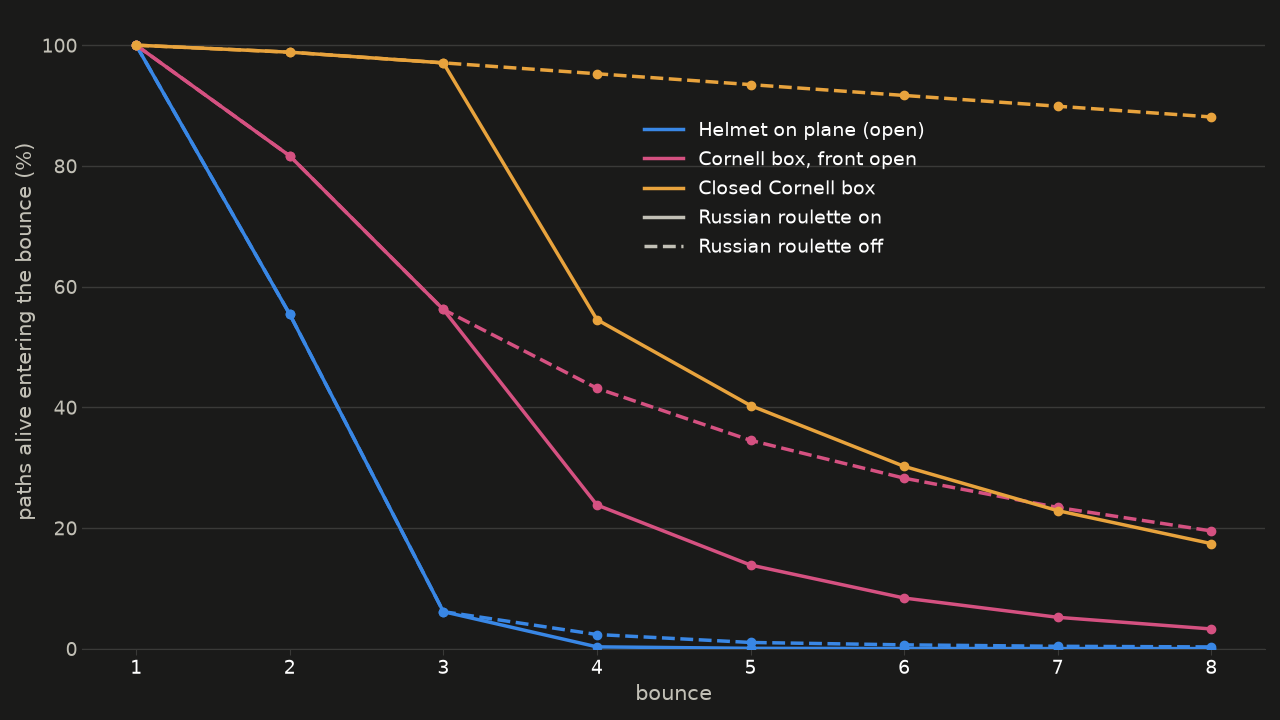
- 平面上のヘルメット:最初のバウンスでパスの 44.6% が空を見ており、平面で跳ね返ったレイもほとんどが空へ向かうので、バウンス 3 までに残るのは 6.1% だけ。ロシアンルーレットが除去するものはほとんどない。
- Cornell ボックス、前面開放:ロシアンルーレットなしでは、バウンスごとにパスの約 5 分の 1 が開いた前面から抜けるかライトに当たって終了する。ありの場合、残りの 58% がバウンス 3 で終了し、その後はバウンスごとに約 40%。
- 閉じた Cornell ボックス:バウンスごとに終了するのは 1〜2% だけで、ロシアンルーレットなしではバウンス 8 でも 88% が生存している。
開いたシーンと閉じたシーン
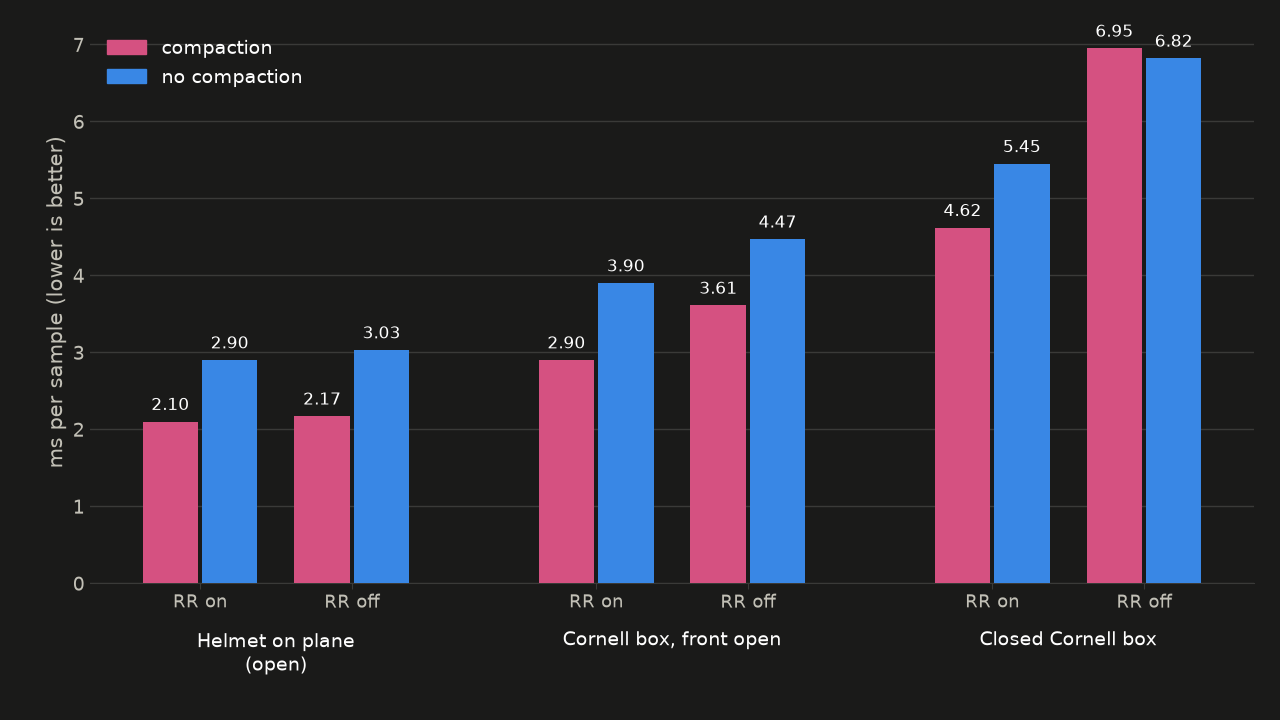
--no-compact でコンパクションをオフにできる:すべてのバウンスで 1,048,576 本すべてのパスに対して起動し、終了したパスではカーネルが早期リターンする。どちらのモードでも同じ画像がレンダリングされる。
ヘッドレス、1024x1024、100 spp、交互に 5 回実行した中央値、1 サンプルあたりの ms:
ロシアンルーレットありのバウンスごとの時間、--timing 5 回実行の中央値:
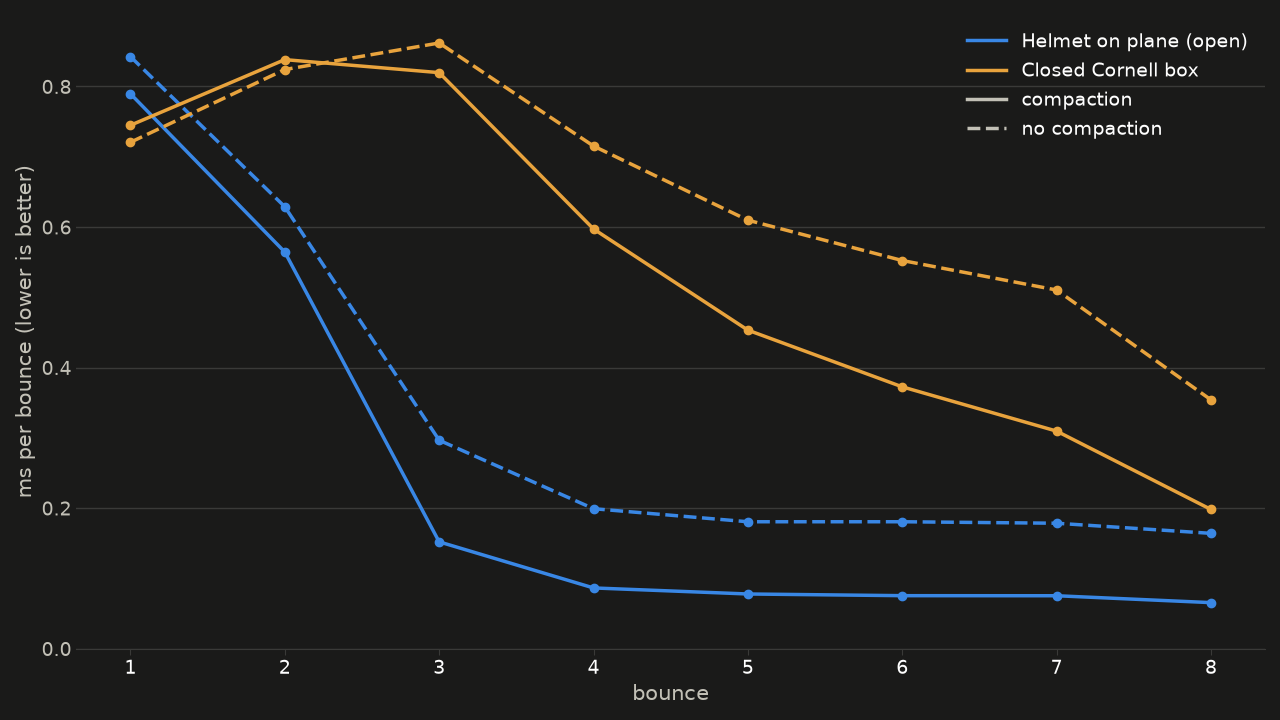
- 開いたシーン:コンパクションにより helmet plane で 28%、開いた Cornell ボックスで 26% 削減。ほとんどのパスが消えた後、コンパクションされたバウンスのコストは約 0.08 ms(起動と生存数の読み戻し)で、スレッドが自分のパスを読み込んでリターンするだけのフル幅の起動では約 0.18 ms かかる。
- 閉じたボックス:コンパクションによる削減は 15% で、ロシアンルーレットが除去する分にとどまる。ルーレットなしでは 2% 遅くなる。ほとんど何も除去しないのに、warp の投票とアトミックのコストは払うからだ。
- ロシアンルーレット:閉じたボックスで 34%、helmet plane で 3% 削減。後者ではルーレットの判定に至るまで生き残るパスが少ない。
- バウンス 2 はバウンス 1 よりコストが高い(ほぼすべてのパスが生存している閉じたボックスの場合):カメラレイは隣り合った方向に出ていくが、拡散バウンスのレイはそうではないので、トラバーサルのコヒーレンスが下がる。
ロシアンルーレット
3 回目のバウンスから、パスはスループットの輝度(最大 0.95)に等しい確率で生き残り、生き残ったパスのスループットはその確率で割られる。これで推定は不偏のまま保たれる。--no-rr でオフにできる。
ヘッドレス、交互に 3 回実行した中央値、1 サンプルあたりの ms。
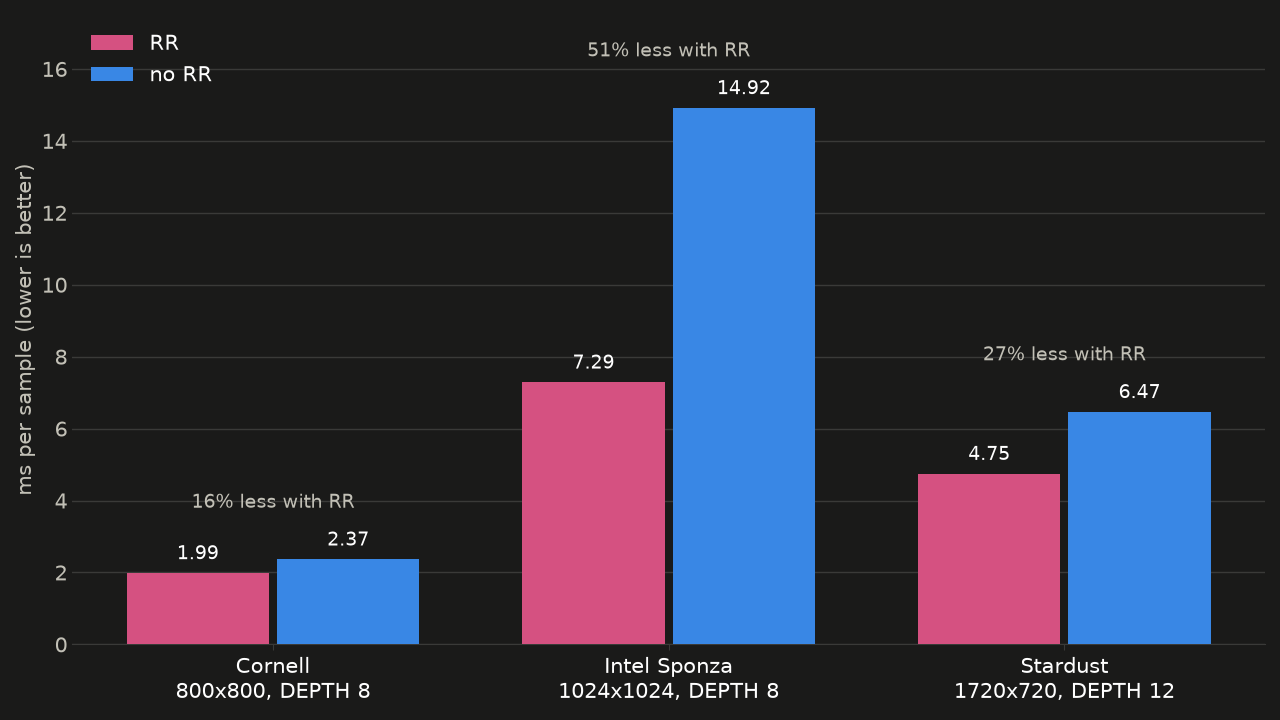
- 3 回目のバウンスで終了したパス:Sponza では RR ありで 96%、なしで 17%。暗い石材で 2 回跳ね返ると、パスのスループットは数パーセントしか残らないので、ほとんどのパスがルーレットに負ける。
- ノイズ:512x512、256 spp で、RR なしの 8192 spp レンダリングに対する RMSE は Sponza で 11.12 vs 10.81(255 段階中)、Cornell で 4.94 vs 4.23。時間あたりで見ると、RR の効率は Sponza で約 1.6 倍だが、Cornell では約 0.85 倍にとどまる。Cornell の白い壁のせいで、RR が終了させるパスにはスループットが多く残っており、RR が加える分散が 16% の時間削減を上回るのだと推測している。
マテリアルソート
--sort はパスをヒットしたマテリアルで基数ソートし、シェーディングの前にその順序へギャザーする。これにより shadeMaterial の warp 内のスレッドが同じマテリアルを読むようになる。性能が悪化するのでデフォルトではオフ。
ヘッドレス、1024x1024(Stardust は 1720x720)、100 spp、バーごとに --timing を 1 回実行したステージ別の 1 サンプルあたりの ms:
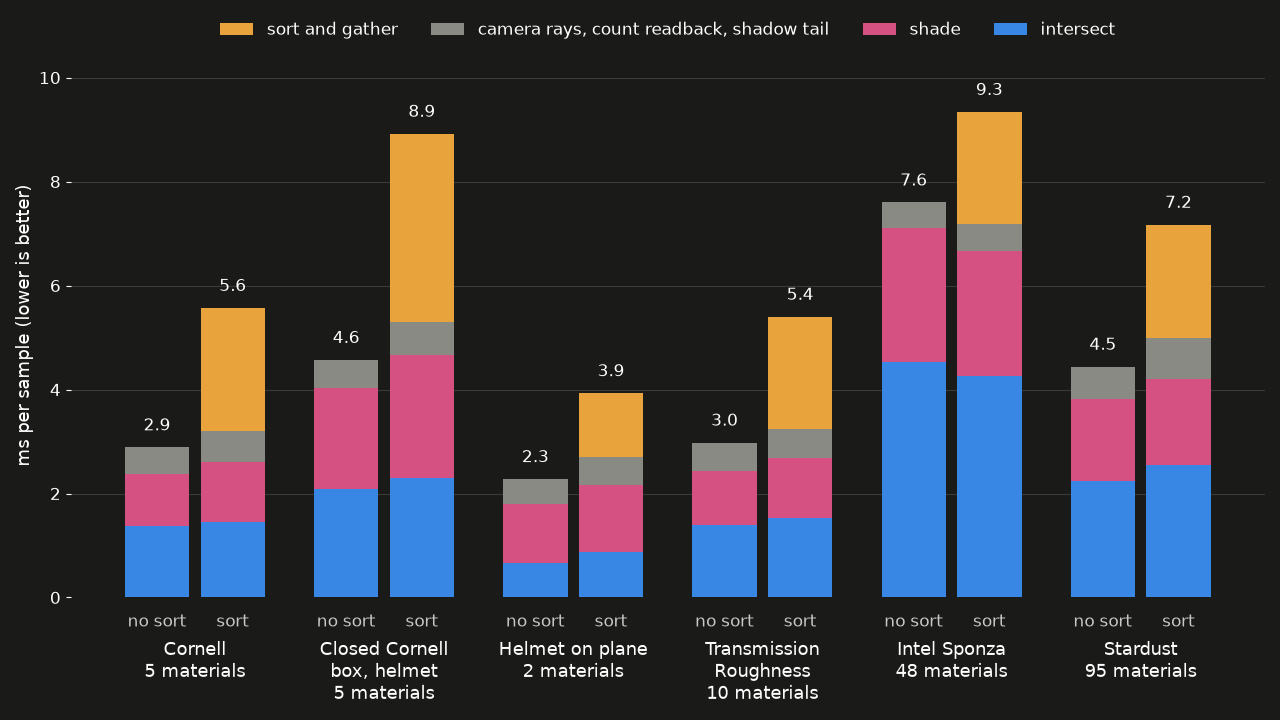
ソートを有効にするとどのシーンも 1.2 倍(Sponza)から 1.9 倍(Cornell)遅くなり、その増加分はすべてソートステージだ。shadeMaterial 自体の変化は最大 0.45 ms で、速くなるのはマテリアルが 48 個ある Sponza だけ。マテリアルが数個しかないシーンはわずかに遅くなる。すべてのマテリアルは同じ scatterPbr を通り、パスがどのローブをサンプリングするかはソートの有無にかかわらずパスごとのランダムな選択なので、マテリアルがいくつあってもソートで取り除ける分岐(divergence)はほとんどない。Sponza がわずかに速くなるのは、ソートされた warp が同じテクスチャをフェッチするからだと推測しているが、プロファイルはしていない。
なぜソートはこんなに遅いのか???
glm 0.9.6 ビルドの gatherByIndex カーネルを Nsight Compute の warp ストールサンプリングで調べると、SASS から、コンパイラがすべての pathsOut[i] = pathsIn[src] を 3 組のロードとストアに変換し、各ストアが対応するロードに依存していることがわかる。
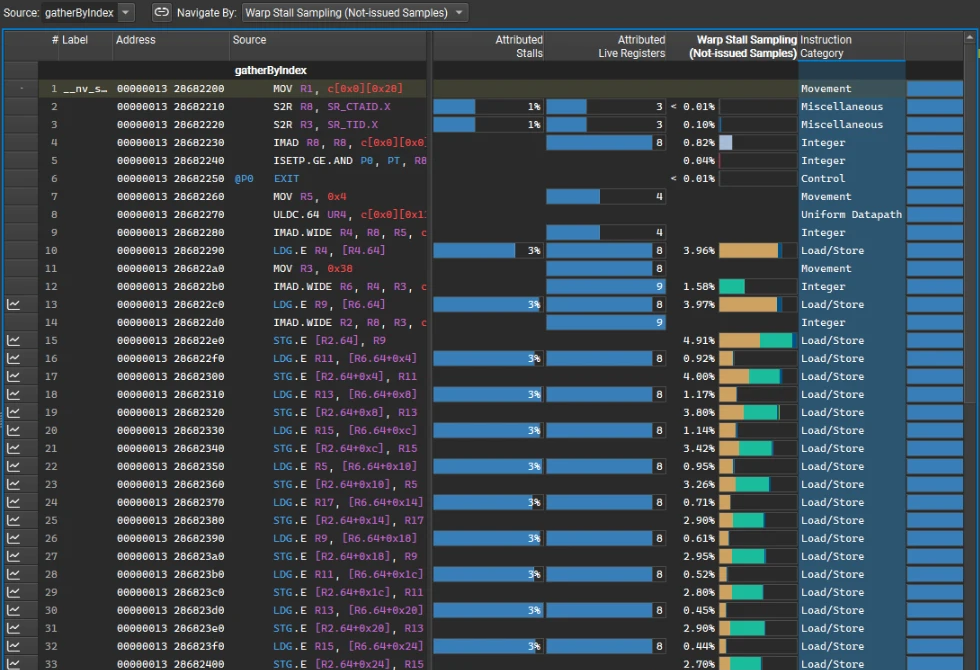
原因は、ベースコードの glm 0.9.6 がベクトルの operator= を手書きしていることだ。そのせいで glm::vec3 を持つすべての構造体がトリビアルコピー可能(trivially copyable)でなくなる。さらにコンパイラは 2 つの PathSegment* ポインタが重なっているかどうかを知らないので、ロードとストアを並べ替えられず、元の順序を守るしかない。
Nsight Compute のデータ、gatherByIndex カーネル、glm アップグレード前後。
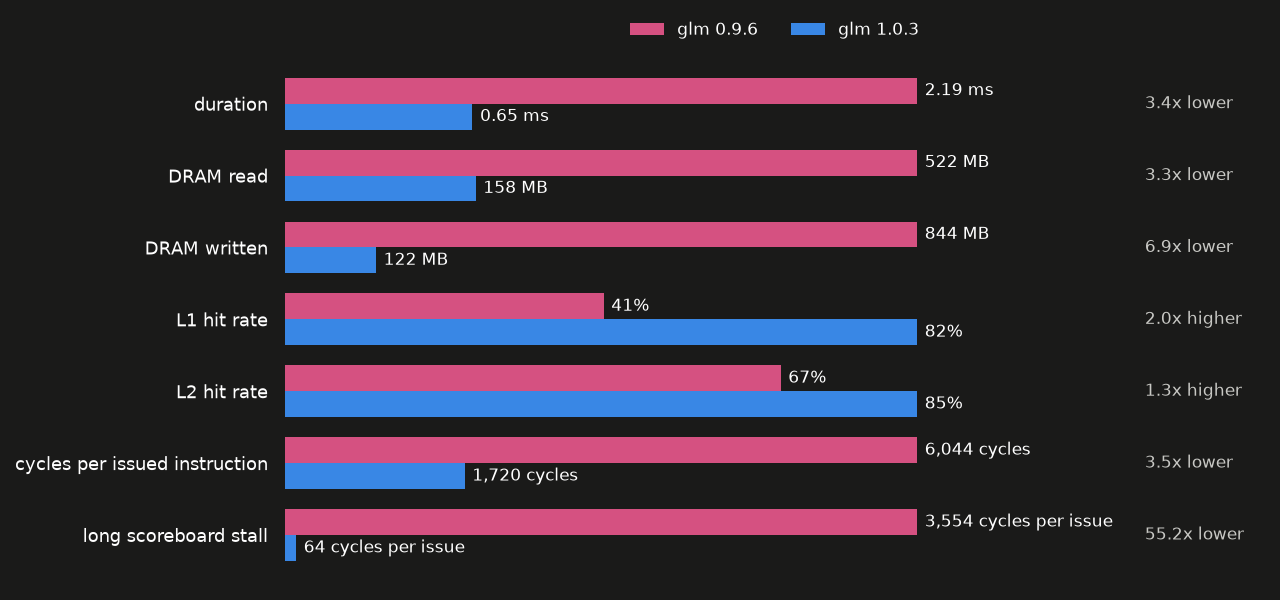
glm を 1.0.3 にアップグレードすると、operator= が = default なので構造体は再びトリビアルコピー可能になり、ギャザーは 29 個のロードに続いて 29 個のストアというコードにコンパイルされる(古い glm でもポインタに __restrict__ を付ければ同じコードになる)。カーネルの隣に static_assert を置いて、この状態が保たれるようにしている。
ヘッドレス、1024x1024(Stardust は 1720x720)、100 spp、バーごとに --timing を 1 回実行した 1 サンプルあたりのソートステージ時間:
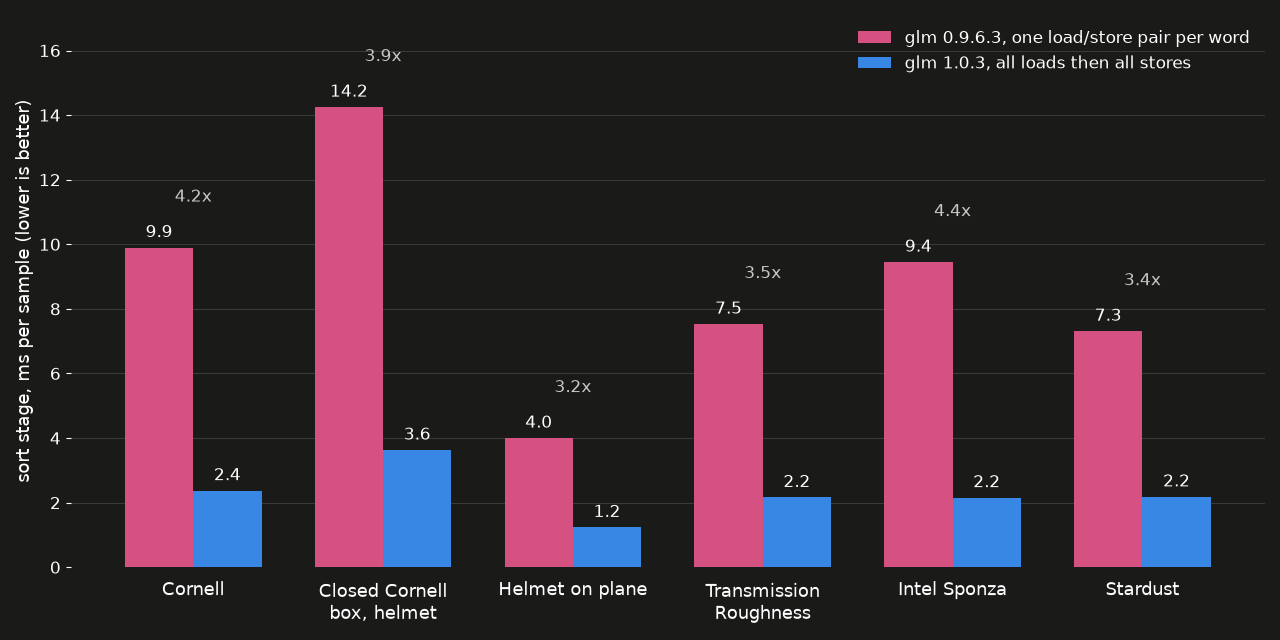
残っているのは移動そのもののコストだ。ソート後、warp の 32 レーンは互いに少なくとも 56 バイト離れた 32 個の構造体を読むので、各ロードは有用な 128 バイトのために 32 セクタに触れることになり、連続コピーの約 3 倍のコストがかかる。これはシェードカーネルが得る分より大きいので、ソートはオフのままにしている。
ソートがここで勝てない理由
ソートが取り戻せる性能には 2 つの上限がある。
- ソートにできるのはシェードステージの分岐を取り除くことだけだが、ソートのコストは文字通りシェーディングそのものより高い。分岐を完全に取り除けたとしても元は取れない。
- warp が分岐する原因は
materialIDではない。shadeMaterialはミスかヒットかで分岐するが、ミスはどのみち 1 ステージ後にコンパクションで取り除かれる。そしてscatterPbrの中では、どのローブ(クリアコート、金属、ガラスなど)をサンプリングするかで warp が分岐する。これらの選択はすべて乱数とマテリアルパラメータの比較で決まる。roughness 0、metallic 1 のような混合のないマテリアルでも、specularFactorがフレネル比率でクリアコートと拡散ベースを混合するので、やはり分岐が生じる。
materialID によるソートで得をするのはテクスチャサンプリングで、Sponza や Stardust のようなテクスチャの多いシーンがシェーディングでわずかに性能を取り戻すのはおそらくこのためだ。
マテリアル評価がよほど複雑にならない限り(Blender の複雑なシェーディンググラフのように)、このパストレーサーでマテリアルソートが割に合うことはないと思う。
途中で遭遇した問題と失敗
単一の選択テーブルによるライトリンクでキャラクターに斑点が出た
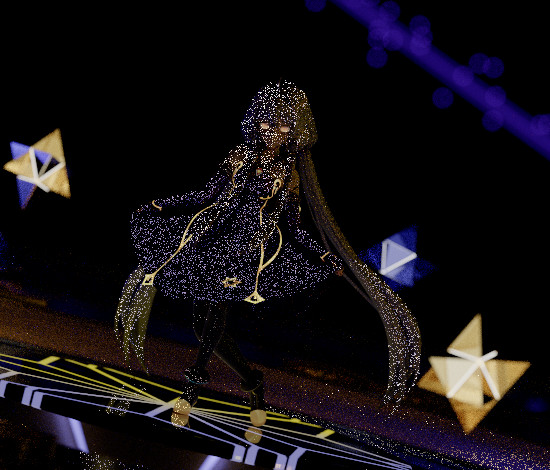
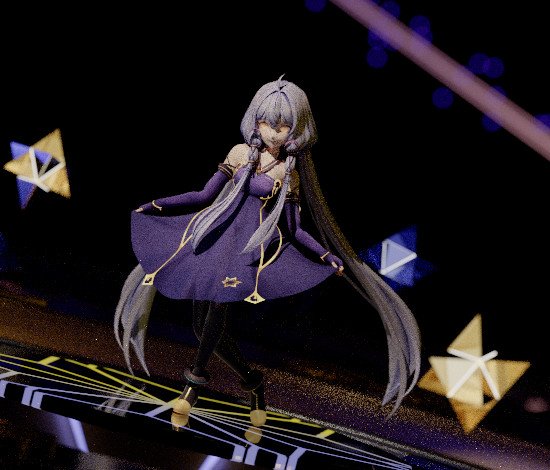
最初のライトリンク実装では、グローバルな選択テーブルを 1 つのまま使い、レシーバーが選ばれたライトにリンクされていないサンプルを破棄していた。Stardust ではとても明るいライトがキャラクターからリンクで外されていて、キャラクターはずっと暗いスポットライトで照らされているので、キャラクターのライト選択の 99% が破棄されていた。たまにスポットライトが選ばれると、そのサンプルは寄与の全量を非常に小さな確率で割った値を持つので、明るい斑点になる。マスクごとの選択テーブルではキャラクター用のテーブルで明るいライトの確率が 0 になり、同じ 2048 spp のレンダリングがきれいになる。
キャラクターの切り抜きを等倍で、2048 spp:
| グローバルな選択テーブル 1 つ | レシーバーマスクごとにテーブル 1 つ |
|---|---|
 |  |
Sponza の汚れデカールが壁一面に描画された
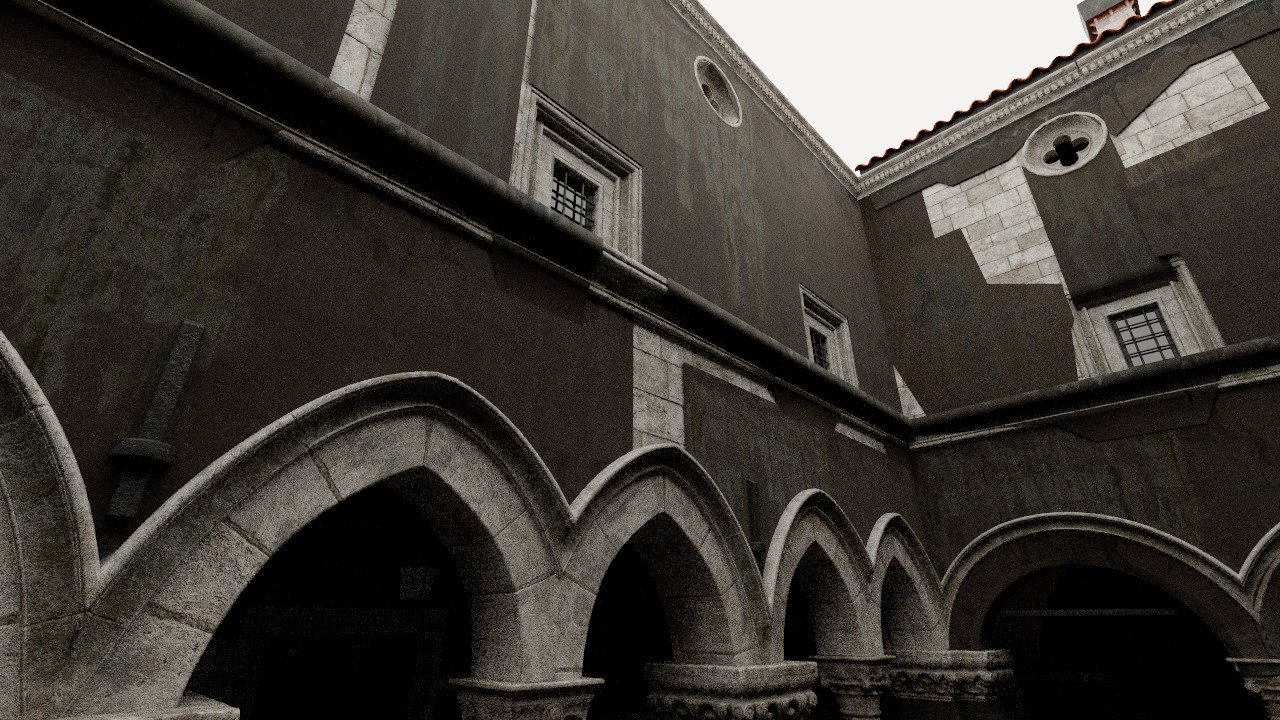
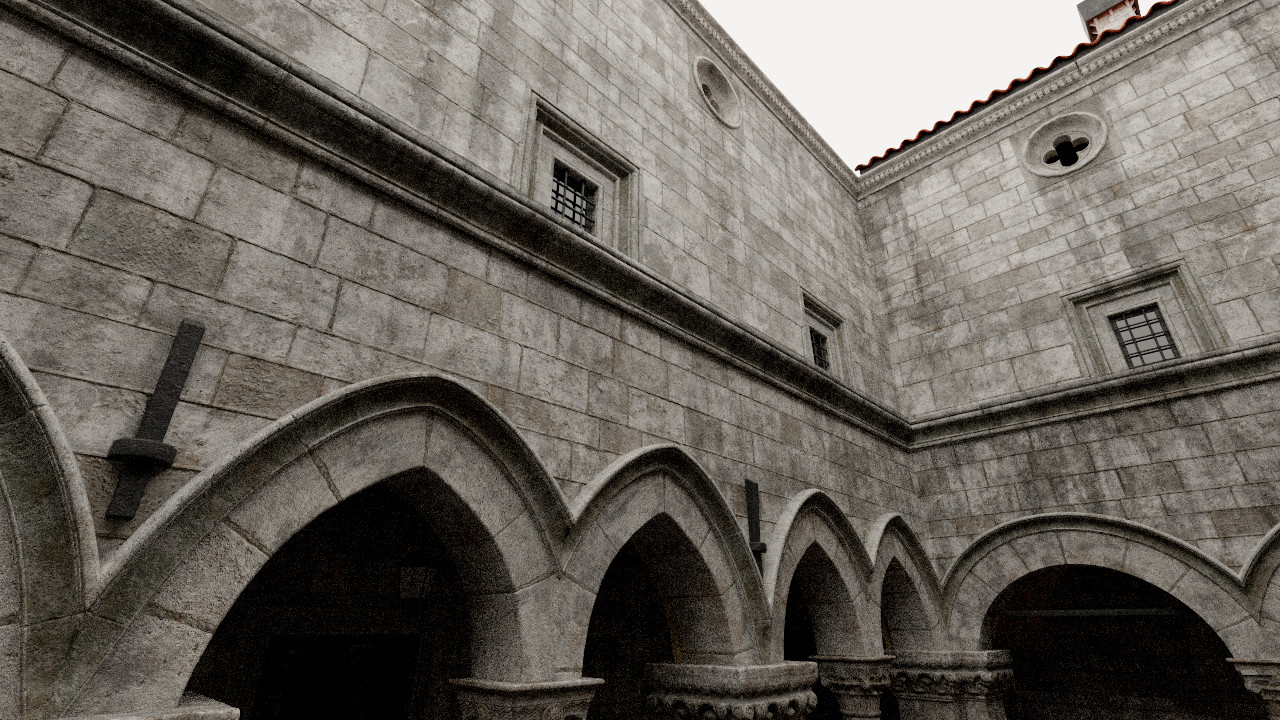
Intel Sponza の壁には alphaMode: BLEND の dirt_decal マテリアルが付いているが、ローダーがそれを不透明として扱っていたため、暗い汚れのテクスチャが壁を覆ってしまった。現在は BLEND のヒットを確率 alpha でカウントしている。その判定はピクセル、イテレーション、深度、三角形のハッシュから求めるので、2 つの交差判定経路が同じ判定を下す。
| BLEND を不透明として扱う | BLEND をカバレッジとして扱う |
|---|---|
 |  |
glm 1.0 がデバイス上でゴミにコンパイルされた
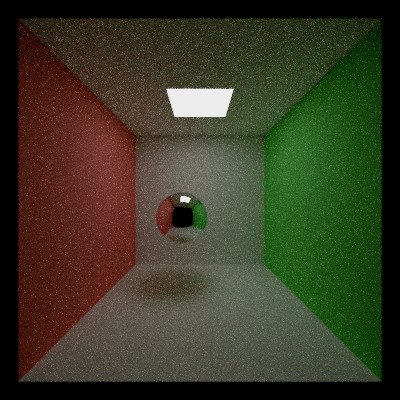
glm 1.0.3 での最初のビルド(アップグレードした理由)では、どちらの交差判定経路でもすべてのシーンが真っ黒になり、すべてのパスが最初のバウンスで終了した。glm 1.0 はベクトル演算を std::plus、std::multiplies などの constexpr ホスト関数経由で行うが、nvcc 13.3 は --expt-relaxed-constexpr を指定しない限りデバイスコードからそれらを呼び出さない。エラーを出す代わりにインスタンス化ごとに warning #20013 を出力し、呼び出しを何もしないコードにコンパイルする。GPU 上では glm::vec3(1, 2, 3) * 2.f が (1, 2, 0) に、glm::dot が NaN になったので、すべてのカメラレイがミスした。現在はこのフラグを OptiX IR 用も含むすべての nvcc コマンドに付けている。アップグレード後のレンダリングと以前のものとの差は浮動小数点のずれだけ:1 カウントずれた単発のピクセルと、最後のビットで分岐が反転したせいで位置が変わった数個のファイアフライだ。
| フラグなしの glm 1.0.3 | --expt-relaxed-constexpr あり |
|---|---|
 |  |
Schlick 近似が出射時に誤ったコサインを使っていた
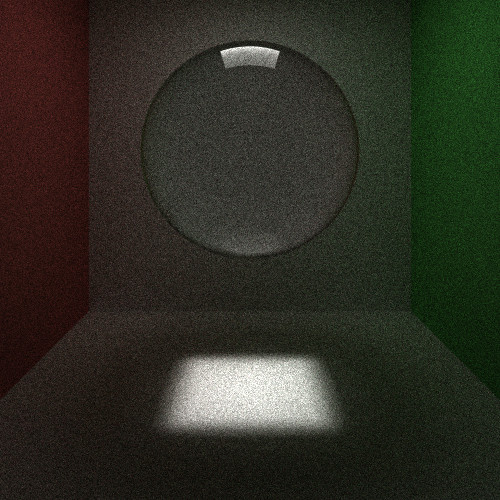
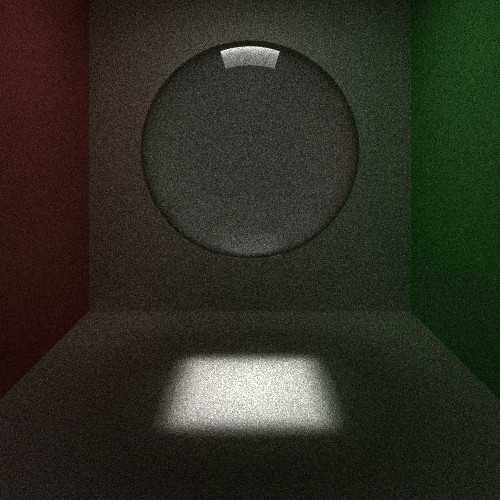
Schlick 近似には境界面の空気側のコサインが必要で、ガラスから出ていくレイの場合それは透過角になる。ベースコードは入射角のほうを使っていたので、反射率が臨界角(IOR 1.5 で約 42°)ではなく 90° になるまで 100% に達せず、臨界角をわずかに下回る出射レイが内部に反射されずに外へ漏れていた。修正では透過角のコサインを使い、k < 0 を全反射として扱う。
1000x1000、500 spp、DEPTH 8、球の部分を切り抜き:
| 修正前 | 修正後 |
|---|---|
 |  |
ピクセル差分を 8 倍に増幅:
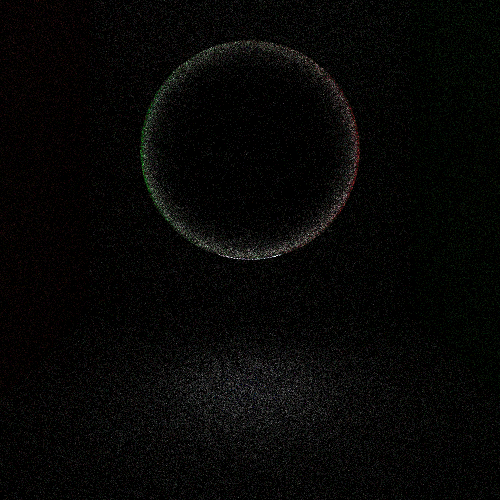
修正後の画像は縁がわずかに暗い。その光が内部でより多くのバウンスを重ねるようになり、深度 8 ではそのうち一部のパスが上限に達するからだ。興味深いことに、DEPTH を 32 に上げると球はかなり明るくなり、その差はこのバグの影響よりはるかに大きい。つまりガラスには拡散面よりずっと大きな深度が必要だということだ。
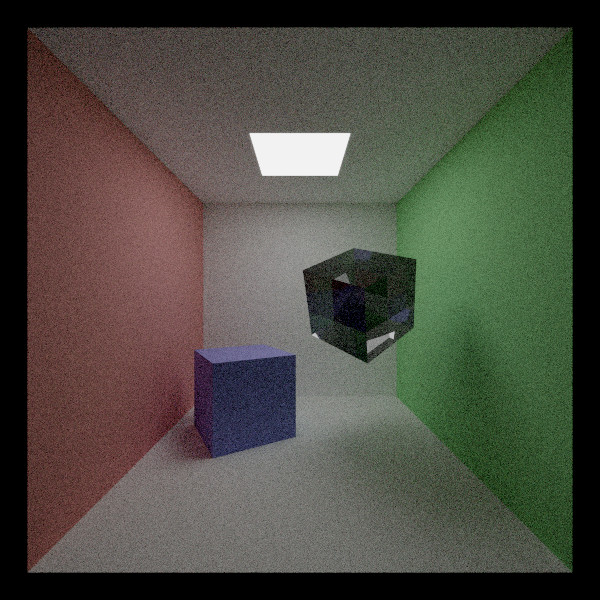
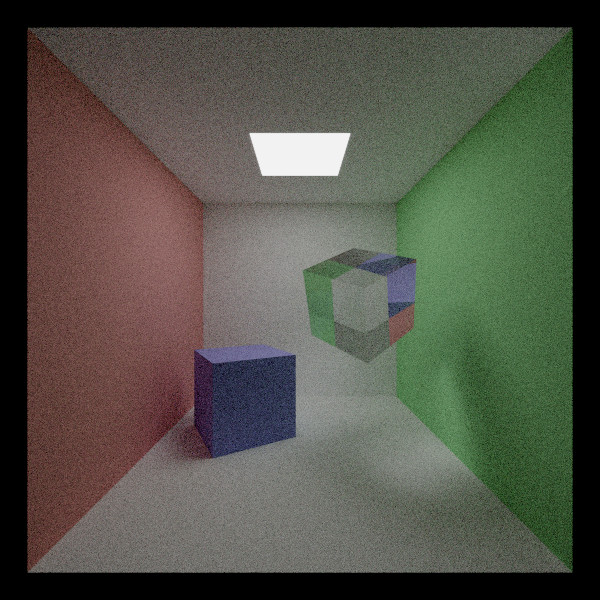
OptiX の立方体が出射ヒットで外向き法線を返していた
OptiX の立方体のヒットプログラムは出射ヒットで面の外向き法線を返していたが、ナイーブな boxIntersectionTest はレイに向いた法線を返す。Cornell には立方体の内部から始まるレイがないので、OptiX でガラスの立方体が暗く描画されて初めて発覚した。内側の分岐で符号を 1 つ反転するだけで直った。
600x600、1000 spp、DEPTH 8、AgX、OptiX:
| 出射時に外向き法線 | レイに向いた法線 |
|---|---|
 |  |
ベースコードの細かな修正
- カメラを動かすたびにすべてのデバイスバッファを解放・再確保していた。 現在はバッファを一度だけ確保し、カメラが変わったら画像をクリアする。
- S キーでいつでも保存できるよう、蓄積バッファを毎イテレーションホストにコピーしていた。 現在はコピーを保存処理の中で行う。
- CUDA エラー時に終了前に
getchar()で待っていたため、ヘッドレス実行がハングしていた。削除した。
クレジット
テストアセット
| モデル | 三角形数 | クレジット |
|---|---|---|
| Box | 12 | Cesium, 2017, CC BY 4.0 |
| Duck | 4,212 | Sony, 2006, SCEA Shared Source License 1.0 |
| Suzanne | 3,936 | Norbert Nopper / UX3D, 2017, CC0 |
| DamagedHelmet | 15,452 | theblueturtle_, 2016, CC BY-NC 4.0;glTF 再構築:ctxwing, 2018, CC BY 4.0 |
| Sponza | 262,267 | Crytek (Frank Meinl), CryENGINE Limited License Agreement、glTF 変換は Khronos リポジトリより |
| TransmissionRoughnessTest | 77,792 | Ed Mackey, Analytical Graphics, 2021, CC BY 4.0 |
| DragonAttenuation | 134,995 | ドラゴン:Stanford Computer Graphics Laboratory, 1996、Morgan McGuire による変換, 2017, Stanford Graphics Library license;布の背景:Adobe, CC0 |
| ClearCoatTest | 37,116 | Ed Mackey, Analytical Graphics, 2020, CC BY 4.0 |
| Intel Sponza(本体とカーテン) | 3,747,018 + 1,997,366 | Frank Meinl and Anton Kaplanyan, Intel, 2022, CC BY 4.0;カーテンアドオン:Sponza Addon Package Crew |
| Bistro exterior | 2,829,226 | Amazon Lumberyard, July 2017, CC BY 4.0 |
| Bistro interior | 1,043,077 | Amazon Lumberyard, July 2017, CC BY 4.0 |
モデルの出典:Khronos glTF-Sample-Assets、Intel Sample Library、NVIDIA’s Open Research Content Archive。
サードパーティコード
tinygltf 2.9.7(MIT)、MikkTSpace(zlib)、tinyexr 1.0.13(BSD-3-Clause)、OptiX 9.1.0、stb_image 2.30、CUDA 13.3 付属の Thrust と CUB、glm 1.0.3。GLFW、GLEW、nlohmann/json、Dear ImGui、stb_image_write はベースコードに含まれていたもの。
参考文献
- Veach 1997:Eric Veach, Robust Monte Carlo Methods for Light Transport Simulation, 博士論文, Stanford University, 1997.
- Walter et al. 2007:Bruce Walter, Stephen R. Marschner, Hongsong Li, Kenneth E. Torrance, “Microfacet Models for Refraction through Rough Surfaces”, Eurographics Symposium on Rendering 2007.
- Dupuy and Benyoub 2023:Jonathan Dupuy, Anis Benyoub, “Sampling Visible GGX Normals with Spherical Caps”, High-Performance Graphics 2023.
- Karlík et al. 2019:Ondřej Karlík, Martin Šik, Petr Vévoda, Tomáš Skřivan, Jaroslav Křivánek, “MIS Compensation: Optimizing Sampling Techniques in Multiple Importance Sampling”, ACM Transactions on Graphics 38(6), SIGGRAPH Asia 2019.
- PBRT-v4:Matt Pharr, Wenzel Jakob, Greg Humphreys, Physically Based Rendering: From Theory to Implementation, 第 4 版, MIT Press 2023.
使用ツール
CUDA, OptiX, C++, OpenGL, GLFW, Dear ImGui, CUB, CMake